Vous voudriez apprendre à programmer mais ne savez pas par où commencer ? Vous avez commencé à apprendre le C mais vous vous embrouillez dans les accolades et autres symboles bizarroïdes ? Ou encore vous souhaitez apprendre un nouveau langage de programmation ? Alors ce tutoriel est fait pour vous.
Le langage Ada est certainement le meilleur langage pour apprendre à programmer : pour peu que vous connaissiez deux ou trois mots d'anglais, il vous sera facile de lire un code en Ada. Moins abstrait que beaucoup de langages, mais toutefois rigoureux, facilement compréhensible et lisible, même par un novice ... le langage Ada vous permettra de comprendre les logiques propres à la programmation et vous donnera tout de suite de bonnes habitudes.
Qui plus est, le langage Ada ne présente ni plus ni moins de fonctionnalités que les langages les plus connus (C, C++, Java, Python...). Il est seulement différent et, je me répète, plus compréhensible pour un novice.
Alors si vous êtes intéressé, nous allons pouvoir débuter de tutoriel. ;)
Ce tutoriel est prévu pour être organisé en six parties :
La partie I constitue une introduction à la programmation et vous accompagne dans votre première prise en main d'Ada.
Les parties II, III et IV traitent (ou traiteront) du langage Ada en lui-même et présenteront une difficulté progressive.
La partie V constituera une mise en pratique en vous proposant de créer des programmes fenêtrés avec GTK et Ada.
La partie VI fournira les annexes à ce tutoriel : FAQ, Glossaire, présentation de librairies tierces ...
Le cours sera ponctué de travaux pratiques. Ce sont des chapitres vous proposant un projet (parfois ludique) allant du logiciel de gestion de vos DVD à des jeux de dés. Ils seront pour vous l'occasion de mettre en application vos connaissances acquises. Ces travaux pratiques sont signalés dans leur titre par la notation [TP#] (le symbole # étant remplacé par le numéro du TP). De plus, ils portent tous l'icône :
Nous allons dans ce chapitre répondre à quelques questions préliminaires. Qu'est-ce qu'un programme ? A quoi cela ressemble-t-il ? Comment crée-t-on un programme ? Qu'est-ce que l'algorithmique ? Pourquoi Ada et pas un autre langage ? Ce que j'apprends ici sera-t-il utilisable avec un autre langage ?
Bref, beaucoup de réponses existentielles trouveront (je l'espère) leur réponse ici. Ce chapitre, relativement court et sans difficultés, permettra de poser un certain nombre d'idées et de termes. Pour bien commencer, mieux vaut en effet que nous ayons le même vocabulaire. ;)
A ceux qui auraient déjà des notions de programmation, vous pouvez bien entendu éviter ce chapitre quoique je ne saurais trop vous conseiller d'y jeter un œil, histoire de remettre quelques idées au clair.
Avant de commencer, il est important que nous nous entendions sur les termes que nous allons utiliser.
Qu'appelle-t-on programme ?
Les programmes sont des fichiers informatiques particuliers. Sous Windows, ce sont généralement des fichiers se terminant par l'extension .exe ; sous MacOS ce sont globalement des fichiers .app ; sous Linux ce sont schématiquement des fichiers .bin. Cette explication est très (TRÈS) schématique, car d'autres types de fichiers peuvent correspondre à des programmes.
Ces fichiers ont comme particularité de ne pas seulement contenir des données, mais également des instructions. Lorsque vous ouvrez un fichier .exe sous windows, celui-ci transmet à votre ordinateur une liste de choses à faire comme :
ouvrir une fenêtre
afficher du texte
effectuer des opérations
...
Cette liste d'instructions envoyées au processeur, forme alors ce que l'on appelle un processus.
Voici quelques images de programmes :
Attention, tous les programmes ne sont pas nécessairement visibles. Beaucoup n'ouvrent même pas de fenêtre ! Pour s'en rendre compte, sous Windows, appuyez simultanément sur les touches Alt + Ctrl + Suppr puis cliquez sur le second onglet, cela affichera la liste de tous les processus en cours.
Bon nombre d'entre eux effectuent des tâches tranquillement sans que vous ne vous en rendiez compte.
Alors qu'allons-nous faire ?
Eh bien, programmer (en Ada ou autre) c'est tout simplement créer des programmes. Mais je vous arrête tout de suite, malgré tout le talent de votre humble guide, :p vous ne confectionnerez pas un jeu vidéo en 3D d'ici la fin de ce tutoriel. La plupart des logiciels, comme le navigateur internet que vous utilisez actuellement, exigent la participation de nombreuses personnes et de nombreuses autres compétences ne relevant pas de ce cours (modélisation 3D par exemple).
Les premiers programmes que nous allons concevoir seront des programmes en console. C'est à dire qu'ils ressembleront à ce qui suit :
Nous ne pourrons utiliser que le clavier ! Pas de souris ou de joystick ! Pas d'images ou de vidéos ! Pas de 3D puisqu'il n'y aura même pas de 2D ! Que tu texte blanc sur fond noir.
:waw: Aaargh ! Mais, c'est possible ?
Bon, c'est vrai qu'aujourd'hui on a tendance à oublier la console, mais il est nécessaire de passer par ce stade pour apprendre les bases de la programmation. Nous pourrons ensuite nous atteler à des programmes plus conséquents (avec des boutons, des images, la possibilité d'utiliser la souris ... ). Il faudra être patient ;)
Alors comment faire pour créer votre propre programme ? Il faut avant tout savoir comment est constitué un programme (ou tout autre type de fichier). Vous le savez peut-être déjà, mais un ordinateur a un langage très très basique. Il ne connaît que deux chiffres : 1 et 0 ! Donc tout fichier (et donc tout programme) ne peut ressembler qu'à ceci :
10001001111010110110111011011 ...
Ca rappelle Matrix ! :lol: Mais comment je fais moi ? J'y comprends rien moi à tous ces chiffres ? Il faut faire Math sup pour afficher une fenêtre ?
Non, rassurez-vous. Personne n'est capable de créer un programme informatique ainsi. C'est pourquoi ont été inventés différents langages pour la programmation : le Pascal, le Basic, le C, le C++, le Python, le Java ... et bien sûr l'Ada. Ce sont ce que l'on appelle des langages de haut niveau. A quoi cela ressemble-t-il ? voyez vous-même :
with Ada.Text_IO, Ada.Integer_Text_IO ;
use Ada.Text_IO, Ada.Integer_Text_IO ;
procedure exemple is
n : integer ;
begin
loop
Put("Saisir un nombre : ") ;
Get(n) ; Skip_line ;
if n mod 2 = 0
then Put("Ce nombre est pair ! Tres bien !") ; exit ;
else Put("Ce nombre est impair ! Recommencez. ") ;
end if ;
end loop ;
end exemple ;
Vous serez capables d'ici quelques chapitres de comprendre ce texte aisément. C'est comme apprendre une langue étrangère ; d'ailleurs si vous connaissez l'Anglais vous avez peut-être reconnu quelques mots (end, if, else, then, begin, is). C'est ainsi que nous créerons nos programmes.
Et comment on traduit ça en 1 et en 0 ?
Une fois notre texte rédigé en Ada (mais c'est aussi valable pour les autres langages), il faudra utiliser un programme-traducteur pour le convertir en un programme lisible par l'ordinateur. Les programmes-traducteurs sont appelés compilateurs.
Il ne vous reste donc plus qu'à apprendre un langage de programmation, et avec ce langage, vous apprendrez également ce que l'on appelle l'algorithmique.
Qu'est-ce que c'est encore que ça ?
L'algorithmique est une branche des mathématiques qui traite de la résolution de problèmes à l'aide d'instructions simples. J'en vois déjà certains qui paniquent à la vue du mot "Mathématiques", mais n'ayez crainte vous avez déjà vu plusieurs fois dans votre vie des algorithmes. Par exemple, comment faire pour diviser 742 par 5 ? Vous vous souvenez, c'était en primaire ? Vous aviez appris à poser l'opération comme ci-dessous et à répéter les instructions suivantes :
Dans 7, combien de fois 5 ?
Il y va 1 fois et il reste 2 !
On abaisse le 4 derrières le reste. Dans 24, combien de fois 5 ? Il y va 4 fois et il reste 4.
On abaisse le 2 derrières le reste. Dans 42, combien de fois 5 ? Il y va 8 fois et il reste 2.
Il n'y a plus de chiffre à abaisser. On arrête : le résultat est 148 et il reste 2 !.
Eh bien ça, c'était un algorithme : vous répétiez des instructions simples dans un certain ordre (abaisser les chiffres de 742, se demander "dans machin, combien de fois truc ?"...) afin de résoudre un problème plus compliqué (combien vaut ?). Et tout programme informatique n'est en fait qu'un algorithme écrit dans un langage compréhensible par votre ordinateur. Donc apprendre à programmer, c'est en fait apprendre la science de l'algorithmique dans un langage informatique donné.
Pourquoi Ada ?
Mais alors, pourquoi apprendre l'Ada et pas simplement l'algorithmique ? Et pourquoi l'Ada et pas un autre langage ?
Tout d'abord, l'algorithmique n'est pas compréhensible par les ordinateurs, je vous rappelle que c'est une science. L'algorithme de la division euclidienne vu au-dessus est expliqué en Français, or je vous ai dit qu'il doit être écrit dans un langage qui pourrait être traduit par un compilateur, un langage très structuré et normé (qui ne changera pas en changeant de compilateur), et ça c'est ce qu'on appelle la programmation. Et l'Ada répond à ces exigences.
Maintenant, pourquoi Ada et pas un autre langage ? Il est vrai que l'Ada n'est pas le langage le plus répandu. Mais il présente de nombreux avantage par rapport à d'autres langages plus répandus comme le C, le C++, le Java ...
Tout d'abord il présente un avantage pédagogique. Ada consitue un langage parfait pour apprendre à programmer. D'ailleurs de nombreuses écoles ou universités l'utilisent comme support à leurs cours de programmation. La rigueur qu'il impose au programmeur permet aux débutants d'apprendre à coder correctement, de prendre de bonnes habitudes qu'ils conserveront par la suite, même s'ils venaient à changer de langage de programmation durant leur carrière. Qui plus est, c'est un langage facilement lisible car il utilise des mots complets (begin, end, function, if ... c'est de l'Anglais en effet) plutôt que les symboles "barbares et bizarroïdes" pour un débutant que préfèrent la plupart des langages actuels. Les codes des programmes sont certes moins condensés, mais plus faciles à reprendre en cas de bogue ce qui constitue un avantage non négligeable quand on sait que les coûts de maintenance d'un logiciel sont souvent plus élevés que le coût de son développement.
Ensuite, le langage présente également des avantages pour les professionnels. Son fort typage (vous aurez l'occasion de le découvrir durant la deuxième partie) ou sa très bonne gestion des erreurs (abordé lors de la quatrième partie) garantissent des programmes fiables. Ce n'est pas pour rien qu'Ada est utilisé pour de gros projets comme Ariane, chez Thalès pour ses avions ou radars, ou encore pour la sécurité des centrales nucléaires, du trafic aérien ou ferroviaire ... Utiliser Ada est un gage de fiabilité et pour cause, il a été développé par le département de la défense américain, le fameux DoD (vous vous doutez bien que rien n'a été laissé au hasard ;) ).
Maintenant que ces quelques explications préliminaires sont faites, j'espère que vous vous sentez toujours prêts à vouloir apprendre un langage. Si cela vous semble compliqué, n'ayez crainte, nous commencerons doucement et je vous guiderai pas à pas. Nos premiers programmes seront peut-être inutiles ou ringards, mais nous apprendrons peu à peu de nouvelles notions qui nous permettront de les perfectionner.
Alors, en avant pour l'installation des logiciels nécessaires ! :pirate:
Nous allons au cours de ce chapitre, télécharger et installer les logiciels nécessaires à l'utilisation d'Ada.
Comment ça LES logiciels ? Il n'y a pas un seul logiciel Ada ?
Eh bien non. Comme tout langage, Ada a besoin de deux types de logiciels : un éditeur de texte avancé (appelé IDE) et un compilateur. Nous utiliserons l'IDE appelé Adagide (même si le logiciel GPS pourra être utilisé) et le compilateur GNAT. Après quoi nous pourrons découvrir (enfin) le joyeux monde de la programmation.
Nous avons dors et déjà parlé du compilateur : il s'agit d'un programme qui va traduire notre langage Ada en un vrai programme utilisable par l'ordinateur. Le compilateur est aussi chargé de vérifier la syntaxe de notre code : est-il bien écrit ? Sans fautes d'orthographe ou de grammaire ? Il existe plusieurs compilateurs en Ada, mais rassurez-vous, quel que soit celui que vous choisirez, les règles sur le langage Ada seront toujours les mêmes car Ada est un langage normé (il bénéficie d'une norme internationale assurant que tous les compilateurs Ada respecteront les mêmes règles). Il existe plusieurs compilateurs Ada (vous en trouverez une liste à l'adresse suivante), mais la plupart sont des programmes payants et propriétaires.
Euh ... c'était pas prévu au contrat ça ! o_O
Rassurez-vous, nous allons plutôt opter pour un compilateur libre et gratuit. ;) Ce compilateur s'appelle GNAT et est développé par la société Adacore. Il a longtemps été payant mais une version gratuite existe désormais (GNAT GPL).
L'IDE ou EDI
Mais le compilateur n'est en définitive qu'un "traducteur". Il ne créera pas de programme à votre place, c'est à vous d'écrire les instructions dans des fichiers textes. Pour cela, vous pouvez écrire vos documents sous l'éditeur de texte de votre ordinateur (notepad sous Windows par exemple), ou utiliser un éditeur de texte un peu plus avancé comme Notepad++ qui colorera votre texte intelligemment en reconnaissant le langage dans lequel vous programmerez (on appelle ça la coloration syntaxique).
Mais le plus intelligent est d'utiliser un Environnement de Développement Intégré, EDI en Français ou IDE en Anglais. Pourquoi ? Eh bien parce que ce logiciel vous fournira un éditeur de texte avec coloration syntaxique (waaah... :euh: ) et surtout vous permettra de compiler votre texte aisément, sans avoir à chercher votre compilateur et lui entrer tout plein de paramètres auxquels vous ne comprenez rien. :p Qui plus est, un IDE vous fournira divers outils utiles à la programmation.
L'IDE que nous allons utilisé s'appelle Adagide et il est gratuit.
Cliquez ici pour télécharger Adagide dans sa version 7.45 (dernière en date à l'heure où j'écris ces lignes). Puis cliquez sur "adagide-7.45-setup.exe" pour lancer le téléchargement de l'installateur.
Installation
L'installation d'Adagide ne devrait pas vous poser de problèmes. Il vous suffit de suivre les différentes étapes en cliquant sur suivant. Acceptez les termes de la licence et à l'écran "Setup Type" choisissez "Typical".
Pour télécharger le compilateur GNAT GPL, rendez-vous sur le site d'Ada Core en cliquant ici.
Si vous êtes sous Windows, vérifiez que le système d'exploitation est bien "x-86 Windows" (à la ligne "Select your platform"), puis cliquez sur GNAT_GPL et sélectionnez "gnat-gpl-2011-i686-pc-mingw32-bin.exe". Enfin, tout en bas de la page, cliquez sur le bouton "Download selected files".
Pour les utilisateurs de Linux, le système d'exploitation devrait être "x86 - Linux" (ou "x86_64 - Linux" si votre processeur est en 64 bits). De la même manière que sous Windows, cliquez sur GNAT_GPL et sélectionnez "gnat-gpl-2011-i686-gnu-linux-libc2.3-bin.tar.gz". Pour finir, cliquez sur le bouton "Download selected files" en bas de page.
Installation
L'installation est un poil plus compliquée (même si ça ne casse pas trois pattes à un canard, comme dirait ma grand-mère :p ). Le fichier téléchargé s'appelle "AdaCore.tar" et ce n'est pas un programme d'installation, seulement un fichier compressé. Pour le décompresser, utilisez un logiciel comme Winrar ou 7zip. Sous Linux, vous pouvez procéder graphiquement ou par la console. Dans le second cas, vous devrez taper la commande suivante :
tar -xvzf gnat-gpl-2011-i686-gnu-linux-libc2.3-bin.tar.gz
Sous Windows, vous obtiendrez ainsi le fameux fichier d'installation "gnat-gpl-2011-i686-pc-mingw32-bin.exe". Ouvrez-le et suivez les différentes étapes. Je vous conseille de sélectionner l'option "Install for all users", notamment si votre ordinateur dispose de plusieurs sessions, à moins que vous ne vouliez être le seul à pouvoir programmer en Ada.
Sous Linux, l'installation se fera via le fichier script appelé "doinstall". Celui-ci vous demandera si vous souhaitez installer GNAT et si oui où. Vous n'aurez qu'à appuyer deux fois sur entrée puis répondre "Yes" aux deux dernières questions en appuyant sur les touches Y ou y.
GPS est un autre IDE, mais développé par AdaCore. Il est un peu plus compliqué et j'avoue ne pas avoir réussi à le démarrer sous mon PC Windows personnel (même s'il fonctionne sur mon PC Windows de bureau ou sous mon PC Ubuntu :( ). Adagide a l'avantage d'être simple et performant, je le préfèrerai donc à GPS. Mais si vous souhaitez tout de même utilisez GPS, sachez qu'à cette étape du chapitre ... il est déjà installé ! :p Cet IDE est en effet livré avec GNAT, vous pourrez donc le tester si la curiosité vous prend : il suffit d'aller dans le menu démarrer > Programmes > GNAT > 2010 > GPS.
Bien ! Nous voilà fin prêts pour réaliser notre premier programme ! Nous allons dès le prochain chapitre entrer dans le vif du sujet. Alors soyez prêts, à vos armes ! :pirate:
Bon, nous avons installé notre IDE, Adagide, notre compilateur, GNAT. Je sens que vous commencez à perdre patience. Nous allons immédiatement pouvoir nous atteler à notre premier programme en Ada. Il s'agira de créer un programme qui nous salue.
Bon, c'est sûrement pas folichon comme objectif, mais c'est un début. Voyons ici la démarche que nous allons suivre.
Tout d'abord, nous allons faire un petit tour d'horizon des logiciels Adagide et GPS. Je vous rassure, ce sera rapide.
Puis nous écrirons notre premier programme et nous le testerons.
Enfin, nous essaierons de décrypter notre premier programme
Avant de commencer le prochain chapitre je vous proposerai quelques petits suppléments et exercices pour vous entraîner.
Pour pouvoir programmer, nous avons déjà expliqué que nous aurons besoin de l'IDE Adagide. Donc, lancez Adagide ! Vous voilà donc face à une fenêtre tout ce qu'il y a de plus ... austère :( Mais rassurez-vous, cela n'a que peu d'importance pour nous.
Tout d'abord nous allons créer un nouveau document. Pour cela, cliquez sur File > New ou sur l'icône "Nouveau" indiqué ci-dessus. Vous pourrez également à l'avenir ouvrir un document existant en cliquant sur File > Open ou sur l'icône "ouvrir".
Pour l'heure, nous allons enregistrer notre document. Cliquez sur File > Save as ou sur l'icône "enregistrer". Je vous conseille de créer un répertoire que nous nommerons "Hello", et dans ce répertoire nous allons enregistrer notre document (appelons-le également Hello). Vous remarquerez que l'extension proposée est adb. Notre code en Ada portera le nom de Hello.adb ; par la suite nous verrons à quoi peut servir l'extension ads qui est également proposée.
Bien entendu, il est possible d'écrire dans la fenêtre principale, la taille du texte pouvant être modifiée en cliquant sur le bouton "taille". En revanche, il est impossible d'écrire dans la partie basse de la fenêtre, celle-ci étant réservée au compilateur. C'est ici que le compilateur affichera les informations qui vous seront nécessaires : échec de la compilation, réussite de la compilation ...
Pour les utilisateurs de GPS (plus long)
Le logiciel GPS est un peu plus compliqué que Adagide. Il est toutefois mieux adapté à de gros projets, ce qui explique qu'il soit plus complexe et donc moins adapté pour ce cours. Lorsque vous lancez GPS, une fenêtre devrait vous demander ce que vous souhaitez faire.
Pour l'heure, choisissez "Create new project with wizard" et cliquez sur OK. Choisissez l'option "Single project" puis cliquez sur Forward. Choisissez un nom pour votre projet (j'ai choisi HelloWorld) et précisez un répertoire où l'enregistrer (je vous conseille de créer un répertoire spécifique par projet). Cliquez ensuite sur Apply sans renseigner les autres informations. Vous devriez arriver à l'écran suivant :
La fenêtre est découpée en quatre zones. La première ne nous intéresse pas pour l'instant. La seconde, juste en dessous affichera les fichiers et programmes de votre projet. Pour l'heure vous n'aurez qu'un seul fichier donc cela ne comportera pas d'intérêt pour les premiers cours. Son utilité se révèlera à partir de la Partie III. La troisième zone de la fenêtre est la zone principale, celle où vous rédigerez votre programme. Enfin, la quatrième zone est celle réservée au compilateur et à la console. Vous comprendrez son utilité bientôt.
Commençons donc par créer un nouveau fichier en cliquant sur l'icône "Nouveau" ou sur File > New. Sauvegardez tout de suite votre fichier en cliquant soit sur l'icône "Enregistrer" soit sur File > Save As. Votre fichier devra s'appeler Hello.adb" (même si vous n'avez pas besoin d'écrire l'extension). Comme je vous le disais plus haut, il existe également un fichier .ads que nous verrons plus tard et que le logiciel GPS gère aussi. Pour ouvrir un document, vous pourrez utiliser l'icône "Ouvrir" ou sur File > Open.
Voila pour l'essentiel, toutefois, je vais vous demander d'effectuer deux petites manipulations avant d'aller plus loin afin d'ajouter deux icônes importants. Cliquez sur le menu Build > Settings > Targets. Une fenêtre devrait s'ouvrir.
A gauche, dans la section Project, cliquez sur Build <current file> et cochez la case In the toolbar. Puis, dans la section Run, cliquez sur Custom et cochez la case In the toolbar. Enfin, cliquez sur le bouton Apply. Les deux icônes suivants devraient s'ajouter (retenez-les bien).
Maintenant que nous avons, rapidement, pris connaissance du logiciel, il est temps de nous lancer corps et âme dans la création de notre magnifique programme Hello ! Nous allons pour cela effectuer une opération de haute voltige : un copier-coller ! Voici le code d'un programme, ne cherchez pas à comprendre pour l'instant, je vous expliquerai par la suite. Pour l'heure, sélectionnez le texte, copiez-le et collez-le dans votre fichier Hello.adb sans poser de questions.
with ada.text_io ;
use ada.text_io ;
procedure Hello is
--partie réservée aux déclarations
begin
put("Salut tout le monde !") ; --on affiche un message
end Hello ;
Vous remarquerez que certains mots sont automatiquement colorés, je vous en ai déjà parlé c'est la coloration syntaxique. Elle permet de faire ressortir certains mot-clés (Adagide colore par défaut en bleu les mots réservés au langage Ada) ou certains types de texte.
Avant d'aller plus loin, si vous êtes sous Adagide (GPS effectuera cette manœuvre tout seul le moment venu), il serait bon de cliquer sur l'icône "Reformat", il est simple à trouver, c'est celui avec un grand R dessiné dessus. Cela va mettre votre code en forme : la ligne entre is et begin et la ligne entre begin et end vont être "avancées" à l'aide d'une tabulation (trois espaces sous adagide). On appelle ça l'indentation. Ca n'a l'air de rien mais c'est très important car à l'avenir votre code pourra s'étendre sur plusieurs pages, il est donc important qu'il soit le plus lisible possible. Lorsque l'on rédige un roman, on crée des paragraphes, des chapitres ... en programmation on indente son texte.
Compiler, créer ... lancer !
Maintenant que votre texte est écrit et mis en forme, il est temps de le faire fonctionner. Nous allons donc utiliser le compilateur. Pour cela, rien de plus simple, cliquez sur l'icône "Compiler" (ou appuyer sur F2 avec Adagide, ou encore Compile > Compile File). Le compilateur vérifiera la syntaxe de votre code. S'il n'y a pas d'erreur (et il ne devrait pas y en avoir), le compilateur devrait vous indiquer (dans la fenêtre du bas) "Completed successfully".
Mais à ce stade, votre programme n'existe pas encore, vous devez construire l'exécutable. Pour cela cliquez sur l'icône "construire" (ou appuyez sur F3 avec Adagide ou cliquez sur Compile > Build).
Pour les utilisateurs de GPS, les manipulations étant un peu longues, je vous conseille d'utiliser les icônes (c'est bien pour cela que je vous ai fait faire une petite manipulation préliminaire). Lorsque vous cliquerez sur l'icône "Construire", une fenêtre peut s'ouvrir. Ne vous souciez pas des paramètres et cliquez sur OK.
Votre fichier exécutable est désormais créé. Vous pouvez soit aller le chercher dans le répertoire Hello que vous avez créé tout à l'heure, soit cliquer sur l'icône "Exécuter" (ou appuyer sur F4 avec Adagide ou cliquer sur Run > Execute). Sous GPS, une fenêtre s'ouvrira. Ne cochez aucune case et, si la barre de texte est vide, écrivez-y le nom de votre programme : Hello (sans extension !). Puis cliquez sur OK.
Avec Adagide, vous devriez ainsi obtenir une magnifique fenêtre noire vous indiquant :
Salut tout le monde !
(Sous GPS, ces actions apparaîtront dans la fenêtre du compilateur, c'est à dire la quatrième zone de la fenêtre)
Euh ... comment dire ... c'est tout ? J'ai lu tous ces chapitres pour voir ça !!! :colere:
Ne perdez pas patience. Le chemin sera long avant que vous ne puissiez créer un programme digne d'intérêt. :ange: Prenons le temps de décortiquer ce que nous avons copié pour mieux comprendre.
Si nous jetons un œil à notre code nous pouvons nous rendre compte qu'il peut se décomposer en deux parties majeures : une sorte de titre (avec with et use) et un gros paragraphe (commençant par le mot procedure).
Le corps du programme : la procédure Hello
Le titre étant un peu compliqué à expliquer, nous allons commencer par nous intéresser au "gros paragraphe" : la procédure appelée Hello. Elle peut se décomposer elle-même en deux parties comme sur l'image ci-dessus.
Les trois bornes de la procédure
Pour l'instant, disons que le terme de "procédure" est un synonyme de "programme". Notre paragraphe commence donc par l'introduction suivante : procedure Hello is. Cette phrase permet de donner un nom à notre procédure et indique le début du texte la concernant. Remarquez que les mots procedure et is sont colorés en bleu : ce sont des mots réservés par le langage Ada, ils ont donc un sens très précis et ne peuvent être utilisés n'importe comment.
Deuxième "borne" de notre procedure : le terme begin. C'est lui aussi un mot réservé. Il indique au compilateur le début des instructions que le programme devra exécuter.
Troisième "borne" : le mot end, ou plus exactement la phrase : "end Hello ; ". Cette phrase indique au compilateur la fin de la procédure Hello. À noter que contrairement aux deux bornes précédentes, cette phrase se termine par un point-virgule. Si vous oubliez de l'écrire, le compilateur vous avertira : missing ";" !
La partie déclarations
Les trois bornes vues précédemment délimitent deux zones. La première, celle comprise entre is et begin est réservée aux déclarations. Nous verrons dans les prochains chapitres de quoi il retourne, sachez pour l'instant qu'il faut prévenir votre ordinateur lorsque avez besoin de réquisitionner de la mémoire (et nous aurons besoin d'en réquisitionner) et que c'est dans cette partie que s'effectueront ces "demandes de réquisition". Pour l'heure, il n'y a rien.
Comment ça il n'y a rien ? Il y a bien quelque chose d'écrit : "--partie réservée aux déclarations"
Eh bien non. Pour le compilateur, il n'y a rien ! :p Cette ligne verte commence par deux tirets, c'est l'indication qu'il s'agit d'un commentaire, c'est à dire d'un texte qui ne sera pas pris en compte par le compilateur. Quel intérêt d'écrire du texte s'il n'est pas pris en compte par le compilateur ? Eh bien cela permet d'apporter des annotations à votre code. Si vous relisez un code écrit par quelqu'un d'autre ou par vous même il y a longtemps, vous risquez d'avoir du mal à le comprendre. Les commentaires sont donc là pour expliquer ce que fait le programme, à quoi servent telle ou telle ligne etc... un bon code est déjà un code bien commenté (et bien indenté également).
La partie actions et notre première instruction
Puis, après le begin, vient la partie la plus intéressante, celle où l'on indique au programme ce qu'il doit faire, autrement dit, c'est là que nous écrirons les différentes instructions.
L'instruction citée ici est : "Put("Salut tout le monde!") ;". C'est assez simple à comprendre : l'instruction Put() indique à l'ordinateur qu'il doit afficher quelque chose. Et entre les parenthèses, on indique ce qu'il faut afficher. Il est possible d'afficher un nombre (par exemple, Put(13) ; affichera le nombre 13) comme du texte, mais le texte doit être écrit entre guillemets.
Remarquez là encore que l'instruction se termine par un point-virgule. D'ailleurs, toutes les instructions devront se terminer par un point virgule, à quelques exceptions près (souvenez-vous de is et begin). Le texte qui suit est bien entendu un commentaire et tout ce qui suit les double-tirets ne sera pas pris en compte par le compilateur.
Il est bien sûr possible d'afficher autre chose que "salut tout le monde !" ou d'effectuer d'autres actions. Toutefois, lorsque toutes vos actions ont été écrites, n'oubliez pas d'indiquer au compilateur que vous avez atteint la fin en utilisant le mot end.
Les Packages avec With et Use
Le mot-clé WITH
Revenons maintenant au titre. Pourquoi cet intitulé ? Et d'ailleurs pourquoi l'écrire deux fois ? Je vous propose de le supprimer pour mieux comprendre. Compiler à nouveau votre code.
:waw: Argh ! ! ! Ca marche plus ! J'ai tout plein de messages rouge ! Tout est fichu !
En effet, le code n'est plus correct et ce n'est pas la peine d'essayer de reconstruire notre programme. Mais lisons les avertissements du compilateur. Tout d'abord : "Put" is undefined.
Cela signifie tout simplement que le compilateur ne connaît plus l'instruction Put() ! En effet, le compilateur ne connaît que très peu de mots et d'instructions : les mots réservés et puis c'est presque tout. Pour aller plus loin, il a besoin de fichiers qui contiennent d'avantage d'instructions comme l'instruction Put() par exemple qui se situe dans un fichier appelé Ada.Text_IO. Ces fichiers portent le nom de package en Ada (paquetages en Français). Dans d'autres langages, on parlerait de librairies.
Le compilateur nous dit également : possible missing "WITH Ada.Text_IO ; USE Ada.Text_IO ;". Traduction : ce serait bien de remettre les lignes que vous avez supprimé tout à l'heure ! Écoutons-le mais ne réécrivons que la première ligne (au tout début) :
WITH Ada.Text_IO ;
Le mot-clé USE
Réessayons de compiler.
Nouveau problème. Le compilateur m'indique : "Put" is not visible plus plein d'autres insultes incompréhensibles. Apparemment, il connait mon instruction Put() mais il n'arrive plus à la voir ?!?
Exactement. Et les lignes qui suivent indiquent que dans le package ada.Text_IO il y a plusieurs références à l'instruction Put(). En fait, il est possible après l'instruction with d'écrire de nombreux packages, autant que vous voulez même (nous verrons un exemple juste après). Mais il peut exister (et il existe) plusieurs instructions portant le nom Put(), du coup le compilateur ne sait pas d'où vient cette instruction. De laquelle s'agit-il ? Une solution est de remplacer Put() par Ada.Text_IO.Put() ! C'est compliqué, c'est long à écrire et nous aurons tout le loisir de comprendre tout cela plus tard. Donc une façon de s'épargner ces difficultés, c'est d'écrire notre instruction Use au tout début, juste après l'instruction with.
Ces deux lignes (appelées Context Clause en Ada) sont donc indispensables et vous serez souvent amenés à réécrire les mêmes (vous bénirez bientôt l'inventeur du copier-coller). Ne croyez pas que cette lourdeur soit spécifique à Ada, tout langage a besoin de packages ou librairies annexes, tout n'est pas prédéfini et heureusement pour nous : c'est ce que l'on appelle la modularité. Au final, voici la structure de notre programme (et de tout programme Ada) :
Avec plusieurs packages
J'ai essayé de bidouiller le code pour qu'il affiche 13 comme tu le disais dans un exemple. Mais le compilateur râle encore : warning : no entities of "Text_Io" are referenced, no candidate match the actuals : ... enfin bref rien ne va plus. Faut-il un autre package ?
Exactement ! Ada.Text_IO est un package créé pour gérer le texte comme son nom l'indique (Text = texte et IO = In Out, entrée et sortie). Pour afficher un nombre entier (ici 13) il faut utiliser le package Ada.Integer_Text_IO. Exemple :
WITH Ada.Text_IO,Ada.Integer_Text_IO ;
USE Ada.Text_IO,Ada.Integer_Text_IO ;
Pour plus de clareté, il est également possible d'écrire ceci :
WITH Ada.Text_IO,
Ada.Integer_Text_IO ;
USE Ada.Text_IO,
Ada.Integer_Text_IO ;
Et oui ! Bien indenter son code, c'est très important !
Une dernière remarque qui a son importance
Vous devez savoir avant de vous lancer à l'aventure que le langage Ada n'est pas "case sensitive", comme diraient nos amis Anglais, il ne tient pas compte de la casse. Autrement dit, que vous écriviez en majuscule ou en minuscule, cela revient au même : BEGIN, Begin, begin ou bEgIn seront compris de la même manière par le compilateur. Toutefois, Ada sait faire la différence lorsqu'il faut : si vous modifiez la casse dans la phrase à afficher "Salut tout le monde !", l'affichage en sera modifié.
De même, une tabulation ou un espace seront pris en compte de la même façon. Et que vous tapiez un, deux ou trois espaces ne changera rien.
Ce premier programme est peut-être simple, mais voici quelques exercices pour nous amuser encore. Nous avons vu l'instruction Put() qui affiche du texte, en voici maintenant une nouvelle : New_line. Elle permet de retourner à la ligne. N'oubliez pas le point virgule à la fin.
Énoncé
Écrire un programme affichant ceci :
Coucou
tout le
monde
! ! !
Solution
With ada.text_io ;
use ada.text_io ;
procedure Hello2 is
begin
Put("Coucou") ; New_line ;
Put("tout le") ; New_line ;
Put("monde") ; New_line ;
Put("! ! !") ;
end Hello2 ;
Exercice 2
Troisième instruction : Put_line(). Elle fonctionne comme Put(), sauf qu'elle crée automatiquement un retour à la ligne à la fin.
Énoncé
Même exercice que précédemment, mais sans utiliser New_line.
Solution
With ada.text_io ;
use ada.text_io ;
procedure Hello3 is
begin
Put_line("Coucou") ;
Put_line("tout le") ;
Put_line("monde") ;
Put("! ! !") ; --pas besoin de put_line ici, on est arrivé à la fin
end Hello3 ;
Exercice 3
Enoncé
Pourquoi ne pas créer des programmes affichant autre chose que "coucou tout le monde ! ".
Vous avez désormais créé votre premier programme. Certes, il n'est pas révolutionnaire, mais c'est un début. Nous allons pouvoir quitter la première partie de ce tutoriel et entrer dans les bases de la programmation en Ada. La prochaine partie nous permettra de manipuler des nombres, d'effectuer des opérations, de saisir des valeurs au clavier ... peu à peu nous allons apprendre à créer des programmes de plus en plus complexes.
Maintenant que Adagide et GNAT sont installés et que nous avons une idée plus précise de ce qui nous attend, nous allons pouvoir commencer notre apprentissage du langage Ada.
Nous avons dors et déjà réalisé notre premier programme. Mais chacun comprend vite les limites de notre programme "Hello". A dire vrai, un tel programme n'apporte absolument rien. Ce qui serait intéressant, ce serait que l'utilisateur de notre programme puisse entrer des informations que l'ordinateur lui demanderait. Par exemple :
Quel âge avez-vous ? _
Et là nous pourrions entrer 25, 37 ou 71 ! Le programme pourrait ensuite se charger d'enregistrer cette information dans un fichier, de nous avertir si nous sommes considérés comme majeur dans l'état du Minnesota ou encore de nous donner notre âge en 2050 ... autant d'applications que nous ne pourrons pas réaliser si l'âge que l'utilisateur indiquera n'est pas enregistré dans une zone de la mémoire.
Et c'est là que les variables interviennent ! Attention, ce chapitre n'est peut-être pas exaltant mais il est absolument nécessaire à la compréhension des prochains.
Nous allons reprendre l'exemple de l'introduction. Nous voulons indiquer un âge à notre programme. Nous aurons donc besoin d'un espace mémoire capable de stocker un nombre entier. Il faudrait effectuer une demande d'allocation d'une zone mémoire et retenir l'adresse mémoire qui nous a été attribuée et la taille de la zone allouée. o_O
Euh ... c'était pas marqué Niveau facile ?
Pas d'inquiétude. Tout cela c'est ce qu'il aurait fallu faire (entre autre) si nous n'avions pas utilisé un langage comme Ada. C'est ce qu'on appelle un langage de haut niveau, c'est à dire que l'on n'aura pas besoin de se casser la tête pour faire tout cela. Il suffira de dire " :pirate: Je veux de la mémoire !". :p
Toutefois, l'ordinateur a tout de même besoin de connaître la place mémoire dont vous aurez besoin et cela dépend du type d'information que l'on souhaite y enregistrer. Ici nous voulons enregistrer un nombre entier que nous appelons age. Le mot age est le nom de notre variable, c'est à dire l'endroit de la mémoire où seront enregistrées nos informations. Pour faire tout cela, il faut déclarer notre variable (comme on le ferait à la douane, cela permet de savoir qui vous êtes et comment vous retrouver). Une déclaration se fait toujours de la façon suivante :
NOM_DE_LA_VARIABLE:TYPE;
Il est possible de déclarer plusieurs variables d'un coup de la manière suivante :
NOM_DE_LA_VARIABLE1,NOM_DE_LA_VARIABLE2:TYPE;
Il est aussi possible, aussitôt la variable déclarée, de lui affecter une valeur à l'aide du symbole ":=". On écrira alors :
NOM_DE_LA_VARIABLE:TYPE:=VALEUR;
Où dois-je faire cette déclaration ? En préfecture ? :(
Vous vous souvenez notre premier programme ? Je vous avais parlé d'une zone réservée aux déclarations (entre is et begin). Et bien c'est ici que nous déclarerons notre variable.
Procedure VotreAge is
NOM_DE_LA_VARIABLE1 : TYPE1 := VALEUR ; --zone réservée aux déclarations
NOM_DE_LA_VARIABLE2 : TYPE2 ;
begin
Put("Quel age avez-vous ?") ;
end ;
Bien, il est temps de rentrer dans le vif du sujet : comment déclarer notre variable age ?
Le type Integer est réservé aux nombres entiers relatifs. Pour ceux qui ne se souviendraient pas de leur cours de Mathématiques, un entier est un nombre "qui n'a pas de chiffres après la virgule à part 0". Relatif signifie que ces entiers peuvent être positifs (avec un signe +) ou négatifs (avec un signe -).
Le type Natural est réservé aux nombres entiers naturels (c'est à dire positifs ou nul). Il est donc impossible, si vous déclarez votre variable comme un Natural, que celle-ci soit négative (ou alors vous planterez votre programme). Pour être plus précis, c'est un sous-type du type Integer. Quelle importance ? Eh bien, cela signifie que l'on pourra "mélanger" les natural et les integer sans risquer le plantage : nous pourrons les additionner entre eux, les soustraire, les multiplier ... ce qui n'est pas possible avec d'autres types. La seule restriction, que notre natural ne devienne pas négatif.
Valeurs possibles
Si N est une variable de type Integer, elle peut prendre les valeurs suivantes : 0 ; 1 ; 2 ; 3 ; 4 ... 2 147 483 647 -1 ; -2 ; -3 ... - 2 147 483 648
Si N est une variable de type Natural, elle peut prendre les valeurs suivantes : 0 ; 1 ; 2 ; 3 ... 2 147 483 647
Exemple
Si nous voulons pouvoir utiliser les Integer ou les Natural, il faudra ajouter Ada.Integer_Text_IO dans la listes des packages :
With Ada.Text_IO, Ada.Integer_Text_IO ;
Use Ada.Text_IO, Ada.Integer_Text_IO ;
Et voila pour le début de notre code :
Procedure VotreAge is
age : Integer := 27;
begin
...
Ou bien, sans affecter de valeur :
Procedure VotreAge is
age : Integer ;
begin
...
Le type Float
Définition
Le type float est chargé de représenter les nombres décimaux. Dans les faits, il n'en représente en fait qu'une partie (comme les Integer ne couvrent pas tous les nombres entiers).
Autant Natural = Naturel ; Integer = Entier, ça semblait évident, autant là : Float = Décimal !?! Je vois mal la traduction :(
Valeurs possibles
Si X est une variable de type float, elle peut prendre les valeurs suivantes : 0.0 ; 1.0 ; 2.0 ... 3,40282E38 (un nombre avec 39 chiffres) -1.0 ; -2.0 ... -3,40282E38 (un nombre avec 39 chiffres) 1.5 ; 2.07 ; 3.141592 ...
Exemple
Si nous voulons pouvoir utiliser les Float, il faudra ajouter Ada.Float_Text_IO dans la listes des packages :
With Ada.Text_IO, Ada.Float_Text_IO ;
Use Ada.Text_IO, Ada.Float_Text_IO ;
Et voila pour le début d'un programme qui demanderait votre taille et votre poids :
Procedure TaillePoids is
Taille : Float := 1.85 ;
Poids : Float := 63.0 ;
begin
...
Ou bien, sans affecter de valeur et en déclarant les deux variables en même temps :
Procedure TaillePoids is
Taille, Poids : Float ;
begin
...
Le type Character
Définition
Le type Character est réservé pour les caractères, c'est à dire les lettres. Toutefois, les espaces, les tabulations constituent aussi des caractères de même que le retour à la ligne, la fin de fichier ... qui sont des caractères non imprimables. Le type Character ne contient pas une phrase mais un seul caractère.
Valeurs possibles
Si C est une variable du type Character, elle peut prendre les valeurs suivantes : 'a', 'b', 'c' ... 'z', 'A', 'B', 'C' ... 'Z', '#', ' ', '%' ...
En réalité, les characters ont les valeurs suivantes : 0, 1, 2 ... 255. Les ordinateurs ne gèrent pas les lettres, mais les chiffres oui ! A chacun de ces nombres est associé un caractère. Dans certains langages il est donc possible d'écrire 'a'+1 pour obtenir 'b'. Mais le langage Ada, qui a un typage fort (certains diront excessif), empêche ce genre d'écriture : une lettre plus un nombre, c'est une aberration en Ada :colere: . Ne vous inquiétez pas, nous verrons plus tard les opérations possibles sur les character.
Exemple
Si nous voulons pouvoir utiliser les Character, il suffit d'avoir écrit Ada.Text_IO dans la listes des packages :
With Ada.Text_IO ;
Use Ada.Text_IO ;
Et voila pour le début d'un programme qui demanderait votre initiale :
Procedure Initiales is
Ini : Character := 'K' ; --Comme Kaji9 :-)
begin
...
Bien ! Maintenant que l'on sait déclarer les principaux types de variables, voyons comment leur attribuer une valeur (on dit qu'on leur affecte une valeur). En effet, nous avons réquisitionné une zone de la mémoire de notre ordinateur mais il n'y a encore rien d'écrit dédans. Pour cela, revenons à notre programme VotreAge :
with Ada.Text_IO, Ada.Integer_Text_IO ;
use Ada.Text_IO, Ada.Integer_Text_IO ;
Procedure VotreAge is
Age : integer ;
Begin
...
Il y a deux personnes qui peuvent affecter une valeur à la variable Age : vous (le programmeur) ou l'utilisateur( peut-être vous aussi, mais pas dans le même rôle).
Affectation par le programmeur (ou le programme)
On va utiliser le symbole ":=" vu auparavant, mais cette fois, après le Begin.
with Ada.Text_IO, Ada.Integer_Text_IO ;
use Ada.Text_IO, Ada.Integer_Text_IO ;
Procedure VotreAge is
Age : integer ;
Begin
Age := 27 ;
End VotreAge ;
Ce programme se contentera d'affecter 27 à une variable Age.
Affectation par l'utilisateur
Nous savons comment poser une question à l'utilisateur avec l'instruction Put. Pour récupérer sa réponse on utilisera la fonction Get.
with Ada.Text_IO, Ada.Integer_Text_IO ;
use Ada.Text_IO, Ada.Integer_Text_IO ;
Procedure VotreAge is
Age : integer ;
Begin
Put("Quel age avez-vous ?") ; -- on est poli, on demande l'âge
Get(Age) ; -- puis on saisit la réponse de l'utilisateur
Skip_line ; -- ???
Put("Ah, vous avez ") ; Put(Age) ; -- on fait une phrase affichant la réponse
End VotreAge ;
Bien, bien. C'est pas trop compliqué. Sauf que c'est quoi ce Skip_line ?
L'instruction Skip_line
Skip_line est une instruction que je vous conseille fortement d'écrire après chaque utilisation de l'instruction Get. Pour comprendre son utilité, reprenons l'exemple du programme TaillePoids :
with Ada.Text_IO, Ada.Float_Text_IO ;
use Ada.Text_IO, Ada.Float_Text_IO ;
Procedure TaillePoids is
Taille, Poids : float ;
Begin
Put("Quelle est votre taille ?") ;
Get(Taille) ;
Put("Vous mesurez ") ;
Put(Taille) ;
Put(" m.") ;
Put("Quel est votre poids ?") ;
Get(Poids) ;
Put("Vous pesez ") ;
Put(Poids) ;
Put(" kg.") ;
End TaillePoids ;
Puis voyons ce qu'il se passe dans la console :
Quelle est votre taille ? 1.8R
Vous mesurez 1.8 m.
Quel est votre poids ?
raised ADA.IO_EXCEPTIONS.DATA_ERROR : a-tiinio.adb:89 instantiated at a-inteio.ads:18
Notre utilisateur a tapé 1.8R au lieu de 1.85 (erreur de frappe). Logiquement, le programme plante. Mais regardons en détail ce qu'il s'est passé. La taille enregistrée est 1.8, le R n'a pas été pris en compte. Alors pourquoi le programme ne nous laisse-t-il pas entrer une nouvelle taille ? Pourquoi détecte-t-il une erreur alors que nous n'avons entré aucun poids ? Et qui plus est : pourquoi ne la détecte-t-il pas plus tôt ?
En fait, en tapant 1.8R nous avons envoyé dans le buffer (la mémoire tampon) 1.8 puis R puis le "entrée" (qui constitue également un caractère). L'instruction Get(Taille) s'est emparée de 1.8, mais le R est resté en mémoire tampon puisqu'à l'évidence, il ne faisait pas partie du nombre demandé. Par conséquent, l'instruction Get(Poids) a regardé dans le buffer ce qu'il y avait à récupérer : la lettre R que vous aviez tapé par erreur ! L'instruction Get(Poids) s'est donc emparé du R qui est un character et non un Float. D'où l'erreur.
Et Skip_line dans tout ça ? o_O
Et bien l'instruction Skip_line aurait évité cette erreur, car Get(Taille) aurait saisit 1.8 pour la taille (comme tout à l'heure) et Skip_line aurait ensuite vidé la mémoire tampon : plus de R ou de touche "entrée" en mémoire. Nous aurions ainsi pu saisir notre poids tranquillement.
Voici le code, corrigé avec Skip_line :
with Ada.Text_IO, Ada.Float_Text_IO ;
use Ada.Text_IO, Ada.Float_Text_IO ;
Procedure TaillePoids is
Taille, Poids : float ;
Begin
Put("Quelle est votre taille ?") ;
Get(Taille) ; Skip_line ;
Put("Vous mesurez ") ;
Put(Taille) ;
Put(" m.") ;
Put("Quel est votre poids ?") ;
Get(Poids) ; Skip_line ;
Put("Vous pesez ") ;
Put(Poids) ;
Put(" kg.") ;
End TaillePoids ;
Cette dernière partie est plus technique. Si vous avez peur qu'elle ne vous embrouille. Je vous conseille de relire ce qui précède et de faire des exemples (c'est en forgeant que l'on devient forgeron ^^ ). Toutefois, je vous invite à revenir lire ce qui suit, aussitôt que vous maîtriserez les notions de types car les constantes et les attributs (surtout les attributs) nous serons forts utiles par la suite.
Constantes
Une variable peut ... varier. Étonnant non ? :p Ce n'est pas parce que vous l'avez initialisée à 15 qu'elle ne peut pas être modifiée plus tard pour valoir 18, bien au contraire. C'est d'ailleurs là tout leur intérêt.
N := 10 ; --la variable N prend la valeur 10
N:= 13 ; --Puis la valeur 13
N:= 102 ; --Et enfin la valeur 102 !
Mais il est parfois intéressant de fixer leur valeur une fois pour toute. La variable ne varie alors plus, elle devient une constante et doit être déclarée de la manière suivante :
MaVariable : Constant Integer := 15 ;
Nous avons ainsi une variable MaVariable qui vaudra toujours 15. Tentez seulement de modifier cette valeur et vous entraînerez un plantage de votre programme (ou plutôt, votre compilateur refusera de compiler votre code).
A quoi servent les constantes ? Exemple simple :
PI : Constant Float := 3.1415926535 ;
Chacun comprend que si la valeur de ma variable PI est modifiée, tous mes calculs d'aire de disque, de périmètre de cercle ou de volume de boule ... seront faux. Donc PAS TOUCHE A MA CONSTANTE ! ! ! :lol:
Attributs
Comment obtenir le plus petit et le plus grand Integer ? Comment savoir quel est le 93ème character ? Grâce aux attributs, bien sûr. Ce sont des sortes d'instructions qui s'appliquent aux types.
Avant d'en voir quelques uns, rappel d'Anglais : Repeat after me ! "Susan's dog" signifie "le chien de Susan". Ainsi, le petit mot " 's" exprime l'idée d'appartenance et il faut penser à inverser l'ordre des noms par rapport au Français. Pourquoi ce rappel ? Eh bien parce que les attributs s'utilisent de la même manière :
N := integer'first ; --N sera le premier des integer
M := integer'last ; --M sera le dernier des integer
C := character'val(93) ; --C sera la 93ème valeur des character
P := character'pos('f') ; --P aura pour valeur la position du character 'f'
Nous reverrons plus abondamment les attributs dans les chapitres suivants. Commencez déjà par vous faire la main sur ces quatre là : quel est le plus petit float ? Le plus grand ? Quel est la position de 'a' et du 'A' ?
Bien, nous savons maintenant déclarer une variable et lui affecter une valeur. Nous avons vu également quelques types de variables. Nous serons amenés par la suite à voir d'autres types plus complexes (tableaux, chaînes de caractères, classes, pointeurs, ...).
Avant cela, nous devrons voir un second chapitre sur les variables. C'est en effet intéressant de les avoir enregistrées en mémoire, mais il serait bien plus intéressant de pouvoir les modifier à l'aide de quelques formules mathématiques simples.
Nous allons, dans ce chapitre, aborder les opérations que l'on peut effectuer sur les différents types de variables : Integer, Natural, Float et Character. En effet, il ne suffit pas de créer des variables et de leur affecter une valeur ; encore faut-il qu'elles servent à quelque chose, que l'on effectue quelques opérations avec elles sans quoi le compilateur GNAT risque de nous renvoyer le message :
Warning : variable "Machin" is never read and never assigned
Autrement dit, votre variable ne sert à rien ! :p
Un dernier rappel : toutes les opérations d'affectation devront être écrites, je le rappelle, entre begin et end.
Je pense que les exemples abordés ci-dessus parlent d'eux-mêmes. Mais ils sont très légers. Voici quelques exemples un peu plus poussés :
Get(N) ; skip_line ; --on saisit deux variables de type integer
Get(M) ; skip_line ;
Resultat := N + M + 1 ; --La variable Resultat prend la valeur résultant
--de l'addition des deux variables N et M
Au lieu d'effectuer un calcul avec des valeurs connues, il est possible de faire des calculs avec des variables dont on ne connait pas, a priori, leur valeur.
Get(Var) ; skip_line ; --on saisit une variable de type integer
Var := Var + 1 ;
Hein ? Var est égal à Var + 1 ?!?
NON ! Le symbole n'est pas = mais := ! Ce n'est pas un symbole d'égalité mais d'affectation ! Supposons que Var soit égal à 5. Alors Var + 1 vaudra 6. Le code ci-dessus affectera donc 6 à la variable Var, qui valait auparavant 5. On change donc la valeur de la variable (Ne vous avais-je pas dit que les variables variaient ? ^^ )
N := 36.0**0.5 (résultat 6, la puissance 0.5 équivaut à la racine carre)
ABS
Valeur absolue
N := ABS(-8.7) (résultat 8.7)
Globalement, on retrouve les mêmes opérations qu'avec les Integer et les Natural. Attention toutefois à ne pas additionner (ou soustraire, multiplier ...) un Integer et un Float. Si le symbole de l'addition est le même pour les deux types, il s'agit dans les faits de deux instructions distinctes : l'une pour les Integer, l'autre pour les Float.
Mais comment je fais si j'ai besoin d'additionner un Float et un Integer ?
C'est très simple. Voici un exemple :
Procedure addition is
M : integer := 5 ;
X : float := 4.5 ;
Res_int : integer ;
Res_float : float ;
Begin
Res_int := M + Integer(X) ;
Put(Res_int) ;
Res_float := Float(M) + X ;
Put(Res_float) ;
End addition ;
L'instruction Integer(X) permet d'obtenir la valeur entière de la variable X. Comme X vaut 4.5, Integer(X) donnera comme résultat 4. L'instruction Float(M) permet d'obtenir l'écriture décimale de la variable M. Comme M vaut 5, Float(M) donnera comme résultat 5.0.
Nous avons déjà parlé dans la partie précédente des attributs. Nous aurons encore besoin d'eux dans cette partie pour effectuer des "opérations" sur les character. Voici un tableau récapitulatif de quelques attributs applicables au type character.
Attribut
Explication
Exemple
first
Renvoie le premier de tous les caractères.
c:=character'first ;
last
Renvoie le dernier de tous les caractères.
c:=character'last ;
pos(#)
Renvoie la position du caractère remplaçant #. Attention, le résultat est un Integer.
n := character'pos('z') ;
val(#)
Renvoie le #ème caractère. Attention, le symbole # doit être remplacé par un Integer
c:=character'val(165) ;
succ(#)
Renvoie le character suivant
c:=character'succ(c) ;
pred(#)
Renvoie le character précédent
c:=character'pred(c) ;
Nous avons vu au chapitre précédent que certains langage autorisaient l'écriture du calcul "'a' + 1" pour obtenir le character 'b'. Pratique, rapide ! Seul souci, on mélange deux types distincts : Character et Integer. Ce genre d'écriture est donc prohibée en Ada. On utilisera donc les attributs de la manière suivante :
character'val(character'pos('a') + 2) ;
Explication : les calculs seront effectués dans l'ordre suivant :
character'pos('a') va renvoyer le numéro de 'a', sa position dans la liste des characters disponibles.
Puis on effectue l'addition (Position de 'a' + 2). Ce qui renvoie un nombre entier correspondant à la position du 'c'.
Enfin, character'val(...) transformera le résultat obtenu en character : on devrait obtenir ainsi 'c' !
Qui plus est, cette opération aurait pu être faite à l'aide de l'attribut succ :
character'succ(character'succ('a')) ;
Si ces écritures vous semblent compliquées, rassurez-vous, nous ne les utiliserons pas tout de suite et nous les reverrons plus en détail dans le chapitre sur les fonctions. :)
Pour mettre tout de suite en pratique ce que nous venons de voir, voici quelques exercices d'application.
Exercice 1
Enoncé
Rédiger un programme appelé Multiple qui demande à l'utilisateur de saisir un nombre entier et lui retourne son double, son triple et son quintuple. J'ajoute une difficulté ! Vous n'aurez le droit qu'à deux multiplications pas une de plus !
Solution
WITH Ada.Text_IO, Ada.Integer_Text_IO ;
USE Ada.Text_IO, Ada.Integer_Text_IO ;
PROCEDURE Multiple IS
N : Integer ;
Double, Triple : Integer ;
BEGIN
Put("Saisissez un nombre entier : ") ;
Get(N) ; Skip_Line ;
Double := 2*N ;
Triple := 3*N ;
Put("Le double de ") ; Put(N) ; Put(" est ") ; Put(Double) ; New_Line ;
Put("Le triple de ") ; Put(N) ; Put(" est ") ; Put(Triple) ; New_Line ;
Put("Le quintuple de ") ; Put(N) ; Put(" est ") ; Put(Double+Triple) ;
END Multiple ;
Exercice 2
Enoncé
Rédiger un programme appelé Euclide qui demande deux nombres entiers à l'utilisateur puis renvoie le quotient et le reste de leur division euclidienne (c'est à dire la division entière telle que vous l'avez apprise en primaire).
Solution
WITH Ada.Text_IO, Ada.Integer_Text_IO ;
USE Ada.Text_IO, Ada.Integer_Text_IO ;
PROCEDURE Euclide IS
N,M : Integer ;
BEGIN
Put("Saisissez le dividende : ") ;
Get(N) ; Skip_Line ;
Put("Saisissez le diviseur : ") ;
Get(M) ; Skip_Line ;
Put("La division de ") ; Put(N) ;
Put(" par ") ; Put(M) ;
Put(" a pour quotient ") ; Put(N/M) ;
Put(" et pour reste ") ; Put(N mod M) ;
END Euclide ;
Exercice 3
Enoncé
Rédigez un programme appelé Cercle qui demande à l'utilisateur de saisir la longueur d'un rayon d'un cercle et qui affichera le périmètre et l'aire de ce cercle. Contrainte : le rayon du cercle sera un nombre entier !
Solution
WITH Ada.Text_IO, Ada.Integer_Text_IO, Ada.Float_Text_IO ;
USE Ada.Text_IO, Ada.Integer_Text_IO, Ada.Float_Text_IO ;
PROCEDURE Cercle IS
R : Integer ;
PI : constant float := 3.1415926 ;
BEGIN
Put("Saisissez le rayon du cercle : ") ;
Get(R) ; Skip_Line ;
Put("Un cercle de rayon ") ; Put(R) ;
Put(" a pour perimetre ") ; Put(2.0*PI*float(R)) ;
Put(" et pour aire ") ; Put(float(R**2)*Pi) ;
END Cercle ;
Exercice 4
Enoncé
Rédiger un programme appelé Lettres qui demande à l'utilisateur de saisir deux lettres minuscules et qui affichera leur majuscule ainsi que la lettre se trouvant "au milieu" des deux. A défaut, s'il y a deux lettres, le programme choisira la "plus petite".
Solution
WITH Ada.Text_IO ;
USE Ada.Text_IO ;
PROCEDURE Lettres IS
C1,C2,C3 : character ;
BEGIN
Put("Saisissez une premiere lettre minuscule : ") ;
Get(C1) ; Skip_Line ;
Put("Sa majuscule est ") ; Put(Character'Val(Character'Pos(C1)-32)) ; New_Line ;
Put("Saisissez une deuxieme lettre minuscule : ") ;
Get(C2) ; Skip_Line ;
Put("Sa majuscule est ") ; Put(Character'Val(Character'Pos(C2)-32)) ; New_Line ;
C3 := character'val((character'pos(C1) + character'pos(C2))/2) ;
Put("La lettre du milieu est ") ; Put(C3) ;
END Lettres ;
Bien, nous voilà désormais armés pour effectuer des calculs, simples ou complexes, sur les différents types de variables connus pour l'heure. Nous aurons l'occasion de les réutiliser par la suite et de comprendre toute leur utilité, notamment pour l'opération mod, qui doit pour l'instant vous sembler bien inutile (et pourtant elle sera plus utile que vous ne le pensez).
Le prochain chapitre devrait nous permettre d'apporter plus de variété encore à nos programmes en effectuant des actions différentes selon certains critères. Ce sont les conditions.
Un programme informatique permet d'automatiser des tâches (souvent répétitives) mais n'oublions pas qu'il va s'adresser à des utilisateurs humains qui auront envie d'avoir la main et d'effectuer des choix. Nos programmes doivent donc en tenir compte et gérer ces choix : "SI l'utilisateur fait tel choix ALORS faire ceci SINON faire cela".
Nous profiterons également de ce chapitre pour voir différents opérateurs permettant de comparer nos variables. Par la suite, nous aborderons l'algèbre booléenne, terme effrayant mais qui recouvre des règles de logique qui nous permettront de gérer des conditions plus complexes.
Le programme étant suffisamment chargé, ce chapitre sera partagé en deux.
Nous allons réaliser un programme qui demande à son utilisateur s'il dispose de plusieurs ordinateurs. Cette question n'appellera que deux choix possibles : Oui et Non. Le programme renverra un message à l'écran qui dépendra de la réponse obtenue. Ce programme peut se décomposer de la manière suivante :
AFFICHER la question : "Avez-vous plusieurs ordinateurs ?"
SAISIR la réponse (Oui ou Non)
SI la réponse est oui
ALORS AFFICHER : "Vous avez bien de la chance."
Nous enregistrerons la réponse dans une variable Reponse qui sera de type Character. L'utilisateur devra taper "o" pour oui et "n" pour non. L'instruction SI se note IF en Ada, l'instruction ALORS se note quant à elle THEN. D'où le code suivant :
Procedure Questionnaire is
Reponse : Character := 'n' ; --on définit Reponse et on lui attribue
--par défaut la valeur n (pour non)
begin
Put("Avez-vous plusieurs ordinateurs ? (o/n) ") ;
Get(Reponse) ; Skip_line ; --On saisit la réponse et on vide la mémoire tampon
if Reponse = 'o' --SI Reponse est égal à o
then Put("Vous avez bien de la chance."); --ALORS on affiche la phrase.
end if ;
end Questionnaire ;
Mais pourquoi tu as écrit juste = et pas := comme avant ?
Tout simplement parce que le symbole := est utilisé pour affecter une valeur à une variable. Si nous avions écrit :
Reponse := 'o'
... alors nous aurions modifier la valeur de Reponse en lui attribuant la valeur 'o'. Or ici nous posons une question au programme : Reponse est-il bien égal à 'o' ? Le programme se chargera de répondre vrai ou faux. C'est pourquoi nous utiliserons ici le symbole =. D'ailleurs, après une instruction if, le compilateur refuserait que vous utilisiez le symbole :=.
Autres remarques, l'instruction if doit être clôturée par une instruction end if qui marquera la fin des actions à exécuter dans cette instruction if. Et s'il ne faut pas de ";" à la fin de l'instruction if, il en faut bien après end if !
Mais ce programme présente de grooooosses lacunes. Que se passe-t-il si l'utilisateur répond non (n) ? Eh bien pour l'instant, c'est très simple : rien. :lol:
Une première alternative
Nous allons donc compléter notre code de la manière suivante :
AFFICHER la question : "Avez-vous plusieurs ordinateurs ?"
SAISIR la réponse (Oui ou Non)
SI la réponse est oui
ALORS AFFICHER : "Vous avez bien de la chance."
SINON AFFICHER : "Ha ... Dommage."
L'instruction SINON se traduit par Else et nous permettra de varier un peu notre programme. ^^ Au lieu d'avoir le code suivant :
if Reponse = 'o'
then Put("Vous avez bien de la chance.") ;
end if ;
Nous allons donc écrire :
if Reponse = 'o'
then Put("Vous avez bien de la chance.") ;
else Put ("Ha ... Dommage. ") ;
end if ;
Désormais, si l'utilisateur répond non (n), il recevra tout de même une réponse, différente qui plus est ! :soleil:
Et que se passerait-t-il si l'utilisateur tapait une autre lettre, comme z par exemple ?
Pour avoir la réponse reprenons notre code ! Celui-ci ne teste qu'une seule égalité : la variable Reponse est-elle égale à 'o' ? Donc si Reponse vaut 'z', le programme apportera la même réponse que si elle vaut 'n', 'a', '@' ou autre ! Dit différemment, nous n'avons pas envisagé tous les cas. L'utilisateur peut tout à fait répondre autre chose que oui ou non. :waw: Et là vous vous demandez s'il n'existerait pas une troisième instruction après then et else. Eh bien non. Pour envisager d'avantage de cas, il va falloir ruser.
L'astuce (pas si compliquée d'ailleurs) est de réaliser plusieurs tests :
SI la réponse est oui
ALORS AFFICHER ("Vous avez bien de la chance")
SINON SI la réponse est non
ALORS AFFICHER("Ah ... Dommage.")
SINON Afficher("C'est pas une réponse ça !")
Il est en effet possible d'imbriquer plusieurs instructions if les unes dans les autres :
if Reponse = 'o'
then Put("Vous avez bien de la chance"); --cas où la réponse est oui
else if Reponse = 'n'
then Put("Ah ... Dommage."); --cas où la réponse est non
else Put("C'est pas une réponse ça !"); --cas où la réponse est... autre chose
end if ;
end if ;
Et voilà le tour est joué ! Allez, plus compliqué, si l'utilisateur répond 'p' (pour "p'têt bin que oui, p'têt bin que non") on affiche le message "Reponses normandes non valides". A vous de jouer :
if Reponse = 'o'
then Put("Vous avez bien de la chance");
else if Reponse = 'n'
then Put("Ah ... Dommage.");
else if Reponse = 'p'
then Put("Reponses normandes non valides");
else Put("C'est pas une réponse ça !");
end if ;
end if ;
end if ;
Alors vous avez réussi ? Bien joué ! Regardez toutefois le code que je vous propose : à chaque nouveau then/else, j'ai ajouté une tabulation (ou 3 espaces avec Adagide). Nous avons déjà vu cette pratique, elle s'appelle l'indentation et elle n'est pas anodine car elle vous permettra de proposer un code aéré, organisé et donc facilement lisible par vous ou un tiers. Prenez cette habitude le plus tôt possible ! C'est un conseil que je ne cesserai de vous répéter.
Toutefois vous avez du vous rendre compte que cela devient vite fatiguant d'écrire plusieurs end if et d'augmenter de plus en plus le nombre de tabulations pour avoir un code bien indenté. Heureusement zorro est arrivé :zorro: Oups. Non, heureusement les instructions else if peuvent être remplacées par une autre : elsif !
Ah ........... Et ça change quoi ? (À part une lettre en moins)
Et bien, observez par vous-même :
if Reponse = 'o'
then Put("Vous avez bien de la chance");
elsif Reponse = 'n'
then Put("Ah ... Dommage.");
elsif Reponse = 'p'
then Put("Reponses normandes non valides");
else Put("C'est pas une réponse ça !");
end if ;
Plus besoin de multiplier les end if, du coup chaque instruction elsif se présente comme un "prolongement" du if initial, limitant ainsi l'indentation.
Mais il y a une instruction encore plus lisible et particulièrement appropriée pour des choix multiples.
Cette nouvelle instruction s'appelle case. Comme son nom l'indique (si vous êtes un peu anglophone), elle permet de traiter différents CAS (= case). Alors pour la beauté de l'art, nous allons nous ajouter un cas supplémentaire : si l'utilisateur appuie sur 'f' (pour "I don't speak French" = "Je ne parle pas Français" pour les anglophobes). Et en route pour l'aventure !
case Reponse is --on indique que l'on va regarder les différents cas possibles pour Reponse
when 'o' => Put("Vous avez bien de la chance.") ; -- si oui
when 'n' => Put("Ah ... dommage. ") ; -- si non
when 'p' => Put("Reponses normandes non valides") ; -- si peut-être
when 'f' => Put("J'aurais pas du prendre Allemand ...") ; -- si "not French"
when others => Put("C'est pas une reponse.") ; -- si autre chose
end case ; -- on termine notre instruction comme avec if !
Cette nouvelle instruction a des avantages : plus compacte, elle est donc plus claire, plus lisible et surtout plus rapide à taper lorsque les choix s'avèrent nombreux. Elle présente toutefois des limites que nous verrons dans les prochaines parties.
Pour l'instant regardons la structure. La portion de code ci-dessus (on parlera de bloc) est introduite de la même manière que la procédure de votre programme : Procedure Questionnaire is. Elle se termine par end case. Les flèches sont faites du signe égal (=) suivi du signe "supérieur à" (>). Rappelons enfin que le mot when signifie QUAND et que le mot others signifie AUTRE (n'utilisez l'instruction when others qu'après avoir traité tous les cas).
Vous avez bien compris ? Alors rien ne vous empêche de trouver d'autres réponses farfelues pour vous exercer (pensez toutefois à indiquer ces nouvelles réponses possibles à l'utilisateur). Je vous invite à reprendre les parties précédentes si vous avez encore quelques doutes car la partie suivante sera un poil plus compliquée. ;)
En effet, nous pensions avoir fini notre programme, qu'il couvrait tous le choix possibles etc ... Eh bien non. Que se passera-t-il si l'utilisateur tape 'O' au lieu de 'o', ou bien 'N' au lieu de 'n' ? Pour l'ordinateur, un "n" minuscule et un "N" majuscule sont deux valeurs différentes. Il considèrera que c'est une mauvaise réponse et répondra "C'est pas une reponse" !
On va devoir créer 4 nouveaux cas pour les majuscules ? :(
Non, rassurez-vous. Mais nous allons toutefois devoir faire un peu de logique : c'est ce qu'on appelle l'algèbre booléenne. :p Nous n'aborderons pas l'algèbre booléenne dans ce chapitre. Si certaines choses ne sont pas claires, je vous conseille de relire ce chapitre car le suivant s'avèrera plus compliqué.
Tous nos tests jusque là se contentaient de vérifier une égalité. Or il est possible d'utiliser d'autres symboles mathématiques appelés opérateurs de comparaison. En voici un liste :
Opérateur
Signification
=
"est égal à"
/=
"est différent de"
<
"est plus petit que"
>
"est plus grand que"
<=
"est plus petit ou égal à"
>=
"est plus grand ou égal à"
Ainsi notre programme initial peut-être modifié de la manière suivante :
AFFICHER "Combien d'ordinateurs avez-vous?"
SAISIR la réponse
SI la réponse est supérieure ou égal à 2
ALORS AFFICHER "Génial"
SINON AFFICHER "C'est toujours ca"
D'où le programme suivant :
Procedure Questionnaire2 is
Reponse : integer := 0 ; --on définit la réponse et on l'initialise à 0
begin
Put("Combien d'ordinateurs avez-vous?") ;
Get(Reponse) ; Skip_line ;
if Reponse >= 2
then Put("Genial!") ;
else Put("C'est toujours ca") ;
end if ;
end Questionnaire2 ;
A noter que la question posée (Reponse est-elle supérieure ou égale à 2) , aussi appelée prédicat peut être remplacée par :
if Reponse>1
then Put("Genial!") ;
else Put("C'est toujours ca") ;
end if ;
Ce nouveau prédicat aura la même conclusion. De même, en inversant les instruction suivant then et else et en écrivant :
if Reponse<=1
then Put("C'est toujours ca") ;
else Put("Genial!") ;
end if ;
ou
if Reponse<2
then Put("C'est toujours ca") ;
else Put("Genial!") ;
end if ;
... on obtiendra également la même chose.
Bien. Nous avons fait un premier tour des conditions en Ada. L'élément le plus important est la suite d'instruction if/then/else, mais n'oubliez pas qu'il existe l'instruction case pour simplifier votre code.
Avec ces quelques instructions en tête, vos programmes devraient dors et déjà prendre un peu de profondeur.
Nous avons vu au précédent chapitre l'existence des instruction if/elsif/case. Mais nous sommes tombés sur un os : nos codes ne prenaient pas en compte les majuscules. Je vous propose donc de repartir du début pour simplifier votre travail de compréhesion. Notre code se résumera à
if Reponse = 'o'
then Put("Vous avez bien de la chance. ") ;
else Put("Ah ... Dommage.") ;
end if ;
L'algèbre booléenne ou algèbre de Boole (du nom du Mathématicien George Boole) est une branche des mathématiques traitant des opérations logiques. Elle a été très utile en électronique (c'est grâce à elle que nos bêtes ordinateurs savent aujourd'hui additionner, multiplier ...) et va nous servir aujourd'hui en programmation.
:euh: Mais ... euh ... je suis nul(le) en Maths ...
Pas de problème, il ne s'agit que de logique, il n'y aura pas de calcul (au sens habituel du terme).
Qu'est-ce qu'un booléen ?
Tout d'abord, lorsque l'on écrit :
if Reponse = 'o'
... il n'y a que deux alternatives possibles : ou cette affirmation est VRAIE (Reponse vaut bien 'o') ou bien elle est FAUSSE (Reponse vaut autre chose). Ces deux alternatives (VRAI/FAUX) sont les deux seules valeurs utilisées en algèbre booléenne. En ada, elles se notent true (VRAI) et false (FAUX).
Un booléen est donc un objet qui vaut soit VRAI soit FAUX. En Ada, cela se déclare de la manière suivante :
A : boolean := true ;
B : boolean := false ;
Il est également possible d'affecter à nos variables booléennes le résultat d'un prédicat :
A := (Reponse = 'o')
Hein ? A prend la valeur contenue dans Reponse ou bien il prend la valeur 'o' ? Et puis c'était pas sensé valoir true ou false ?
La variable A prendra bien comme résultat true ou false et sûrement pas 'o' ! Tout dépend de l'égalité entre parenthèses : si Reponse est bien égal à 'o' alors A vaudra true, sinon il vaudra false.
La condition suivante pourra ainsi s'écrire :
if A
then ...
end if ;
Cela signifie "Si A est vrai alors ...". La variable A remplacera ainsi notre égalité.
Les opérateurs booléen
Voici les quelques "opérations" booléennes que nous allons aborder :
Opérateur
Traduction littérale
Signification
Not
Non
Not A : "il faut que A ne soit pas vrai"
Or
Ou
A or B : "il faut que A ou B soit vrai"
And
Et
A And B : "il faut que A et B soient vrais"
Xor
Ou exclusif
A xor B : "il faut que A ou B soit vrai mais pas les deux. "
Ce ne sont pas les seuls opérateurs existant en algèbre booléenne, mais ce sont ceux que vous serez amenés à utiliser en Ada.
Revenons à notre programme. Nous voudrions inverser les deux instructions d'affichage de la manière suivante :
if Reponse = 'o'
then Put("Ah ... Dommage.") ;
else Put("Vous avez bien de la chance. ") ;
end if ;
Chacun comprend que notre programme ne répond plus correctement : si l'utilisateur a plusieurs ordinateurs, le programme lui répond "dommage" !?! Nous devons donc changer la condition : le programme doit afficher "Dommage" seulement SI Reponse ne vaut pas'o' ! La négation d'une instruction booléenne se fait à l'aide de l'instruction not. D'où le code suivant :
if Not Reponse = 'o' -- si la réponse n'est pas Oui
then Put("Ah ... Dommage.") ; -- alors on affiche "Dommage"
else Put("Vous avez bien de la chance. ") ; -- sinon on affiche le second message
end if ;
Le programme fait ainsi de nouveau ce qu'on lui demande. Retenez cette astuce car il arrive souvent que l'on se trompe dans la condition ou l'ordre des instructions entre then et else, notamment quand les conditions deviennent plus complexes.
Un peu d'algèbre booléenne maintenant :
Si A est vrai, alors Non A est faux. Si A = true alors Not A = false.
Si A est faux, alors Non A est vrai. Si A = false alors Not A = true.
Quelle que soit la valeur du booléen A, Non Non A = A (Not not A = A)
Nous avons vu dans la partie précédente que le code suivant ne gérait pas les majuscules :
if Reponse = 'o'
then Put("Vous avez bien de la chance. ") ;
else Put("Ah ... Dommage.") ;
end if ;
Il faudrait poser la condition "SI la réponse est o ou O". C'est à dire qu'il suffirait que l'une des deux conditions soit remplie pour que le programme affiche que vous avez de la chance. Pour cela, on utilise l'instruction or (OU en Français).
if Reponse = 'o' or Reponse = 'O'
then Put("Vous avez bien de la chance. ") ;
else Put("Ah ... Dommage.") ;
end if ;
Encore un peu d'algèbre booléenne : si A et B sont deux propositions (vraies ou fausses) l'instruction "A ou B" sera vraie dans les trois cas suivants :
si A est vrai
si B est vrai
si les deux sont vrais
L'instruction and
Nouveau jeu ! Inversons, comme dans la partie précédente, les instructions d'affichage. Nous devrions alors écrire une négation :
if not(Reponse = 'o' or Reponse = 'O')
then Put("Ah ... Dommage.") ;
else Put("Vous avez bien de la chance. ") ;
end if ;
Vous vous souvenez de la partie sur l'instruction Not ? Nous avons fait la même chose : puisque l'on a inversé les instructions d'affichage, nous écrivons une négation dans le prédicat. Mais cette négation peut aussi s'écrire :
if not Reponse = 'o' and not Reponse = 'O'
then Put("Ah ... Dommage.") ;
else Put("Vous avez bien de la chance. ") ;
end if ;
L'opérateur And signifie ET. Il implique que les deux conditions doivent être remplies en même temps :
Reponse ne vaut pas 'o'
ET
Reponse ne vaut pas non plus 'O'
Encore de l'algèbre booléenne.
si A est VRAI et B est FAUX alors A et B est FAUX
si A est VRAI et B est VRAI alors A et B est VRAI
si A est FAUX et B est FAUX alors A et B est FAUX
De manière schématique, retenez que la négation d'un OU est ET. Le contraire de VRAI OU VRAI est donc FAUX ET FAUX. Bon, je crois qu'il est temps d'arrêter car certains méninges doivent commencer à griller. :p Je vous invite donc à méditer ce que vous venez de lire.
Il nous reste une opération à voir, l'opération xor. Nous ne nous attarderons pas dessus car je préfèrerais que vous reteniez déjà ce que nous venons de voir sur Not, Or et And. Toutefois, si vous voulez en savoir plus, rappelons que la phrase "A ou B" sera vraie dans trois cas :
si A est vrai
si B est vrai
si A et B sont vrais tous les deux
Or il existe des cas où il ne faut pas que les deux conditions soient vraies en même temps. Au lieu d'écrire "(A ou B) et pas (A et B)", il existe l'opération OU EXCLUSIF (xor). Pour que "A xor B" soit vrai il faut que :
Maintenant que nous avons vu les opérateurs booléens, Vous pourriez reprendre votre programme Questionnaire pour qu'il puisse gérer aussi les majuscules.
Avec des elsif :
if Reponse = 'o' or Reponse = 'O'
then Put("Vous avez bien de la chance.") ;
elsif Reponse = 'n' or Reponse = 'N'
then Put("Ah ... dommage. ") ;
elsif Reponse = 'p' or Reponse = 'P'
then Put("Reponses normandes non valides") ;
elsif Reponse = 'f' or Reponse = 'F'
then Put("J'aurais pas du prendre Allemand ...") ;
else Put("C'est pas une reponse.") ;
end if ;
Il suffit juste de compléter les blocs if/elsif avec une instruction or. :)
Avec un case (un poil plus dur ; la solution proposée comporte une astuce) :
case Reponse is
when 'o' | 'O' => Put("Vous avez bien de la chance.") ; -- si oui
when 'n' | 'N' => Put("Ah ... dommage. ") ; -- si non
when 'p' | 'P' => Put("Reponses normandes non valides") ; -- si peut-être
when 'f' | 'F' => Put("J'aurais pas du prendre Allemand ...") ; -- si "not French"
when others => Put("C'est pas une reponse.") ; -- si autre chose
end case ;
Durant vos essais vous avez du remarquer que lors de l'instruction when il n'est pas possible de faire appel aux opérateurs booléens. Pour remplacer l'instruction or, il suffit d'utiliser le symbole "|" (Alt gr + touche du 6). Oui, je sais j'ai triché, vous ne pouviez pas le deviner. :euh:
Cette ultime partie doit être vue comme un complément. Elle est plutôt théorique et s'adresse à ceux qui maîtrisent ce qui précède (ou croient le maîtriser :diable: ). Si vous débutez, jetez-y tout de même un œil pour avoir une idée du sujet, mais ne vous affolez pas si vous ne comprenez rien : cela ne vous empêchera pas de suivre la suite de ce cours et vous pourrez revenir dessus plus tard, lorsque vous aurez gagné en expérience (pas avant d'être Warrior level 35 avec 500Hp :magicien: ).
Priorités avec les booléens
Si vous avez atteint au moins la cinquième, vous ne devriez pas être sans savoir ce qu'est une priorité dans un calcul. Par exemple, dans le calcul le résultat est ...
Euh... :euh: 45 ?
Argh ! :colere: Non ! Le résultat est 25 ! En effet, on dit que la multiplication est prioritaire sur l'addition, ce qui signifie qu'elle doit être faite en premier (sauf indication contraire à l'aide de parenthèses qui, elles, sont prioritaires sur tout le monde). Eh bien des règles de priorités existent également en algèbre booléenne. Découvrons-les sur quelques exemples :
je viendrai : si Albert ET Bernard viennent OU si Clara vient
Cela revient à écrire : A AND B OR C. Mais que doit-on comprendre ? (A AND B) OR C ou alors A AND (B OR C) ? Quelle opération est prioritaire AND ou OR ? Réfléchissons à notre exemple, si Clara est la seule à venir, tant pis pour Albert et Bernard, je viens.
Dans le cas (A AND B) OR C : les parenthèses m'obligent à commencer par le AND. Or, A et B sont faux tous les deux (Albert et Bernard ne viennent pas) donc (A AND B) est faux. Nous finissons avec le OR : la première partie est fausse mais C est vrai (Clara vient pour notre plus grand bonheur), donc le résultat est Vrai ! Je viens ! A priori, cette écriture correspondrait.
Dans le cas A AND (B OR C) : les parenthèses m'obligent à commencer par le OR. B est faux (Bernard ne vient pas) mais C est vrai (Clara vient :honte: ) donc (B OR C) est vrai. Nous finissons avec le AND : la deuxième partie est vraie et A est faux(Albert ne vient pas), donc le résultat est... Faux ! Je suis sensé ne pas venir ! Apparemment, cette écriture ne correspond pas à ce que l'on était sensé obtenir.
Conclusion ? Il faut commencer par le AND. Si nous enlevons les parenthèses, alors AND est prioritaire sur OR. Le ET peut être comparé à la multiplication ; le OU peut être comparé à l'addition.
Et XOR et NOT ?
XOR a la même priorité que OR, ce qui est logique. Pour NOT, retenez qu'il ne s'applique qu'à un seul booléen, il est donc prioritaire sur les autres opérations. Si vous voulez qu'il s'applique à toute une expression, il faudra user des parenthèses.
Ordre de test
L'intérêt de if, n'est pas seulement de distinguer différents cas pour appliquer différents traitements. Il est également utile pour éviter des erreurs qui pourraient engendrer un plantage en bonne et due forme de votre programme. Par exemple, prenons une variable n de type natural : elle ne peut pas (et ne doit pas) être négative. Donc avant de faire une soustraction, on s'assure qu'elle est suffisamment grande :
if n >= 5
then n := n - 5 ;
end if ;
Ce que nous allons voir ici a notamment pour intérêt d'éviter des tests qui engendreraient des erreurs. Nous reviendrons dessus durant les chapitres sur les tableaux et les pointeurs pour illustrer mon propos. Nous resterons ici dans la théorie. Supposons que nous voulions ordonner nos tests :
Vérifie si A est vrai ET SEULEMENT SI C'EST VRAI, vérifie si B est vrai
Quel intérêt ? Je ne rentrerai pas dans un exemple en programmation, mais prenons un exemple de la vie courante. Que vaut-il mieux faire :
Vérifier si ma sœur qui est ceinture noire de judo n'est pas sous la douche ET vérifier si il y a encore de l'eau chaude. ou Vérifier si ma sœur qui est ceinture noire de judo est sous la douche ET SEULEMENT SI ELLE N'EST PAS SOUS LA DOUCHE vérifier si il y a encore de l'eau chaude.
Les vicieux tenteront la première solution et finiront avec une pomme de douche greffée à la place de l'oreille. Les prudents opteront pour la deuxième solution. Autrement dit, en programmation, la première méthode peut occasionner un plantage, pas la seconde. Maintenant comment implémenter cela en Ada ?
if A=true AND THEN B=true --remarque : il n'est pas utile d'écrire "=true"
THEN ...
ELSE ...
END IF ;
Ainsi, on ne testera le prédicat "B=true" que si auparavant A était vrai. Autre possibilité :
Vérifie si A est vrai OU SI CE N'EST PAS VRAI, vérifie si B est vrai
Exemple de la vie courante. Vaut-il mieux :
Vérifier si il y a des steaks hachés dans le frigo ou chez le voisin. ou Vérifier si il y a des steaks hachés dans le frigo ou, SI VRAIMENT ON A TOUT FINI HIER aller vérifier chez le voisin.
Je ne sais pas vous, mais avant d'aller demander au voisin, je regarde si je n'ai pas ce qu'il faut dans mon frigo. Idem en programmation, si l'on peut économiser du temps-processeur et de la mémoire, on ne s'en prive pas. Donc pour implémenter cela, nous écrirons :
if A=true OR ELSE B=true --remarque : il n'est pas utile d'écrire "=true"
THEN ...
ELSE ...
END IF ;
Les mots réservés then et else peuvent donc, s'ils sont combinés respectivement avec and et or, être utilisés au moment du prédicat. Cela vous montre toute la souplesse du langage Ada cachée sous l'apparente rigidité.
L'algèbre booléenne peut vite s'avérer compliquée. Toutefois retenez l'existence de not/or/and. Ces trois opérateurs vous serviront régulièrement et permettront d'effectuer des tests plus complexes.
Nous avons terminé le chapitre sur les conditions qui était quelque peu ardu. Maintenant nous allons nous intéresser à un nouveau problème : nos programmes auront souvent besoin de répéter plusieurs fois la même action et il est hors de question de jouer du copier/coller ! Notre code doit rester propre et clair.
C'est pourquoi ont été créées les boucles. Il s'agit d'une nouvelle instruction qui va répéter autant de fois qu'on le souhaite une même opération. Intéressé ? ;) Pour comprendre tout cela, nous allons créer un programme appelé Ligne qui afficherait une ligne de '#' (leur nombre étant choisi par l'utilisateur). La structure de notre programme devrait donc ressembler à cela :
With ada.Text_IO, ada.Integer_Text_IO ;
Use ada.Text_IO, ada.Integer_Text_IO ;
Procedure Ligne is
Nb : integer ;
begin
Put("Combien de dièses voulez-vous afficher ?") ;
Get(Nb) ; Skip_line ;
--Bloc d'affichage
end Ligne ;
Avec ce que nous avons vu pour l'instant, nous aurions tendance à écrire notre bloc d'affichage ainsi :
case Nb is
when 0 => Null ; --ne rien faire
when 1 => Put("#") ;
when 2 => Put("##") ;
when 3 => Put("###") ;
when 4 => Put("####") ;
when 5 => Put("#####") ;
when others => Put("######") ;
end case ;
Le souci c'est que l'utilisateur peut très bien demander 21 dièses ou 24 et que nous n'avons pas tellement envie d'écrire tous les cas possibles et imaginables. :colere: Nous allons donc prendre le parti de n'afficher les # que un par un, et de répéter l'action autant de fois qu'il le faudra. Pour cela nous allons utiliser l'instruction loop que nous écrirons dans le bloc d'affichage.
loop --début des instructions qu'il faut répéter
Put('#') ;
end loop ; --indique la fin des instruction à répéter
Ceci définit une boucle qui répètera à l'infini tout ce qui est écrit entre loop et end loop . Génial non ?
Et ça s'arrête quand ta boucle ?
Euh ... en effet, si vous avez tester ce code, vous avez du vous rendre compte que cela ne s'arrête jamais (ou presque). Ce qui est écrit au-dessus est une boucle infinie ! C'est la grosse erreur de débutant. :-° (Bien que les boucles infinies ne soient pas toujours inutiles) Pour corriger cela, nous allons déclarer une variable appelée compteur.
Compteur : integer := 0 ;
Cette variable vaut 0 pour l'instant mais nous l'augmenterons de 1 à chaque fois que nous afficherons un dièse, et ce, jusqu'à ce qu'elle soit égale à la variable Nb où est enregistrée le nombre de dièses voulus. On dit que l'on incrémente la variable Compteur. Voici donc deux corrections possibles :
loop
if Compteur = Nb
then exit ; --si on a déjà affiché assez de dièses, alors on "casse" la boucle
else Put('#') ; --sinon on affiche un dièse et on incrémente Compteur
Compteur := Compteur +1 ;
end if ;
end loop ;
loop
exit when Compteur = Nb ; --comme tout à l'heure, on sort si on a affiché assez de dièses
Put('#') ; --on peut tranquillement afficher un dièse, car si le nombre était atteint, la boucle serait déjà cassée
Compteur := Compteur +1 ; --et on n'oublie pas d'incrémenter
end loop ;
L'instruction exit permet de "casser" la boucle et ainsi d'y mettre fin. Dans ce cas, il est important de faire le test de sortie de boucle avant d'afficher et d'incrémenter afin de permettre de tracer une ligne de zéros dièses. C'est aussi pour cela que Compteur est initialisé à 0 et pas à 1. Si l'on exige l'affichage d'au moins un dièse, alors l'ordre dans la boucle peut être modifié. Toutefois, vous devez réfléchir à l'ordre dans lequel les opérations seront effectuées. Exemple si l'utilisateur tape 3 :
Valeur de Compteur
Test de sortie
Affichage
Incrémentation
0
Négatif
#
+1
1
Négatif
#
+1
2
Négatif
#
+1
3
Positif
STOP
STOP
On affichera bien 3 dièses (pas un de moins ou de plus). Pensez notamment à tester les valeurs extrêmes : 0,1, la valeur maximale si elle existe ...
Le second code a, ici, ma préférence car plus simple et plus lisible. Bien sûr le premier peut être décliné à l'infini en variant : if, elsif, case ... Il n'est d'ailleurs pas impossible d'écrire plusieurs instructions donnant lieu à l'instruction exit. Une autre variante (plus compacte) serait de ne pas utiliser de variable Compteur et de décrémenter la variable Nb au fur et à mesure (décrémenter = soustraire 1 à chaque tour de boucle) :
loop
exit when Nb = 0 ; -- Si Nb vaut 0 on arrête tout
Nb := Nb - 1 ; -- On n'oublie pas de décrémenter ...
Put('#') ; -- ... et surtout d'afficher notre dièse !
end loop ;
Cette dernière méthode est encore plus efficace. N'oubliez pas que lorsque vous créez une variable, elle va monopoliser de l'espace mémoire. Si vous pouvez vous passer d'une d'entre elles, c'est autant d'espace mémoire qui sera dégagé pour des tâches plus importantes de votre programme (ou d'un autre). Qui plus est, votre code gagnera également en lisibilité.
Mais il y a mieux encore : pour nous éviter d'exécuter un test de sortie au milieu de notre boucle, il existe une variante à notre instruction loop : While ... loop ! En Anglais, while signifie "tant que" ; cette boucle se répètera donc tant que le prédicat inscrit dans les pointillés sera vérifié. Exemple :
while Compteur /= Nb loop
Compteur := Compteur +1 ;
Put('#') ;
end loop ;
Autre possibilité (sans déclarer de variable Compteur) :
while Nb /= 0 loop
Nb := Nb - 1 ;
Put('#') ;
end loop ;
Les programmeurs sont des gens plutôt fainéants : s'ils peuvent limiter les opérations à effectuer, ils les limitent ! Et ça tombe bien : nous aussi ! :D C'est pourquoi ils ont inventé une autre variante de loop qui leur permet de ne pas avoir à incrémenter eux même et de s'épargner la création d'une variable Compteur : la boucle for ... loop ! L'exemple en image :
for i in 1..Nb loop
put("#") ;
end loop ;
Ca c'est du condensé, hein ? Mais que fait cette boucle ? Elle se contente d'afficher des # plusieurs fois.
Ce n'est pas une boucle infinie ?
Et non ! Car elle utilise une variable qui lui sert de compteur : i. Plusieurs avantages : tout d'abord cette variable i n'a pas besoin d'être déclarée, elle est automatiquement créée puis détruite pour cette boucle (et uniquement pour cette boucle, i sera inutilisable après). Pas besoin non plus de l'incrémenter (c'est à dire écrire une ligne "i := i +1 ;") la boucle s'en charge toute seule, contrairement à beaucoup de langage d'ailleurs (comme le C). Pas besoin enfin d'effectuer des tests avec if, when ou case qui alourdissent le code. ^^
Vous vous demandez comment tout cela fonctionne ? C'est simple. Lorsque l'on écrit "for i in 1..Nb loop" :
for indique le type de boucle
i est le nom de la variable remplaçant Compteur (je n'ai pas réutilisé la variable Compteur car celle-ci nécessitait d'être préalablement déclarée, ce qui n'est pas le cas de i, je le rappelle)
in 1..Nb indique "l'intervalle" dans lequel la variable i va varier. Elle commencera avec la valeur 1, puis à la fin de la boucle elle prendra la valeur 2, puis 3 ... jusqu'à la valeur Nb avec laquelle elle effectuera la dernière boucle. (Pour les matheux : je mets "Intervalle" entre guillemets car il s'agit d'un "intervalle formé d'entiers seulement" et non de nombres réels)
loop indique enfin le début de la boucle
Tu nous as dit de vérifier les valeurs extrèmes, mais que se passera-t-il si Nb vaut 0 ?
C'est simple, il ne se passera rien. La boucle ne commencera jamais. En effet, "l'intervalle" 1..Nb est ce que l'on appelle un "integer'range" en Ada et les bornes 1 et Nb ne sont pas interchangeables dans un integer'range (intervalle fait d'entiers). La borne inférieure est forcément 1, la borne supérieur est forcément Nb. Si Nb vaut 0, alors la boucle for passera en revue tous les nombres entiers (integer) supérieurs à 1 et inférieurs à 0. Comme il n'en n'existe aucun, le travail sera vite fini.
Quant au cas Nb = 1, l'integer'range 1..1 contient un nombre : 1 ! Donc la boucle for ne fera qu'un seul tour de piste ! :magicien: Magique non ?
Et si je voulais faire le décompte "en sens inverse" ? En décrémentant plutôt qu'en incrémentant ?
En effet, comme vous l'avez sûrement compris, la boucle for parcourt l'intervalle 1..nb en incrémentant sa variable i, jamais en la décrémentant. Ce qui fait que si Nb est plus petit que 1, alors la boucle n'aura pas lieu. Si vous souhaitez faire "l'inverse", parcourir l'intervalle en décrémentant, c'est possible, il suffira de le spécifier avec l'instruction reverse. Cela indiquera que vous souhaitez parcourir l'intervalle "à l'envers", "à rebours". Voici un exemple :
for i in reverse 1..nb loop
...
end loop ;
Attention, si Nb est plus petit que 1, la boucle ne s'exécutera toujours pas !
Nous allons, dans cette partie, remonter aux origines des boucles et voir une instruction qui existait bien avant l'apparition des loop. C'est un héritage d'anciens langages, elle n'est guère utilisée aujourd'hui. C'est donc à une séance d'archéologie (voire de paléontologie) informatique à laquelle je vous invite dans cette partie en allant à la découverte de l'instruction goto (ou gotosaurus). :lol:
Cette instruction goto est la contraction des deux mots "go to" qui signifient "aller à". Elle va renvoyer le programme à une balise que le programmeur aura placé en amont dans son code. Cette balise est un mot quelconque que l'on aura écrit entre << ... >>. Exemple :
<<debut>> --on place une balise appelée "debut"
Put('#') ;
goto debut ; --cela signifie "maintenant tu retournes à <<debut>>"
Bien sûr il est préférable d'utiliser une condition pour éviter de faire une boucle infinie :
<<debut>>
if Compteur <= Nb
then Put('#') ;
Compteur := Compteur + 1 ;
goto debut ;
end if ;
Cette méthode est très archaïque (elle était présente en Basic en 1963 et fut très critiquée car elle générait des codes de piètre qualité). A noter que dans le dernier exemple l'instruction goto se trouve au beau milieu de notre instruction if ! Difficile de voir rapidement où seront les instructions à répéter, d'autant plus qu'il n'existe pas de end loop. Cette méthode est donc à proscrire, préférez-lui une belle boucle loop, while ou for (quoique goto m'ait déjà sauvé la mise deux ou trois fois :-° ).
Nous voudrions maintenant créer un programme appelé Carre qui afficherait un carré de '#' et non plus seulement une ligne.
Méthode avec une seule boucle (plutôt mathématique)
Une première possibilité est de se casser la tête. Si on veut un carré de côté n, alors cela veut dire que le carré aura n lignes et n colonnes, soit un total de n x n = n² dièses.
Donc nous pourrions utiliser une boucle allant de 1 à Nb² (de 1 à 25 pour notre exemple) et qui afficherait un retour à la ligne de temps en temps.
Il faudra donc une boucle du type "for i in 1..Nb²" plus un test du type "if i mod Nb = 0" dans la boucle pour savoir si l'on doit aller à la ligne. A vous d'essayer.
with ada.Text_IO, ada.Integer_Text_IO ;
use ada.Text_IO, ada.Integer_Text_IO ;
procedure Carre is
Nb : integer ;
Begin
Put("Quel est le cote de votre carre ? ") ;
Get(Nb) ; Skip_line ;
for i in 1..Nb**2 loop --Nb**2 est la notation du carré, on peut aussi écrire Nb*Nb
Put('#') ; --on affiche le dièse
if i mod Nb = 0 --Si i est multiple de Nb = Si on a déjà affiché toute une ligne
then New_line ; --On retourne à la ligne
end if ;
end loop ;
end Carre ;
Vous avez :
compris ? Très bien, vous devez avoir l'esprit scientifique.
absolument rien compris ? Pas grave car nous allons justement ne pas faire cela ! C'est en effet un peu compliqué et ce n'est pas non plus naturel comme façon de coder.
Méthode avec deux boucles (plus naturelle)
La méthode précédente est quelque peu tirée par les cheveux mais constitue toutefois un bon exercice pour manipuler les opérations puissance (Nb**2) et modulo (i mod Nb). Voici une méthode plus intuitive, elle consiste à imbriquer deux boucles l'une dans l'autre de la manière suivante :
Boucle1
Boucle2
fin Boucle2
fin Boucle1
La Boucle2 sera chargée d'afficher les dièses d'une seule ligne. La Boucle1 sera chargée de faire défiler les lignes. À chaque itération, elle relancera la Boucle2 et donc affichera une nouvelle ligne. D'où le code suivant :
with ada.Text_IO, ada.Integer_Text_IO ;
use ada.Text_IO, ada.Integer_Text_IO ;
procedure Carre is
Nb : integer ;
Begin
Put("Quel est le cote de votre carre ? ") ;
Get(Nb) ; Skip_line ;
for i in 1..Nb loop --Boucle chargée d'afficher toutes les lignes
for j in 1..Nb loop --Boucle chargée d'afficher une ligne
Put('#') ;
end loop ;
New_line ; --Après avoir affiché une ligne, pensez à retourner à la ligne
end loop ;
end Carre ;
Et voilà le travail ! C'est simple, clair et efficace. Pas besoin d'en écrire des pleines pages ou d'avoir fait Math Sup.
Pourquoi utilises-tu des lettres i, j ... et pas des noms de variable plus explicite ?
Pour trois raisons (assez personnelles) :
Raison 1 : la variable i ou j a un temps de vie très court (restreint à la seule boucle for) elle ne sera pas réutilisée plus tard. Je devrais donc réussir à me souvenir de sa signification jusqu'au end loop.
Raison 2 : la variable i ou j servira très souvent comme indice d'un tableau. Exemple : tableau(i) est la i-ème valeur du tableau. Nous verrons cela dans un prochain chapitre, mais vous pouvez comprendre qu'il est plus simple d'écrire tableau(i) que tableau(Nom_de_variable_long_et_complique).
Raison 3 : j'ai fait une filière mathématiques et en "Maths" on a pour habitude d'utiliser la variable i lorsque l'on traite d'objets ayant un comportement similaire aux boucles. Par exemple lorsque l'on veut effectuer la somme des carrés des nombres entre 1 et n on écrit :
Voilà voilà. :lol: Si maintenant vous voulez vous exercer avec des boucles imbriquées, voici quelques idées d'exercices. Je ne propose pas de solution cette fois. A vous de vous creuser les méninges.
Exercice 1
Afficher un carré creux :
######
# #
# #
# #
# #
######
Exercice 2
Afficher un triangle rectangle :
#
##
###
####
#####
######
Exercice 3
Afficher un triangle isocèle, équilatéral, un rectangle ... ou toute autre figure.
Exercice 4
Rédiger un programme testant si un nombre N est multiple de 2, 3, 4 ... N-1. Pensez à l'opération mod !
Exercice 5
Rédiger un programme qui demande à l'utilisateur de saisir une somme S, un pourcentage P et un nombre d'années T. Ce programme affichera les intérêts accumulés sur cette somme S avec un taux d'intérêt P ainsi que la somme finale, tous les ans jusqu'à la "t-ième" année.
Exercice 6
Créer un programme qui calcule les termes de la suite de Fibonacci. En voici les premiers termes : 0 ; 1 ; 1 ; 2 ; 3 ; 5 ; 8 ; 13 ; 21 ; 34 ; 55 ... Chaque terme se calcule en additionnant les deux précédents, les deux premiers termes étant 0 et 1.
Maintenant que nous avons acquis de bonnes notions sur les boucles et les conditions, nous allons pouvoir nous affairer à un nouveau type de donnée : les tableaux. Le prochain chapitre fera donc appel à tout ce que vous avez déjà vu sur le typage des données (integer, float, ...), les conditions mais aussi et surtout sur les boucles qui révèleront alors toute leur utilité (notamment la boucle for).
Nous avons vu les variables et leurs différents types et opérations, les conditions, les boucles ... autant d'éléments essentiels à tout langage, que ce soit l'Ada, le C, le C++, le Python ... Nous allons maintenant voir comment organiser, hiérarchiser notre code à l'aide des fonctions et des procédures (présentes dans tous les langages elles aussi). Ces éléments nous seront essentiels pour la suite du cours. Mais, rassurez-vous, ce n'est pas bien compliqué ... au début. :D
Vous avez déjà vu maintes fois le terme procédure. Allons, souvenez-vous :
with Ada.Text_IO ;
use Ada.Text_IO ;
procedure Main is
...
begin
...
end Main ;
Et oui ! Votre programme est constitué en fait d'une grande procédure (plus les packages en en-tête, c'est vrai :) ). Donc vous savez dors et déjà comment on la déclare :
Procedure Nom_De_Votre_Procedure is --Partie pour déclarer les variables begin --Partie exécutée par le programme end Nom_De_Votre_Procedure ;
Quel est donc l'intérêt d'en parler si on sait déjà ce que c'est ? o_O
Eh bien pour l'instant, notre programme ne comporte qu'une seule procédure qui, au fil des modifications, ne cessera de s'allonger. Et il est fort probable que nous allons être amenés à recopier plusieurs fois les mêmes bouts de code. C'est à ce moment qu'il devient intéressant de faire appel à de nouvelles procédures afin de clarifier et de structurer notre code. Pour mieux comprendre, nous allons reprendre l'exemple vu pour les boucles : dessiner un rectangle. Voici le code de notre programme :
with Ada.Text_IO, Ada.Integer_Text_IO ;
use Ada.Text_IO, Ada.Integer_Text_IO ;
procedure Figure is
nb_lignes : natural ; --nombre de lignes
begin
Put("Combien de lignes voulez-vous dessiner ?") ; --on demande le nombre de lignes
get(nb_lignes) ; skip_line ;
for i in 1..nb_lignes loop --on exécute deux boucles pour afficher notre rectangle
for j in 1..5 loop
put('#') ;
end loop ;
new_line ;
end loop ;
end Figure ;
Comme vous pouvez le voir, ce programme Figure propose d'afficher un rectangle de dièses. Chaque rectangle comporte 5 colonnes et autant de lignes que l'utilisateur le souhaite.
Nous allons remplacer la deuxième boucle (celle qui affiche les dièses) par une procédure que nous appellerons Affich_Ligne dont voici le code :
Procedure Affich_Ligne is
begin
for j in 1..5 loop
put('#') ;
end loop ;
new_line ;
end Affich_Ligne ;
Euh, c'est bien gentil tout ça, mais je l'écris où ? :euh:
C'est très simple. Le code ci-dessus permet de déclarer au compilateur la sous-procédure Affich_Ligne. Puisqu'il s'agit d'une déclaration, il faut écrire ce code dans la partie réservée aux déclarations de notre procédure principale (avec la déclaration de la variable nb_lignes). Voici donc le résultat :
with Ada.Text_IO, Ada.Integer_Text_IO ;
use Ada.Text_IO, Ada.Integer_Text_IO ;
procedure Figure is
Procedure Affich_Ligne is
begin
for j in 1..5 loop
put('#') ;
end loop ;
new_line ;
end Affich_Ligne ;
nb_lignes : natural ;
begin
Put("Combien de lignes voulez-vous dessiner ?") ;
get(nb_lignes ) ; skip_line ;
for i in 1..nb_lignes loop
Affich_Ligne;
end loop ;
end Figure ;
Vous remarquerez que dans la partie de la procédure principale contenant les instructions, la deuxième boucle, son contenu et le new_line ont disparu et ont laissé la place à un simple "Affich_Ligne ; ". Cette partie devient ainsi plus lisible et plus compacte.
Mouais... :( Bah, écrire tout ça pour gagner 3 lignes dans la procédure principale, moi je dis que c'est pas folichon. :colere2:
N'en jetez plus ! >_ En effet, cela ne semble pas être une opération très rentable, mais je vous invite à continuer la lecture car vous allez vite comprendre l'intérêt des sous-procédures.
Procédure avec un paramètre (ou argument)
Notre programme est pour l'heure très limité : l'utilisateur ne peut pas choisir le nombre de colonnes ! Nous savons facilement (à l'aide de Put et Get) obtenir un nombre de colonnes mais comment faire pour que notre procédure Affich_Ligne affiche le nombre de dièses désiré ? Nous ne pouvons pas effectuer la saisie de la variable Nb_Colonnes dans la procédure Affich_Ligne, car la boucle de la procédure principale demanderait plusieurs fois le nombre de colonnes désiré.
Ah ! C'est malin ! Avec tes histoires, je me suis cassé la tête et en plus je ne peux plus amélioré mon programme ! :colere:
Attendez ! :'( Il y a une solution ! Nous allons demander le nombre de colonnes en même temps que le nombre de lignes et nous allons modifier notre procédure Affich_Ligne pour qu'elle puisse écrire autant de dièses qu'on le souhaite (pas forcément 5). Voici le nouveau code de notre sous-procédure :
Procedure Affich_Ligne(nb : natural) is
begin
for j in 1..nb loop
put('#') ;
end loop ;
new_line ;
end Affich_Ligne ;
Nous avons remplacé "j in 1..5" par "j in 1..nb". La variable nb correspondra bien évidemment au nombre de dièses désirés. Mais surtout, le nom de notre procédure est maintenant suivi de parenthèses à l'intérieur desquelles on a déclaré la fameuse variable nb.
o_O J'ai deux questions : 1- Pourquoi on la déclare pas dans la zone prévue à cet effet ? 2- Ta variable nb n'a jamais été initialisée !
Cette variable nb est ce que l'on appelle un paramètre. Elle n'est pas déclarée dans la "zone prévue à cet effet", ni initialisée, parce qu'elle vient "de l'extérieur". Petite explication : toute variable déclarée entre is et begin a une durée de vie qui est liée à la durée de vie de la procédure. Lorsque la procédure commence, la variable est créée ; lorsque la procédure se termine, la variable est détruite : plus moyen d'y accéder ! Cela va même plus loin ! Les variables déclarées entre is et begin sont inaccessibles en dehors de leur propre procédure ! Elles n'ont aucune existence possible en dehors. Le seul moyen de communication offert est à travers ce paramètre : il permet à la procédure principale d'envoyer le contenu d'une variable dans la sous-procédure.
Voilà pourquoi la variable nb est déclarée entre parenthèses : c'est un paramètre. Quant à sa valeur, elle sera déterminée dans la procédure principale avant d'être "envoyée" dans la procédure "Affich_Ligne()".
Mais revenons à notre procédure principale : Figure. Voilà ce que devient son code :
with Ada.Text_IO, Ada.Integer_Text_IO ;
use Ada.Text_IO, Ada.Integer_Text_IO ;
procedure Figure is
Procedure Affich_Ligne(nb : natural) is
begin
for j in 1..nb loop
put('#') ;
end loop ;
new_line ;
end Affich_Ligne ;
nb_lignes, nb_colonnes : natural;
begin
Put("Combien de lignes voulez-vous dessiner ? ") ;
get(nb_lignes ) ; skip_line ;
Put("Combien de colonnes voulez-vous dessiner ? ") ;
get(nb_colonnes ) ; skip_line ;
for i in 1..nb_lignes loop
Affich_Ligne(nb_colonnes);
end loop ;
end Figure ;
Nous avons ajouté deux lignes pour saisir le nombre de colonnes voulues. L'instruction "Affich_ligne" est devenue "Affich_Ligne(nb_colonnes)". Et voilà ! Notre problème initial est résolu ! :p
Et bah moi je continue à penser que c'était bien plus simple sans sous-procédure ! :colere2:
Procédure avec plusieurs paramètres (ou arguments)
Toujours pas convaincu ? :o Et bien voilà qui devrait mettre fin à vos réticences. Nous allons perfectionner notre programme : il proposera d'afficher soit un rectangle soit un triangle rectangle isocèle (un demi-carré pour les mathophobes ;) ).
Il va donc falloir épurer notre code en créant deux procédures supplémentaires : une pour créer un rectangle (Affich_Rect) et une pour créer le triangle rectangle isocèle (Affich_Tri). Ainsi, notre procédure principale (Figure) se chargera de poser les questions à l'utilisateur, puis elle réorientera vers l'une ou l'autre de ces deux sous-procédures.
La procédure Affich_Rect prendra deux paramètres : le nombre de colonnes et le nombre de lignes.
Procedure Affich_Rect(nb_lignes : natural ; nb_colonnes : natural) is
begin
for i in 1..nb_lignes loop
Affich_Ligne(nb_colonnes);
end loop ;
end Affich_Rect ;
Et maintenant notre procédure Affich_Tri :
Procedure Affich_Tri(nb : natural) is
begin
for i in 1..nb loop
Affich_Ligne(i);
end loop ;
end Affich_Tri ;
L'utilité des procédures commence à apparaître clairement : il a suffit d'écrire "Affich_Ligne(i)" pour que le programme se charge d'afficher une ligne comportant le nombre de dièses voulus, sans que l'on ait à réécrire notre boucle et à se creuser la tête pour savoir comment la modifier pour qu'elle n'affiche pas toujours le même nombre de dièses. Alors, convaincu cette fois ? Je pense que oui. Pour les récalcitrants, je vous conseille d'ajouter des procédures Affich_Carre, Affich_Tri_Isocele, Affich_Carre_Vide ... et quand vous en aurez assez de recopier la boucle d'affichage des dièses, alors vous adopterez les procédures. ;)
Bien ! Il nous reste encore à modifier notre procédure principale. En voici pour l'instant une partie :
begin
Put_line("Voulez-vous afficher : ") ; --On propose les deux choix : rectangle ou triangle ?
Put_line("1-Un rectangle ?") ;
Put_line("2-Un triangle ?") ;
Get(choix) ; skip_line;
Put("Combien de lignes voulez-vous dessiner ? ") ; --on saisit tout de suite le nombre de lignes
get(nb_lignes ) ; skip_line ;
if choix=1 --selon le choix on procède à l'affichage de la figure
then Put("Combien de colonnes voulez-vous dessiner ? ") ;
get(nb_colonnes ) ; skip_line ;
Affich_Rect(nb_lignes, nb_colonnes) ;
else Affich_Tri(nb_lignes) ;
end if ;
end Figure ;
Notre code est tout de même beaucoup plus lisible que s'il comportait de nombreuses boucles imbriquées !
Mais ? Il y a une erreur ! :waw: Pour Affich_Rect, les paramètres doivent être séparés par un point virgule et pas par une virgule ! Rooh la honte ! :diable:
Qu'est-ce qu'une fonction ? C'est peu ou prou la même chose que les procédures. La différence, c'est que les fonctions renvoient un résultat.
Une bête fonction
Pour mieux comprendre, nous allons créer une fonction qui calculera l'aire de notre rectangle. On rappelle (au cas où certains auraient oublié leur cours de 6ème) que l'aire du rectangle se calcule en multipliant sa longueur par sa largeur !
Déclaration
Commençons par déclarer notre fonction (au même endroit que l'on déclare variables et procédures) :
function A_Rect(larg : natural, long : natural) return natural is
A : natural ;
begin
A:= larg * long ;
return A ;
end A_Rect ;
Globalement, cela ressemble beaucoup à une procédure à part que l'on utilise le mot functionau lieu de procedure. Une nouveauté toutefois : l'instruction return. Par return, il faut comprendre "résultat". Dans la première ligne, "return natural is" indique que le résultat de la fonction sera de type natural. En revanche, le "return A" de la 5ème ligne a deux actions :
Il stoppe le déroulement de la fonction (un peu comme exit pour une boucle)
Il renvoie comme résultat la valeur contenue dans la variable A.
A noter qu'il est possible de condenser le code ainsi :
function A_Rect(larg : natural; long : natural) return natural is
begin
return larg * long ;
end A_Rect ;
Utilisation
Nous allons donc déclarer une variable Aire dans notre procédure principale. Puis nous allons changer la condition de la manière suivante :
...
if choix=1
then Put("Combien de colonnes voulez-vous dessiner ? ") ;
get(nb_colonnes ) ; skip_line ;
Affich_Rect(nb_lignes, nb_colonnes) ;
Aire := A_Rect(nb_lignes, nb_colonnes) ;
Put("L'aire du rectangle est de ") ; Put(Aire) ; put_line(" dieses.") ;
else Affich_Tri(nb_lignes) ;
end if ;
...
Notre variable Aire va ainsi prendre comme valeur le résultat de la fonction A_Rect(). D'ailleurs, cela ne vous rappelle rien ? Souvenez-vous des attributs !
c := character'val(153) ;
Ces attributs agissaient comme des fonctions !
Une fonction un peu moins bête (optionnel)
Et l'aire du triangle ?
C'est un peu plus compliqué. Normalement, pour calculer l'aire d'un triangle rectangle isocèle, on multiplie les côtés de l'angle droit entre eux puis on divise par 2. Donc pour un triangle de côté 5, cela fait 5*5/2 = 12,5 dièses !?! Bizarre. Et puis, si l'on fait un exemple :
#
##
###
####
#####
Il y a en fait 15 dièses ! ! ! Pour quelle raison ? Eh bien, ce que nous avons dessiné n'est pas un "vrai" triangle. On ne peut avoir de demi-dièses, de quart de dièses ... La solution est donc un peu plus calculatoire. Remarquez qu'à chaque ligne, le nombre de dièses est incrémenté (augmenté de 1). Donc si notre triangle a pour côté N, pour connaître l'aire, il faut effectuer le calcul : 1 + 2 + 3 + ... + (N-1) + N. Les points de suspension remplaçant les nombres que je n'ai pas envie d'écrire. Comment trouver le résultat ? Astuce de mathématicien. Posons le calcul dans les deux sens :
Calcul n°1
1
+
2
+
3
+
...
+
N-2
+
N-1
+
N
Calcul n°2
N
+
N-1
+
N-2
+
...
+
3
+
2
+
1
Somme des termes
N+1
+
N+1
+
N+1
+
...
+
N+1
+
N+1
+
N+1
En additionnant les termes deux à deux, on remarque que l'on trouve toujours N+1. Et comme il y a N termes cela nous fait un total de : N * (N+1). Mais n'oublions pas que nous avons effectuer deux fois notre calcul. Le résultat est donc : N * (N+1) / 2.
Pour un triangle de côté 5, cela fait 5 * 6 / 2 = 15 dièses ! :soleil: Bon, il est temps de créer notre fonction A_Triangle !
function A_Triangle(N : natural) return natural is
A : natural ;
begin
A:= N * (N+1) / 2 ;
return A ;
end A_Triangle ;
Et voilà ce que donne le code général :
with Ada.Text_IO, Ada.Integer_Text_IO ;
use Ada.Text_IO, Ada.Integer_Text_IO ;
procedure Figure is
Procedure Affich_Ligne(nb : natural) is
begin
for j in 1..nb loop
put('#') ;
end loop ;
new_line ;
end Affich_Ligne ;
Procedure Affich_Rect(nb_lignes : natural ; nb_colonnes : natural) is
begin
for i in 1..nb_lignes loop
Affich_Ligne(nb_colonnes);
end loop ;
end Affich_Rect ;
Procedure Affich_Tri(nb : natural) is
begin
for i in 1..nb loop
Affich_Ligne(i);
end loop ;
end Affich_Tri ;
function A_Rect(larg : natural; long : natural) return natural is
A : natural ;
begin
A:= larg * long ;
return A ;
end A_Rect ;
function A_Triangle(N : natural) return natural is
A : natural ;
begin
A:= N * (N+1) / 2 ;
return A ;
end A_Triangle ;
nb_lignes, nb_colonnes,choix,Aire : natural;
begin
Put_line("Voulez-vous afficher : ") ;
Put_line("1-Un rectangle ?") ;
Put_line("2-Un triangle ?") ;
Get(choix) ; skip_line;
Put("Combien de lignes voulez-vous dessiner ? ") ;
get(nb_lignes ) ; skip_line ;
if choix=1
then Put("Combien de colonnes voulez-vous dessiner ? ") ;
get(nb_colonnes ) ; skip_line ;
Affich_Rect(nb_lignes, nb_colonnes) ;
Aire := A_Rect(nb_lignes, nb_colonnes) ;
Put("L'aire du rectangle est de ") ; Put(Aire) ; put_line(" dieses.") ;
else Affich_Tri(nb_lignes) ;
Aire := A_Triangle(nb_lignes) ;
Put("L'aire du triangle est de ") ; Put(Aire) ; put_line(" dieses.") ;
end if ;
end Figure ;
Bilan
Rendu à ce stade, vous avez du remarquer que le code devient très chargé. Voici donc ce que je vous propose : COMMENTEZ VOTRE CODE ! Exemple :
with Ada.Text_IO, Ada.Integer_Text_IO ;
use Ada.Text_IO, Ada.Integer_Text_IO ;
procedure Figure is
--------------
--PROCEDURES--
--------------
Procedure Affich_Ligne(nb : natural) is
begin
for j in 1..nb loop
put('#') ;
end loop ;
new_line ;
end Affich_Ligne ;
Procedure Affich_Rect(nb_lignes : natural ; nb_colonnes : natural) is
begin
for i in 1..nb_lignes loop
Affich_Ligne(nb_colonnes);
end loop ;
end Affich_Rect ;
Procedure Affich_Tri(nb : natural) is
begin
for i in 1..nb loop
Affich_Ligne(i);
end loop ;
end Affich_Tri ;
-------------
--FONCTIONS--
-------------
function A_Rect(larg : natural; long : natural) return natural is
begin
return larg * long ;
end A_Rect ;
function A_Triangle(N : natural) return natural is
begin
return N * (N+1) / 2 ;
end A_Triangle ;
-------------
--VARIABLES--
-------------
nb_lignes, nb_colonnes,choix : natural;
------------------------
--PROCEDURE PRINCIPALE--
------------------------
begin
Put_line("Voulez-vous afficher : ") ;
Put_line("1-Un rectangle ?") ;
Put_line("2-Un triangle ?") ;
Get(choix) ; skip_line;
Put("Combien de lignes voulez-vous dessiner ? ") ;
get(nb_lignes ) ; skip_line ;
if choix=1
then Put("Combien de colonnes voulez-vous dessiner ? ") ;
get(nb_colonnes ) ; skip_line ;
Affich_Rect(nb_lignes, nb_colonnes) ;
Put("L'aire du rectangle est de ") ; Put(A_Rect(nb_lignes, nb_colonnes)) ; put_line(" dieses.") ;
else Affich_Tri(nb_lignes) ;
Put("L'aire du triangle est de ") ; Put(A_Triangle(nb_lignes)) ; put_line(" dieses.") ;
end if ;
end Figure ;
J'utilise, pour ma part, de gros commentaires afin de structurer mon code. Nous verrons bien plus tard comment créer des packages afin de libérer notre procédure principale. Autre remarque, dans cet exemple j'ai condensé mon code. J'ai notamment écrit : "Put(A_Rect(nb_lignes, nb_colonnes)) ;" ! Il est en effet possible d'imbriquer plusieurs fonctions (ou/et une procedure) les unes dans les autres pour "compacter" votre code. Faites toutefois attention à ce que les types soient compatibles !
Il est possible de donner une valeur par défaut aux paramètres d'une procédure ou d'une fonction. Par exemple :
Procedure Affich_Ligne(nb : natural := 1) is
Ainsi, il sera possible de ne pas spécifier de paramètre. En tapant "Affich_Ligne", le compilateur comprendra tout seul "Affich_Ligne(1)".
Cette astuce est surtout utile pour des fonctions exigeant de nombreux paramètres dont certains seraient optionnels. Imaginons par exemple une fonction Affich_Rect définie comme suit :
On dit qu'il s'agit du prototype de la procédure Affich_Rect(on se moque ici de la façon dont elle est codée). Nous reverrons ce mot lors du chapitre sur les packages et nous expliquerons alors pourquoi le is a été bizarrement remplacé par un point virgule.
Expliquons plutôt les différents paramètres :
nb_lignes et nb_colonnes jouent le même rôle que lors des exemples précédents.
symbole est le caractère qu'il faut afficher pour constituer le rectangle. Auparavant, ce caractère était le dièse (#).
plein est un booléen qui indique si le rectangle est creux (plein vaut false) ou plein (plein vaut true).
affich_a et affich_p sont deux booléens. Si affich_a vaut true, alors le programme affichera l'aire du rectangle. S'il vaut false, alors le programme n'affichera rien. Le paramètre affich_p joue le même rôle mais avec le périmètre au lieu de l'aire.
Nous avons ainsi une procédure vraiment complète. Le seul inconvénient c'est que lorsque l'on veut afficher deux simples rectangles formés de dièses, il faut taper :
Hormis les deux premiers, on ne changera pas souvent les paramètres :( La procédure est complète, mais un peu trop : il faudra retaper souvent la même chose ('#',true,false,false) en prenant garde de ne pas s'emmêler les pinceaux dans l'ordre des variables (très important l'ordre des variables !).
Eh bien moi, c'est certain ! Je ne ferai jamais de procédure trop compliquée ! :-°
Allons ! Cette procédure est très bien, il faut juste identifier les paramètres qui seront optionnels et leur donner une valeur par défaut. Il serait donc plus judicieux de déclarer notre procédure ainsi :
Affich_Rect(5,8) ; --Un simple rectangle 5 par 8
Affich_Rect(7,3,'@') ; --un rectangle 7 par 3 avec des @ à la place des # !
Ah oui, c'est effectivement intéressant. :D Mais si je veux un rectangle 5 par 8 classique en affichant le périmètre, je peux taper ça ?
Affich_Rect(5,8,true) ;
Mais je fais quoi alors ? :'(
C'est vrai que dans ce cas, on a un souci. Il nous faut respecter l'ordre des paramètres mais certains ne sont pas utiles. Heureusement, il y a un solution ! :ange:
Affich_Rect(5,8,affich_p => true) ;
Il suffit de spécifier le paramètre auquel on attribue une valeur ! Attention, on n'utilise pas le symbole " := " mais la flèche " => ". Ainsi, l'ordre n'a plus d'importance, on pourrait tout aussi bien noter :
Nous avons vu précédemment que les paramètres d'une fonction ou d'une procédure ne peuvent pas (et ne doivent pas) être modifiés durant le déroulement de la fonction ou de la procédure. Eh bien ... c'est faux ! Enfin non ! C'est vrai, mais disons qu'il y a un moyen de contourner cela pour les procédures.
procedure Affich_Rect(nb_lignes : in natural, nb_colonnes : in natural)is
Les instructions in indiquent que nos paramètres sont uniquement des paramètres d'entrée. Les emplacements-mémoire qui contiennent leur valeur peuvent être lus mais il vous est interdit d'y écrire : ils ne sont accessibles qu'en lecture. Donc impossible d'écrire "nb_lignes := 5" au cours de cette procédure.
Mode out
En revanche, en écrivant ceci :
procedure Affich_Rect(nb_lignes : out natural, nb_colonnes : out natural) is
... vos paramètres deviendront des paramètres de sortie. Il sera possible d'écrire dans les emplacements-mémoire réservés à nb_lignes et nb_colonnes ! Génial non ? Sauf qu'il vous sera impossible de lire la valeur initiale, donc impossible d'effectuer des tests par exemple. :( Vos paramètres ne sont accessibles qu'en écriture.
Mode in out
Heureusement, il est possible de mélanger les deux :
procedure Affich_Rect(nb_lignes : in out natural, nb_colonnes : in out natural) is
Nous avons alors des paramètres d'entrée et de sortie, accessibles en lecture ET en écriture ! Tout nous est permis ! :p
Pourquoi tous les paramètres ne sont-ils pas en mode in out par défaut ?
Réfléchissons à notre procédure Affich_Rect : est-il judicieux que nos paramètres nb_lignes et nb_colonnes soient accessibles en écriture ? Je ne pense pas. Notre procédure n'a pas besoin de les modifier et il ne serait pas bon qu'elle les modifie. Les laisser en mode in, c'est prendre l'assurance que nos paramètres ne seront pas modifiés (sinon, le rigoureux compilateur GNAT se chargera de vous rappeler à l'ordre :pirate: ). Et réciproquement, des paramètres en mode out n'ont pas à être lu. Un exemple ? Une procédure dont l'un des paramètres s'appellerait Ca_Marche et servirait à indiquer si il y a eu un échec du programme ou pas. Notre procédure n'a pas à lire cette variable, cela n'aurait pas de sens. Elle doit seulement lui affecter une valeur. C'est pourquoi vous devrez prendre quelques secondes de réflexion avant de choisir entre ces différents modes et notamment pour le mode in out.
Bien, nous savons maintenant comment mieux organiser nos codes en Ada. Cela nous permettra de créer des programmes de plus en plus complexes sans perdre en lisibilité. Nous reviendrons plus tard sur les fonctions et procédures pour aborder une méthode très utile en programmation : la récursivité. Mais cette partie étant bien plus compliquée à comprendre, nous allons pour l'heure laisser reposer ce que nous venons de voir.
Lors du prochain chapitre théorique nous aborderons un nouveau type : les tableaux ! Mais nous entrons alors dans un nouvel univers (et une nouvelle partie) : l'univers de la programmation orientée objet ou POO ! Je conseille donc à ceux qui ne seraient pas encore au point de revoir les chapitres de la seconde partie.
Mais avant tout cela, il est l'heure pour vous de mettre en application ce que nous avons vu. Le chapitre qui suit est un chapitre pratique : un TP !
Bien, jusque là je vous ai guidé lors des différents chapitres. Je vous ai même fourni les solutions des exercices (qui a dit "pas toujours" ? :colere2: ). Après ces quelques leçons de programmation en Ada, il est temps pour vous de réaliser un projet un peu plus palpitant que de dessiner des rectangles avec des dièses (#). Voila pourquoi je vous propose de vous lancer dans la réalisation d'un jeu de dé :
Le craps !
Il ne s'agira pas d'un exercice comme les précédents, car celui-ci fera appel à de nombreuses connaissances (toutes vos connaissances, pour être franc). Il sera également plus long et devra être bien plus complet que les précédents. Songez seulement à tous les cas qu'il a fallu envisager lorsque nous avons créé notre programme lors du chapitre sur les conditions : eh bien il faudra être aussi exhaustif (si ce n'est davantage).
Rassurez-vous, vous ne serez pas lâchez en pleine nature : je vais vous guider. Tout d'abord nous allons établir les règles du jeu et le cahier des charges de notre programme. Puis nous règlerons ensemble certains problèmes techniques que vous ne pouvez résoudre seuls (le problème du hasard notamment). Pour ceux qui auront des difficultés à structurer leur code et leur pensée, je vous proposerai un plan type. Et finalement, je vous proposerai une solution possible et quelques idées pour améliorer notre jeu.
Bon, avant de nous lancer tête baissée, il serait bon de définir ce dont on parle. Le craps se joue avec 2 dés et nous ne nous intéressons pas aux faces des dés mais à leur somme ! Si vos dés indiquent un 5 et un 3 alors vous avez obtenu 5+3=8 !
Le joueur mise une certaine somme, puis il lance les dés. Au premier lancer, on dit que le point est à off.
Si le joueur obtient 7 (somme la plus probable) ou 11 (obtenu seulement avec 6 et 5), il remporte sa mise. (s'il avait misé 10$, alors il gagne 10$)
S'il obtient des craps (2, 3 ou 12) alors il perd sa mise.
S'il obtient 4, 5, 6, 8, 9 ou 10, alors le point passe à on et les règles vont changer.
Une fois que le point est à on, le joueur doit parvenir à refaire le nombre obtenu (4, 5, 6, 8, 9 ou 10). Pour cela, il peut lancer le dé autant de fois qu'il le souhaite, mais il ne doit pas obtenir de 7 !
S'il parvient à refaire le nombre obtenu, le joueur remporte sa mise.
S'il obtient 7 avant d'avoir refait son nombre, le joueur perd sa mise. On peut alors hurler : SEVEN OUT ! Hum ... désolé.
Ce sont là des règles simplifiées car il est possible de parier sur les issues possibles (le prochain lancer est un 11, le 6 sortira avant le 7, le prochain lancer sera un craps...) permettant de remporter jusqu'à 15 fois votre mise. Mais nous nous tiendrons pour l'instant aux règles citées au-dessus.
Un programmeur ne part pas à l'aventure sans avoir pris connaissances des exigences de son client, car le client est roi (et ici, le client c'est moi :diable: ). Vous devez avoir en tête les différentes contraintes qui vous sont imposées avant de vous lancer :
Tout d'abord les mises se feront en $ et nous n'accepterons qu'un nombre entiers de dollars (pas de 7$23, on n'est pas à la boulangerie !)
Le joueur doit pouvoir continuer à jouer tant qu'il n'a pas atteint les 0$
Un joueur ne doit pas pouvoir avoir - 8 $ ! ! ! Scores négatifs interdits. Et pour cela, il serait bon que le croupier vérifie que personne ne mise plus qu'il ne peut perdre (autrement dit, pas de mise sans vérification).
Le joueur ne peut pas quitter le jeu avant que sa mise ait été soit perdue soit gagnée. En revanche, il peut quitter la partie en misant 0$.
L'affichage des résultats devra être lisible. Pas de
+5
mais
Vous avez gagné 5 $. Vous avez maintenant 124 $.
Le programme devra indiquer clairement quel est le point (off ou on, et dans ce cas, quel est le nombre ?), si vous avez fait un CRAPS ou un SEVEN OUT, si vous avez gagné, quelle somme vous avez gagné/perdu, ce qu'il vous reste, les faces des dés et leur somme ... Bref, le joueur ne doit pas être dans l'inconnu. Exemple :
Vous avez encore 51$. Combien misez vous ? 50
Le premier de donne 1 et le second donne 2. Ce qui nous fait 3.
C'est un CRAPS. Vous avez perdu 50 $, il ne vous reste plus que 1$.
Votre procédure principale devra être la plus simple possible, pensez pour cela à utiliser des fonctions et des sous-procédures. Vous êtes autorisés pour l'occasion à utiliser des variables en mode out ou in out. ^^
Votre code devra comporter le moins de tests possibles : chaque fois que vous testez une égalité, vous prenez du temps processeur et de la mémoire, donc soyez économes.
Compris ? Alors il nous reste seulement un petit détail technique à régler : comment simuler un lancer de dé ? (Oui, je sais, ce n'est pas vraiment un petit détail).
Je vous transmet ci-dessous une portion de code qui vous permettra de générer un nombre entre 1 et 6, choisi au hasard (on dit aléatoirement).
WITH Ada.Numerics.Discrete_Random ;
PROCEDURE Craps IS
SUBTYPE Intervalle IS Integer RANGE 1..6 ;
PACKAGE Aleatoire IS NEW Ada.Numerics.Discrete_Random(Intervalle);
USE Aleatoire;
Hasard : Generator;
...
Bah, pourquoi ?
Malheureusement, je ne peux pas vous expliquer ce code pour l'instant car il fait appel à des notions sur les packages, l'héritage, la généricité ... que nous verrons bien plus tard. Vous n'aurez donc qu'à effectuer un copier-coller. En revanche, je peux vous expliquer la toute dernière ligne : pour générer un nombre "aléatoire", l'ordinateur a besoin d'une variable appelée générateur ou germe. C'est à partir de ce générateur que le programme créera de nouveaux nombres. C'est là le sens de cette variable Hasard (de type generator).
Mais vous devrez initialiser ce générateur au début de votre procédure principale une et une seule fois ! Pour cela, il vous suffira d'écrire :
BEGIN
reset(Hasard) ;
...
Par la suite, pour obtenir un nombre compris entre 1 et 6 aléatoirement, vous n'aurez à écrire :
MaVariable := random(Hasard) ;
Et pourquoi pas une fonction qui renverrait directement un nombre entre 2 et 12 ?
Comme promis, pour ceux qui ne sauraient pas comment partir ou qui seraient découragés, voici un plan de ce que pourrait être votre programme.
Vous devez réfléchir aux fonctions essentielles : que fait un joueur de CRAPS ? Il joue tant qu'il a de l'argent. Il commence par parier une mise (s'il mise 0, c'est qu'il arrête et qu'il part avec son argent) puis il attaque la première manche (la seconde ne commençant que sous certaines conditions, on peut considérer pour l'instant qu'il ne fait que jouer à la première manche). Voilà donc un code sommaire de notre procédure principale :
RESET(hasard) ;
TANT QUE argent /= 0
| PARIER
| SI mise = 0
| | ALORS STOP
| FIN DU SI
| JOUER LA PREMIÈRE MANCHE
FIN DE BOUCLE
A vous de le traduire en Ada. Vous devriez avoir identifier une boucle while, un if et un exit. Vous devriez également avoir compris que nous aurons besoin de deux fonctions/procédures PARIER et JOUER LA PREMIÈRE MANCHE (nom à revoir bien entendu).
La procédure/fonction PARIER se chargera de demander la mise désirée et de vérifier que le joueur peut effectivement parier une telle somme :
TANT QUE mise trop importante
| DEMANDER mise
FIN DE BOUCLE
La fonction/procédure MANCHE1 se contentera de lancer les dés, de regarder les résultats et d'en tirer les conclusions :
LANCER dés
SI les dés valent
| 7 ou 11 => on gagne
| 2,3 ou 12 => on perd
| autre chose => point := on
| MANCHE2 avec valeur du point
FIN DE SI
Il est possible de réaliser une fonction/procédure LANCER qui "jettera les dés" et affichera les scores ou bien on pourra écrire le code nécessaire dans la fonction/procédure MANCHE1. Intéressons-nous à la fonction/procédure MANCHE2 :
TANT QUE point = on
| SI les dés valent
| | 7 => on perd
| | point => on gagne
| FIN DE SI
FIN DE BOUCLE
Voilà décomposé la structure des différentes fonctions/procédures que vous devrez rédiger. Bien sûr, je ne vous indique pas si vous devez choisir entre fonction ou procédure, si vous devez transmettre des paramètres, afficher du texte, choisir entre if et case, ... Je ne vais pas non plus tout faire.
Cliquez en-dessous pour visualiser le code d'une solution possible (ce n'est pas la seule) à ce TP :
WITH Ada.Text_IO,Ada.Integer_Text_IO,Ada.Numerics.Discrete_Random ;
USE Ada.Text_IO,Ada.Integer_Text_IO ;
PROCEDURE Craps IS
------------------------
--PACKAGES NECESSAIRES--
------------------------
SUBTYPE Intervalle IS Integer RANGE 1..6 ;
PACKAGE Aleatoire IS NEW Ada.Numerics.Discrete_Random(Intervalle);
USE Aleatoire;
---------------------------
--FONCTIONS ET PROCEDURES--
---------------------------
PROCEDURE Lancer (
D1 : OUT Natural;
D2 : OUT Natural;
Hasard : Generator) IS
BEGIN
D1 := Random(Hasard) ;
D2 := Random(Hasard) ;
Put(" Vous obtenez un") ; Put(D1,2) ;
Put(" et un") ; Put(D2,2) ;
put(". Soit un total de ") ; put(D1+D2,4) ; put_line(" !") ;
END Lancer ;
function parier(argent : natural) return natural is
mise : natural := 0 ;
begin
Put(" Vous disposez de") ; Put(argent) ; put_line(" $.") ;
while mise = 0 loop
Put(" Combien souhaitez-vous miser ? ") ;
Get(mise) ; skip_line ;
if mise > argent
then Put_line(" La maison ne fait pas credit, Monsieur.") ; mise := 0 ;
else exit ;
end if ;
end loop ;
return mise ;
end parier ;
procedure Manche2(Hasard : generator ; Mise : in out natural ; Argent : in out natural ; Point : in out natural) is
D1,D2 : Natural; --D1 et D2 indiquent les faces du dé 1 et du dé 2
begin
while point>0 loop
Lancer(D1,D2,Hasard) ;
if D1 + D2 = Point
then Put(" Vous empochez ") ; Put(Mise,1) ; put(" $. Ce qui vous fait ") ;
Argent := Argent + Mise ; point := 0 ; mise := 0 ;
Put(Argent,1) ; Put_line(" $. Bravo.") ; new_line ;
elsif D1 + D2 = 7
then Put(" Seven Out ! Vous perdez ") ; Put(Mise,1) ; put(" $. Plus que ") ;
Argent := Argent - Mise ; point := 0 ; mise := 0 ;
Put(Argent,1) ; Put_line(" $. Dommage.") ; new_line ;
end if ;
end loop ;
end Manche2 ;
procedure Manche1(Hasard : generator ; Mise : in out natural ; Argent : in out natural) is
D1,D2 : Natural; --D1 et D2 indiquent les faces du dé 1 et du dé 2
Point : Natural := 0; --0 pour off, les autres nombres indiquant que le point est on
begin
Lancer(D1,D2,Hasard) ;
CASE D1 + D2 IS
WHEN 7 | 11 => Put(" Vous empochez ") ; Put(Mise,1) ; put(" $. Ce qui vous fait ") ;
Argent := Argent + Mise ; Mise := 0 ;
Put(Argent,1) ; Put_line(" $. Bravo.") ; new_line ;
WHEN 2 | 3 | 12 => Put(" CRAPS ! Vous perdez ") ; Put(Mise,1) ; put(" $. Plus que ") ;
Argent := Argent - Mise ; Mise := 0 ;
Put(Argent,1) ; Put_line(" $. Dommage.") ; new_line ;
WHEN OTHERS => Point := D1 + D2 ;
Put(" Le point est etabli a ") ; Put(point,5) ; New_line ;
Manche2(Hasard,Mise,Argent,Point) ;
END CASE ;
end Manche1 ;
-------------
--VARIABLES--
-------------
Hasard : Generator; --Ce generator nous servira à simuler le hasard
Argent : Natural := 100; --On commence avec 100$
Mise : Natural := 0; --montant misé, on l'initialise à 0 pour débuter.
------------------------
--PROCEDURE PRINCIPALE--
------------------------
BEGIN
Reset(Hasard) ;
Put_Line(" Bienvenue au CRAPS ! ! !") ; New_Line ;
while argent > 0 loop
Mise := Parier(argent) ;
exit when Mise = 0 ;
Put_line(" Les jeux sont faits !") ;
Manche1(Hasard,Mise,Argent) ;
new_line ;
END LOOP ;
Put("Vous repartez avec ") ; Put(Argent,5) ; put("$ !") ;
END Craps ;
Voila notre jeu de craps réalisé : vous avez bien travaillé.
Mais, tu nous avais dit que tu proposerais des améliorations. :o
En effet, en voici quelques unes. Certaines ne seront peut-être réalisables que bien plus tard.
Prendre en compte tous les types de paris. Pour davantage de détails, aller voir les règles sur ce site.
Prendre en compte un parieur extérieur, un second joueur.
Enregistrer les meilleurs scores dans un fichier (pour plus tard)
Proposer un système de "médaille" : celui qui part avec moins de 100$ aura la médaille de "rookie", plus de 1000$ la médaille du "Dieu des dés" ... à vous d'inventer différents sobriquets.
Et que pourrait faire le joueur de tout cet argent gagné ? S'acheter une bière, une moto, un cigare, un carambar ?
A vous de trouver vos idées, de bidouiller, de tester ... c'est comme ça que vous progresserez. N'ayez pas peur de modifier ce que vous avez fait !
Les chapitres et notions abordés dans cette partie sont essentiels et seront réutilisés constamment. Il est donc important que vous les ayez assimilés avant de commencer la prochaine partie. N'hésitez pas à la relire ou à reprendre certains exercices pour les approfondir car la troisième partie se révèlera plus complique. Nous aborderons des types de données plus complexes (tableaux, chaînes de caractères, listes, pointeurs ...), la programmation modulaire et la programmation orientée objet. Ce sera l'occasion de revenir sur certaines notions, comme les packages, que nous n'avons pas pu approfondir.
Comme prévu, nous allons aborder dans ce chapitre un nouveau type de données, les tableaux ou array en Ada. Ce sera pour nous l'occasion d'aborder et d'expliquer ce que sont les types composites. Puis nous nous concentrerons sur notre premier type composite, les tableaux. À quoi cela ressemble-t-il en Ada ? Quel intérêt à faire des tableaux ? Comment faire des tableaux uni-, bi-, tridimensionnels ? Ce sera également l'occasion de réinvestir ce que nous avons vu dans la seconde partie, notamment sur les boucles.
N'ayez crainte, vous pourrez continuer à suivre ce tutoriel, même si vous n'avez pas bien compris ce qu'est un type composite : toute la partie III y est consacrée. En fait, disons que si les types composites vont nous ouvrir de nombreuses portes qui nous étaient pour l'instant fermées, elle ne va pas pour autant révolutionner notre façon de coder ni remettre en cause ce que nous avons déjà vu.
Pour mieux comprendre, souvenons-nous de notre TP sur le craps. Nous avions beaucoup de variables à manipuler et donc à transmettre à chaque procédure ou fonction. Par exemple, il nous fallait une variable Dé1, une variable Dé2, une variable Hasard et peut-être même une variable SommeDés. Il aurait été plus pratique de ne manipuler qu'un seul objet (appelé MainJoueur ou Joueur) qui aurait géré ces 4 variables. De même un objet Bourse aurait pu gérer la mise et la somme en dollars dont disposait le joueur.
Pour schématiser, les types composites ont pour but de nous faire manipuler des objets plus complexes que de simples variables. Prenons un autre exemple, nous voudrions créer un programme qui crée des fenêtres et permet également de leur donner un titre, de les agrandir ou rétrécir... dans l'optique de le réutiliser plus tard pour créer des programmes plus ambitieux. Nous devrons alors créer notamment les variables suivantes :
X, Y : position de la fenêtre sur l'écran
Long,Larg : longueur et largeur de la fenêtre
Epais : épaisseur des bords de la fenêtre
Titre : le titre de la fenêtre
Rfond, Vfond, Bfond : trois variables pour déterminer la couleur du fond de la fenêtre (R:rouge ; V : vert ; B : bleu)
Actif : une variable pour savoir si la fenêtre est sélectionnée ou non
Reduit : une variable pour savoir si la fenêtre est réduite dans la barre des tâches ou non
...
Eh oui, ça devient complexe de gérer tout ça ! Et vous avez du vous rendre compte lors du TP que cela devient de plus en plus compliqué de gérer un grand nombre de variables (surtout quand les noms sont mal trouvés comme ci-dessus). Il serait plus simple de définir un objet F de type Fenêtre. Imaginons la tête de nos fonctions :
Sans compter que, vous mis à part, personne ne connaît le nom et la signification des paramètres à moins de n'avoir lu tout le code (sans moi :-° ). Imaginez également le chantier si l'on désirait créer une deuxième fenêtre (il faudra trouver de nouveaux noms de variable, Youpiiii ! Il serait bien plus simple de n'avoir qu'à écrire :
Nous n'aurions pas à nous soucier de tous ces paramètres et de leur nom. C'est là tout l'intérêt des types composites : nous permettre de manipuler des objets très compliqués de la manière la plus simple possible.
Le premier type composite que nous allons voir est le tableau, et pour commencer le tableau unidimensionnel, appelé array en Ada.
Quel est l'intérêt de créer des tableaux ? Pas la peine de se compliquer la vie !
Les tableaux n'ont pas été créés pour nous "compliquer la vie". Comme toute chose en informatique, ils ont été inventés pour faire face à des problèmes concrets. Voici un exemple : en vue d'un jeu (de dé, de carte ou autre) à 6 joueurs, on a besoin d'enregistrer les scores des différents participants. D'où le code suivant :
Un peu long et redondant, d'autant plus qu'il vaut mieux ne pas avoir besoin de rajouter ou d'enlever un joueur car nous serions obligés de revoir tout notre code ! Il serait judicieux, pour éviter de créer autant de variables, de les classer dans un tableau de la manière suivante :
15
45
27
8
19
27
Chaque case correspond au score d'un joueur, et nous n'avons besoin que d'une seule variable d'un seul objet : Scores de type T_tableau. On dit que ce tableau est unidimensionnel car il a plusieurs colonnes mais une seule ligne !
Création d'un tableau en Ada
Déclaration
Je vous ai dit qu'un tableau se disait array en Ada. Mais il serait trop simple d'écrire :
Car il existe plusieurs types de tableaux unidimensionnels : tableaux d'integer, tableaux de natural, tableaux de float, tableau de boolean, tableau de character ... Il faut donc créer un type précis ! Et cela se fait de la manière suivante :
HEIN ?!? Qu'est-ce qu'il raconte là ?
Non je ne suis pas en plein délire, rassurez-vous. En fait, nous avons oublié lorsque nous avons écrit le tableau de numéroter les cases. Le plus évident est de le numéroter ainsi :
n°1
n°2
n°3
n°4
n°5
n°6
15
45
27
8
19
27
Il faudra donc écrire le code suivant :
Type T_Tableau is array(1..6) of integer ;
Scores : T_Tableau ;
Mais le plus souvent les informaticiens auront l'habitude de numéroter ainsi :
n°0
n°1
n°2
n°3
n°4
n°5
15
45
27
8
19
27
Il faudra alors changer notre code de la façon suivante :
Type T_Tableau is array(0..5) of integer ;
Scores : T_Tableau ;
La première case est donc la numéro 0 et la 6ème case est la numéro 5 ! C'est un peu compliqué, je sais, mais je tiens à l'évoquer car beaucoup de langages numérotent ainsi leurs tableaux sans vous laisser le choix (notamment le fameux langage C ;) ). Bien sûr, en Ada il est possible de numéroter de 1 à 6, de 0 à 5, mais aussi de 15 à 20, de 7 à 12 ... il suffit pour cela de changer l'intervalle écrit dans les parenthèses.
Dernier point, il est possible en Ada d'utiliser des variables pour déclarer la taille d'un tableau, sauf que ces variables devront être ... constantes !
TailleMax : constant natural := 5 ;
Type T_Tableau is array(0..TailleMax) of integer ;
Scores : T_Tableau ;
Il vous sera donc impossible de créer un tableau de taille variable (pour l'instant tout du moins).
Affectation globale
Maintenant que nous avons déclaré un tableau d'entiers (Scores de type T_Tableau), encore faut-il lui affecter des valeurs. Cela peut se faire de deux façons distinctes. Première façon, la plus directe possible :
Scores := (15,45,27,8,19,27) ;
Simple, efficace. Chaque case du tableau a désormais une valeur. Il est également possible d'utiliser des agrégats. De quoi s'agit-il ? Le plus simple est de vous en rendre compte par vous-même sur un exemple. Nous voudrions que les cases n°1 et n°3 valent 17 et que les autres valent 0. Nous pouvons écrire :
Scores := (17,0,17,0,0,0) ;
Ou bien utiliser les agrégats :
Scores := (1|3 => 17, others => 0) ;
Autrement dit, nous utilisons une sorte de case pour définir les valeurs de notre tableau. Autre possibilité, définir les trois premières valeurs puis utiliser un intervalle d'indices pour les dernières valeurs.
Scores := (17,0,17,4..6 => 0) ;
L'ennui c'est que l'on peut être amené à manipuler des tableaux très très grands (100 cases), et que cette méthode aura vite ses limites.
Affectation valeur par valeur
C'est pourquoi on utilise souvent la seconde méthode :
Quand nous écrivons Scores(1), Scores(2) ... il ne s'agit pas du tableau mais bien des cases du tableau. Scores(1) est la case numéro 1 du tableau Scores. Cette case réagit donc comme une variable de type Integer.
Euh ... c'est pas pire que la première méthode ça ?
Utilisé tel quel, si ça l'est. :D Mais en général, on la combine avec une boucle. Disons que nous allons initialiser notre tableau pour le remplir de 0 sans utiliser les agrégats. Voici la méthode à utiliser :
for i in 1..6 loop
T(i) := 0 ;
end loop ;
L'intervalle de définition d'un type T_Tableau est très important et doit donc être respecté. Supposons que nous n'ayons pas utilisé une boucle for mais une boucle while avec une variable i servant de compteur que nous incrémenterons nous-même de manière à tester également si la case considérée ne vaut pas déjà 0 :
while i <= 6 and T(i) /= 0 loop
T(i) := 0 ;
i := i + 1 ;
end loop ;
La portion de code ci-dessus est censée parcourir le tableau et mettre à zéro toutes les cases non-nulles du tableau. La boucle est censée s'arrêter quand i vaut 7. Seulement que se passe-t-il lorsque i vaut 7 justement ? L'instruction if teste si 7 est plus petit ou égal à 6 (Faux) et si T(7) est différent de zéro. Or T(7) n'existe pas ! Ce code va donc planter notre programme. Nous devons être plus précis et ne tester T(i) que si la première condition est remplie. Ca ne vous rappelle rien ? Alors regardez le code ci-dessous :
while i <= 6 and then T(i) /= 0 loop
T(i) := 0 ;
i := i + 1 ;
end loop ;
Il faut donc remplacer l'instruction and par and then. Ainsi, si le premier prédicat est faux, alors le second ne sera pas testé. Cette méthode vous revient maintenant ? Nous l'avions abordée lors du chapitre sur les booléens. Peux être sera-t-il temps d'y rejeter un œil si jamais vous aviez lu les suppléments en diagonale.
Attributs pour les tableaux
Toutefois, pour parcourir un tableau, la meilleure solution est, de loin, l'usage de la boucle for. Et nous pouvons même faire encore mieux. Comme nous pourrions être amenés à modifier la taille du tableau ou sa numérotation, voici un code plus intéressant encore :
for i in T'range loop
T(i) := 0 ;
end loop ;
L'attribut T'range indiquera l'intervalle de numérotation des cases du tableau : 1..6 pour l'instant, ou 0..5 si l'on changeait la numérotation par exemple. Remarquez que l'attribut s'applique à l'objet T et pas à son type T_Tableau. De même, si vous souhaitez afficher les valeurs contenues dans le tableau, vous devrez écrire :
for i in T'range loop
put(T(i)) ;
end loop ;
Voici deux autres attributs liés aux tableaux et qui devraient vous servir : T'first et T'last. T'first vous renverra le premier indice du tableau T ; T'last renverra le dernier indice du tableau. Si les indices de votre tableau vont de 1 à 6 alors T'first vaudra 1 et T'last vaudra 6. Si les indices de votre tableau vont de 0 à 5 alors T'first vaudra 0 et T'last vaudra 5. L'attribut T'range quant à lui, équivaut à écrire T'first..T'last.
Quel est l'intérêt de ces deux attributs puisqu'on a T'range ?
Il peut arriver (nous aurons le cas dans les exercices suivants), que vos boucles aient besoin de commencer à partir de la deuxième case par exemple ou de s'arrêter avant la dernière. Auquel cas, vous pourrez écrire :
for i in T'first +1 .. T'last - k loop
...
Dernier attribut intéressant pour les tableaux : T'length. Cet attribut renverra la longueur du tableau, c'est à dire son nombre de cases. Cela vous évitera d'écrire : T'last - T'first +1 ! Par exemple, si nous avons le tableau suivant :
Compliquons notre exercice : nous souhaitons enregistrer les scores de 4 équipes de 6 personnes. Nous pourrions faire un tableau unidimensionnel de 24 cases, mais cela risque d'être compliqué de retrouver le score du 5ème joueur de le 2ème équipe :-° Et c'est là qu'arrivent les tableaux à 2 dimensions ou bidimensionnels ! Nous allons ranger ces scores dans un tableau de 4 lignes et 6 colonnes.
15
45
27
8
19
27
41
5
3
11
3
54
12
13
14
19
0
20
33
56
33
33
42
65
Le 5ème joueur de la 2ème équipe a obtenu le score 3 (facile à retrouver).
Déclaration
La déclaration se fait très facilement de la manière suivante :
type T_Tableau is array(1..4,1..6) of natural ;
Le premier intervalle correspond au nombre de lignes, le second au nombre de colonnes.
On voit alors que cette méthode, si pratique avec des tableaux unidimensionnels devient très lourde avec une seconde dimension. Quant à l'affectation valeur par valeur, elle exigera d'utiliser deux boucles imbriquées :
for i in 1..4 loop
for j in 1..6 loop
T(i,j) := 0 ;
end loop ;
end loop ;
Tableaux tridimensionnels et plus
Vous serez parfois amenés à créer des tableaux à 3 dimensions ou plus. La déclaration se fera tout aussi simplement :
type T_Tableau3D is array(1..2,1..4,1..3) of natural ;
type T_Tableau4D is array(1..2,1..4,1..3,1..3) of natural ;
Je ne reviens pas sur l'affectation qui se fera avec trois boucles for imbriquées, l'affectation directe devenant compliquée et illisible. Ce qui est plus compliqué, c'est de concevoir ces tableaux. Voici une illustration d'un tableau tridimensionnel :
Notre tableau est en 3D, c'est un pavé droit (parallélépipède rectangle) découpé en cases cubiques. T(1,4,2) est donc le cube qui se trouve dans la première ligne, dans la 4ème colonne et dans la 2ème "rangée". Les choses se corsent encore pour un tableau en 4 dimensions, il faut s'imaginer avoir une série de tableaux en 3D (la quatrième dimension jouant le rôle du temps) :
T(1,4,1,2) est donc le cube situé à la 1ère ligne, 4ème colonne, 1ère rangée du 2ème pavé droit.
Et mes attributs ?
C'est bien gentil de ne pas revenir sur l'affectation avec les boucles imbriquées, mais moi j'ai voulu remplir un tableau de type T_Tableau3D avec des 0, en utilisant des attributs, mais je cherche encore !
Nous avons effectivement un souci. T_Tableau3D est un type de tableau avec 2 lignes, 4 colonnes et 3 rangées, donc quand nous écrivons T'range cela correspond à l'intervalle 1..2 ! Pas moyen d'avoir les intervalles 1..4 ou 1..3 ? Eh bien si ! Il suffit d'indiquer à notre attribut de quelle dimension nous parlons. Pour obtenir l'intervalle 1..4 il faut écrire T'range(2) (l'intervalle de la seconde dimension ou le second intervalle), pour obtenir l'intervalle 1..3 il faut écrire T'range(3) (l'intervalle de la troisième dimension ou le troisième intervalle). Donc T'range signifie en fait T'range(1) !
Attribut
Résultat
T'range(1)
1..2
T'range(2)
1..4
T'range(3)
1..3
T'first(1)
1
T'first(2)
1
T'first(3)
1
T'last(1)
2
T'last(2)
4
T'last(3)
3
T'length(1)
2
T'length(2)
4
T'length(3)
3
Et mes agrégats ?
Voici une manière d'initialiser un tableau bidimensionnel de 2 lignes et 4 colonnes :
T := (1 => (0,0,0,0), 2 => (0,0,0,0)) ;
On indique que la ligne 1 est (0,0,0,0) puis même chose pour la ligne 2. On peut aussi condenser tout cela :
T := (1..2 => (0,0,0,0)) ;
Ou encore :
T := (1..2 => (1..4 => 0)) ;
Il devient toutefois clair que les agrégats deviendront vite illisibles dès que nous souhaiterons manipuler des tableaux avec de nombreuses dimensions.
Vous devriez commencer à vous rendre compte que les tableaux apportent de nombreux avantages par rapport aux simples variables. Toutefois, un problème se pose : ils sont contraints. Leur taille ne varie jamais, ce qui peut être embêtant. Reprenons l'exemple initial : nous voudrions utiliser un tableau pour enregistrer les scores des équipes. Seulement nous voudrions également que notre programme nous laisse libre de choisir le nombre de joueurs et le nombre d'équipes. Comment faire ? Pour l'heure, la seule solution est de construire un type T_Tableau suffisamment grand (500 par 800 par exemple) pour décourager quiconque vouloir dépasser ses capacités (il faut avoir du temps à perdre pour se lancer dans une partie avec plus de 500 équipes de plus de 800 joueurs ^^ ). Mais la plupart du temps, 80% des capacités seront gâchées, entraînant une perte de mémoire considérable ainsi qu'un gâchis de temps processeur. La solution est de créer un type T_Tableau qui ne soit pas précontraint. Voici une façon de procéder avec un tableau unidimensionnel :
type T_Tableau is array (integer range <>) of natural ;
Notre type T_Tableau est ainsi "un peu" plus générique.
T'aurais du commencer par là ! Enfin des tableaux quasi infinis ! :pirate:
Attention ! Ici, c'est le type T_Tablau qui n'est pas contraint. Mais les objets de type T_Tableau devront toujours être contraints et ce, dès la déclaration. Celle-ci s'effectuera ainsi :
T : T_Tableau(1..8) ;
-- OU
N : natural := 1065 ;
Tab : T_Tableau(5..N) ;
Affectation par tranche
D'où l'intérêt d'employer les attributs dans vos boucles afin de disposer de procédures et de fonctions génériques (non soumises à une taille prédéfinie de tableau). Faites toutefois attention à la taille de vos tableaux, car il vous sera impossible d'écrire T := Tab ; du fait de la différence de taille entre vos deux tableaux Tab et T.
Heureusement, il est possible d'effectuer des affectations par tranches (slices en Anglais). Supposons que nous ayons trois tableaux définis ainsi :
T : T_Tableau(1..10) ;
U : T_Tableau(1..6) ;
V : T_Tableau(1..4) ;
Il sera possible d'effectuer nos affectations de la façon suivante :
T(1..6) := U ;
T(7..10) := V ;
Ou même, avec les attributs :
T(T'first..T'first+U'length-1) := U ;
T(T'first+U'length..T'first+U'length+V'length-1) := V ;
Déclarer un tableau en cours de programme
Mais cela ne répond toujours pas à la question : "Comment créer un tableau dont la taille est définie par l'utilisateur ?". Pour cela, nous allons sortir du cadre des tableaux et découvrir un nouveau bloc d'instruction : le bloc declare. L'instruction declare va nous permettre de déclarer des objets ou des variables en cours de programme. Explication par l'exemple :
procedure main is
n : Integer ;
type T_Tableau is array (integer range <>) of integer ;
begin
Put("Quelle est la longueur du tableau ? ") ;
get(n); skip_line ;
declare
tab : T_Tableau(1..n) ;
begin
--instructions ne nous intéressant pas
end;
end main;
Ainsi, nous saisissons une variable n, puis avec declare, nous ouvrons un bloc de déclaration nous permettant de créer notre tableau tab à la longueur souhaitée. Puis, il faut terminer les déclarations et ouvrir un bloc d'instruction avec begin. Ce nouveau bloc d'instructions se terminera avec le end;.
Voici quelques exercices pour mettre en application ce que nous venons de voir.
Exercice 1
Énoncé
Créer un programme Moyenne qui saisit une série de 8 notes sur 20 et calcule la moyenne de ces notes. Il est bien sûr hors de question de créer 8 variables ni d'écrire une série de 8 additions car le programme devra pouvoir être modifié très simplement pour pouvoir calculer la moyenne de 7, 9, 15 ... notes, simplement en modifiant une variable !
Solution
with Ada.Text_IO, Ada.Integer_Text_IO, Ada.Float_Text_IO ;
use Ada.Text_IO, Ada.Integer_Text_IO, Ada.Float_Text_IO ;
procedure Moyenne is
Nb_Notes : constant integer := 8 ; --Constante donnant la taille des tableaux
type T_Tableau is array(1..Nb_notes) of float ; --type tableau pour enregistrer les notes
Notes : T_Tableau ; --tableau de notes
Moy : float ; --variable servant à enregistrer la moyenne
function saisie return T_Tableau is --fonction effectuant la saisie des valeurs d'un tableau
T : T_Tableau ;
begin
for i in T'range loop
Put("Entrez la ") ; Put(i,1) ;
if i=1
then put("ere note : ") ;
else put("eme note : ") ;
end if ;
get(T(i)) ; skip_line ;
end loop ;
return T ;
end saisie ;
function somme(T:T_Tableau) return float is --fonction effectuant la somme des valeurs contenues dans un tableau
S : float := 0.0 ;
begin
for i in T'range loop
S:= S + T(i) ;
end loop ;
return S ;
end somme ;
begin --Procédure principale
Notes := saisie ;
Moy := Somme(Notes)/float(Nb_Notes) ;
Put("La moyenne est de ") ; Put(Moy) ;
end Moyenne ;
J'ai un problème dans l'affichage de mon résultat ! Le programme affiche 1.24000E+01 au lieu de 12.4 !
Par défaut, l'instruction Put() affiche les nombres flottants sous forme d'une écriture scientifique (le E+01 remplaçant une multiplication par dix puissance 1). Pour régler ce problème, Vous n'aurez qu'à écrire :
Put(Moy,2,2,0) ;
Que signifient tous ces paramètres ? C'est simple, l'instruction put() s'écrit en réalité ainsi :
L'instruction Put utilisée ici est celle provenant du package Ada.Float_Text_IO.
Le paramètre Item est le nombre de type float qu'il faut afficher.
Le paramètre Fore est le nombre de chiffres placés avant la virgule qu'il faut afficher (Fore pour Before = Avant). Cela évite d'afficher d'immenses blancs avant vos nombres.
Le paramètre Aft est le nombre de chiffres placés après la virgule qu'il faut afficher (Aft pour After = Après).
Le paramètre Exp correspond à l'exposant dans la puissance de 10. Pour tous ceux qui ne savent pas (ou ne se souviennent pas) ce qu'est une puissance de 10 ou une écriture scientifique, retenez qu'en mettant 0, vous n'aurez plus de E à la fin de votre nombre.
En écrivant Put(Moy,2,2,0) nous obtiendrons donc un nombre avec 2 chiffres avant la virgule, 2 après et pas de E+01 à la fin.
Exercice 2
Énoncé
Rédiger un programme Pascal qui affichera le triangle de Pascal jusqu'au rang 10. Voici les premiers rangs :
1
1 1
1 2 1
1 3 3 1
1 4 6 4 1
1 5 10 10 5 1
Ce tableau se construit de la manière suivante : pour calculer une valeur du tableau, il suffit d'additionner celle qui se trouve au dessus et celle qui se trouve au-dessus à gauche. Le triangle de Pascal est très utile en Mathématiques.
Comme on ne peut créer de tableaux "triangulaires", on créera un tableau "carré" de taille 10 par 10 rempli de zéros que l'on n'affichera pas. On prendra soin d'afficher les chiffres des unités les uns en dessous des autres.
Solution
with Ada.Text_IO,Ada.Integer_Text_IO ;
use Ada.Text_IO,Ada.Integer_Text_IO ;
procedure Pascal is
Taille : constant integer := 10 ;
type T_Tableau is array(1..Taille, 1..Taille) of integer ;
Pascal : T_Tableau ;
function init return T_Tableau is
T : T_Tableau ;
begin
T := (others => 0)
return T ;
end init ;
function CreerTriangle (Tab : T_Tableau) return T_Tableau is
T : T_Tableau := Tab ; --comme on ne peut pas modifier le paramètre, on en crée une copie
Begin
for i in T'range loop
T(i,1) := 1 ; --le premier nombre vaut toujours 1
for j in 2..i loop --on remplit ensuite la ligne à partir du deuxième nombre
T(i,j) := T(i-1,j) + T(i-1,j-1) ;
end loop ;
end loop ;
Return T ;
end CreerTriangle ;
Procedure Afficher(T : T_Tableau) is
begin
for i in T'range loop
for j in 1..i loop
Put(T(i,j),4) ;
end loop ;
new_line ;
end loop;
end Afficher ;
begin
Pascal := init ;
Pascal := CreerTriangle(Pascal) ;
Afficher(Pascal) ;
end Pascal ;
Pourquoi dans ta fonction CreerTriangle tu n'as pas écrit ça :
for i in T'range loop
for j in 1..i loop --on remplit ensuite la ligne à partir du deuxième nombre
if i = 1
then T(i,j) := 1 ;
else T(i,j) := T(i-1,j) + T(i-1,j-1) ;
end if ;
end loop ;
end loop ;
Surtout pas ! Car à chaque itération (chaque tour de boucle) il aurait fallu faire un test, or un test coûte de la place en mémoire et surtout du temps processeur. Cela aurait fait perdre beaucoup d'efficacité à notre programme alors que le cas de figure testé (savoir si l'on est dans la première colonne) est relativement simple à gérer et ne nécessite pas de condition. De même pour l'affichage, je n'ai pas testé si les nombres valaient 0, il suffit d'arrêter la boucle avant de les atteindre, et ça, ça se calcule facilement.
Il est également possible pour améliorer ce code, de fusionner les fonctions init et CreerTriangle en une seule de la manière suivante :
function init return T_Tableau is
Begin
for i in T'range loop
T(i,1) := 1 ; --le premier nombre vaut toujours 1
for j in 2..i loop --on remplit ensuite la ligne à partir du deuxième nombre
T(i,j) := T(i-1,j) + T(i-1,j-1) ;
end loop ;
for j in i+1 .. T'last loop --on complète avec des 0
T(i,j) := 0 ;
end loop ;
end loop ;
Return T ;
end init ;
Exercice 3
Énoncé
Créer un programme TriTableau qui crée un tableau unidimensionnel avec des valeurs entières aléatoires, l'affiche, trie ses valeurs par ordre croissant et enfin affiche le tableau une fois trié.
Solution
With ada.Text_IO, Ada.Integer_Text_IO,Ada.Numerics.Discrete_Random ;
Use ada.Text_IO, Ada.Integer_Text_IO ;
Procedure TriTableau is
Taille : constant natural := 12 ;
Type T_Tableau is array(1..Taille) of integer ;
--init renvoie un tableau à valeurs aléatoires
function init return T_Tableau is
T:T_Tableau ;
subtype Intervalle is integer range 1..100 ;
package Aleatoire is new Ada.numerics.discrete_random(Intervalle) ;
use Aleatoire ;
Hasard : generator ;
begin
Reset(Hasard) ;
for i in T'range loop
T(i) := random(Hasard) ;
end loop ;
return T ;
end init ;
--Afficher affiche les valeurs d'un tableau sur une même ligne
procedure Afficher(T : T_Tableau) is
begin
for i in T'range loop
Put(T(i),4) ;
end loop ;
end Afficher ;
--Echanger est une procédure qui échange deux valeurs : a vaudra b et b vaudra a
procedure Echanger(a : in out integer ; b : in out integer) is
c : integer ;
begin
c := a ;
a := b ;
b := c ;
end Echanger ;
--Rangmin cherche la valeur minimale dans une partie d'un tableau ; du rang debut au rang fin
--Elle ne renvoie pas le minimum mais son rang, son indice dans le tableau
function RangMin(T : T_Tableau ; debut : integer ; fin : integer) return integer is
Rang : integer := debut ;
Min : integer := T(debut) ;
begin
for i in debut..fin loop
if T(i)<Min
then Min := T(i) ;
Rang := i ;
end if ;
end loop ;
return Rang ;
end RangMin ;
--Trier est une fonction qui renvoie un tableau trié du plus petit au plus grand
--Principe, elle cherche la valeur minimale du tableau et l'échange avec la première valeur
--puis elle cherche le minimum dans le tableau à partir de la deuxième valeur et l'échange
--avec la première valeur, puis elle recommence avec la troisième valeur ...
function Trier(Tab : T_Tableau) return T_Tableau is
T : T_Tableau := Tab ;
begin
for i in T'range loop
Echanger(T(i),T(RangMin(T,i,T'last))) ;
end loop ;
return T ;
end Trier ;
T : T_Tableau ;
begin
T := init ;
Put_line("Le tableau genere par l'ordinateur est le suivant :") ;
Afficher(T) ; New_line ;
Put_line("Voici le tableau, une fois trie : ") ;
Afficher(Trier(T)) ;
end TriTableau ;
L'exemple que je vous donne est un algorithme de tri par sélection. C'est disons l'un des algorithmes de tri les plus barbares. C'est la méthode la plus logique à première vue, mais sa complexité n'est pas vraiment intéressante (par complexité, on entend le nombre d'opérations et d'itérations nécessaires et pas le fait que vous ayez compris ou pas). Nous verrons plus tard d'autres algorithmes de tri plus efficaces. En attendant, si ce code vous semble compliqué, je vous invite à lire le tutoriel de K-Phoen sur le tri par sélection : lui, il a cherché le maximum et pas le minimum, mais le principe est le même ; en revanche, son code est en C, mais cela peut être l'occasion de voir par vous même les différences et ressemblances entre l'Ada et le C.
Nous reviendrons durant la quatrième partie sur la complexité des algorithmes et nous en profiterons pour aborder des algorithmes de tris plus puissants. Mais avant cela, vous avez beaucoup de pain sur la planche ! ^^
Maintenant que vous connaissez les tableaux, notre prochain chapitre portera sur un type similaire : les chaînes de caractères ou string (en Ada). Je ne saurais trop vous conseiller de vous exercer à l'utilisation des tableaux car nous serons amenés à les utiliser très souvent par la suite, et le prochain chapitre ne s'en éloignera guère. Donc s'il vous reste des questions, des zones d'ombre, je ne saurais trop vous conseiller de relire ce cours et d'effectuer les exercices. N'hésitez pas non plus à vous fixer des projets ou des TP personnels. N'oubliez pas que c'est en forgeant que l'on devient forgeron.
Après les tableaux voici un nouveau type composite Ada : les chaînes de caractères ou strings. Rentrez les langues les garçons, il n'y aura rien de sexuel dans ce chapitre. A dire vrai, vous avez déjà manipuler des strings par le passé (je veux dire, en Ada) et ce chapitre ne fera que mettre les choses au clair car vous disposez dors et déjà de toutes les connaissances nécessaires.
Comme je viens de vous le dire, vous avez déjà manipulé des strings ou chaînes de caractères. Notamment lorsque vous écrivez :
Put("Bonjour !") ;
Le texte entre guillemets "Bonjour !" est un string.
Ah ... c'est pas ce que j'avais pensé... :( on va faire tout un chapitre dessus ?
Ce chapitre ne sera pas long. Nous avons toutes les connaissances utiles, il s'agit juste de découvrir un type composite que nous utilisons depuis longtemps sans nous en rendre compte. Qu'est-ce finalement qu'une chaîne de caractères ? Eh bien le string ci-dessus se résume en fait à ceci :
n°1
n°2
n°3
n°4
n°5
n°6
n°7
n°8
n°9
'B'
'o'
'n'
'j'
'o'
'u'
'r'
' '
'!'
Eh oui ! Ce n'est rien d'autre qu'un tableau de caractères indexé à partir de 1. Notez que certains langages comme le célèbre C, commencent leurs indices à 0 et ajoutent un dernier caractère à la fin : le caractère de fin de texte. Ce n'est pas le cas en Ada où le type String est très aisément manipulable.
Nous allons créer un programme ManipString. Nous aurons besoin du package ada.text_io. De plus, avant de créer des instructions, nous allons devoir déclarer notre string de la manière suivante :
with ada.text_io ;
use ada.text_io ;
procedure ManipString is
txt : string(1..6) ;
begin
txt := "Salut!" ;
put(txt) ;
end ManipString
Eh oui ! Un string n'étant rien d'autre qu'un tableau de caractères, il est donc contraint : son nombre de cases est limité et doit être indiqué à l'avance. Par conséquent, il est possible de lui affecté la chaîne de caractères "Salut!" mais pas la chaîne "Salut !" qui comporte 7 caractères (n'oubliez pas qu'un espace est le caractère ' ' !). Il est aussi possible de déclarer notre objet txt tout en lui affectant une valeur initiale :
with ada.text_io ;
use ada.text_io ;
procedure ManipString is
txt : string := "Salut!" ;
begin
put(txt) ;
end ManipString
Comme pour un tableau, il est possible d'accéder à l'une des valeurs contenues dans le string. Par exemple :
with ada.text_io ;
use ada.text_io ;
procedure ManipString is
txt : string := "Bonjour jules !" ;
indice : integer ;
begin
put_line(txt) ;
for i in txt'range loop
if txt(i) = 'e'
then indice := i ;
end if ;
end loop ;
txt(indice) := 'i' ;
txt(indice+1) := 'e' ;
put("oups. ") ;
put(txt) ;
end ManipString ;
Ce programme cherche la dernière occurence de la lettre 'e' et la remplace par un 'i'. Il affichera ainsi :
Bonjour jules !
oups. Bonjour julie !
Remarquez au passage qu'il est toujours possible d'utiliser les attributs.
Accès à plusieurs valeurs
Nous voudrions maintenant modifier "Bonjour Jules !" en "Bonsoir Julie !". Cela risque d'être un peu long de tout modifier lettre par lettre. Voici donc une façon plus rapide :
with ada.text_io ;
use ada.text_io ;
procedure ManipString is
txt : string := "Bonjour jules !" ;
begin
put_line(txt) ;
txt(4..7) := "soir" ;
for i in txt'range loop
if txt(i) = 'e'
then txt(i) := 'i' ;
txt(i+1) := 'e' ;
exit ;
end if ;
end loop ;
put("oups. ") ;
put(txt) ;
end ManipString ;
Il est ainsi possible d'utiliser les intervalles pour remplacer tout un paquet de caractères d'un coup. Vous remarquerez que j'en ai également profité pour condenser mon code et supprimer la variable indice. Personne n'est parfait : il est rare d'écrire un code parfait dès la première écriture. La plupart du temps, vous tâtonnerez et peu à peu, vous parviendrez à supprimer le superflu de vos codes.
Modifier la casse
Autre modification possible : modifier la casse (majuscule/minuscule). Nous aurons besoin pour cela du package Ada.characters.handling. Le code suivant va ainsi écrire "Bonjour" en majuscule et transformer le 'j' de Jules en un 'J' majuscule.
with ada.text_io, Ada.characters.handling ;
use ada.text_io, Ada.characters.handling ;
procedure ManipString is
txt : string := "Bonjour jules !" ;
begin
put_line(txt) ;
txt(1..7) := to_upper(txt(1..7)) ;
for i in txt'range loop
if txt(i) = 'e'
then txt(i) := 'i' ;
txt(i+1) := 'e' ;
elsif txt(i) = 'j'
then txt(i) := to_upper(txt(i)) ;
end if ;
end loop ;
put("oups. ") ;
put(txt) ;
end ManipString
La fonction to_upper() transforme un character ou un string pour le mettre en majuscule. Il existe également une fonction to_lower() qui met le texte en minuscule.
Concaténation
Nous allons maintenant écrire un programme qui vous donne le choix entre plusieurs prénom (entre plusieurs strings) et affiche ensuite une phrase de bienvenue. Les différents prénoms possibles seront : "Jules", "Paul" et "Frederic". Contrainte supplémentaire : il faut utiliser le moins d'instructions Put() pour saluer notre utilisateur.
with Ada.Text_IO ;
use Ada.Text_IO ;
procedure ManipString is
txt : string := "Bienvenue, " ;
Nom_1 : string := "Jules." ;
Nom_2 : string := "Paul." ;
Nom_3 : string := "Frederic." ;
choix : integer ;
begin
Put_line("Comment vous appelez-vous ?") ;
Put_line("1 - " & Nom_1) ;
Put_line("2 - " & Nom_2) ;
Put_line("3 - " & Nom_3) ;
Get(choix) ; skip_line ;
case choix is
when 1 => Put(txt & Nom_1) ;
when 2 => Put(txt & Nom_2) ;
when others => Put(txt & Nom_3) ;
end case ;
end ManipString ;
Nous avons utilisé le symbole & pour effectuer une opération de concaténation. Cela signifie que l'on met bout-à-bout deux strings (ou plus) pour en obtenir un plus long.
case choix is
when 1 => txt := txt & Nom_1 ;
when 2 => txt := txt & Nom_2 ;
when others => txt := txt & Nom_3 ;
end case ;
Transformer une variable en string et inversement
Transformer une variable en string
Et si au lieu de "Bienvenue ####", je veux afficher une ligne disant "Vous avez fait le choix n°#, vous vous appelez donc ####", je peux concaténer des strings et des variables de types integer ?
Euh ... non ! Rappelez-vous, je vous ai dit que le langage Ada avait un fort typage, autrement dit on ne mélange pas les choux et les carottes, les strings et les integer ! Par contre, il y a un moyen de parvenir à votre but en respectant ces contraintes de fort typage, grâce aux ... attributs (eh oui encore) !
Put("Vous avez fait le choix n°" & integer'image(choix) & ", vous vous appelez donc " & Nom_1) ;
L'attribut integer'image() renvoie un string, une "image" de l'integer placé entre parenthèses. Bien entendu, cet attribut n'est pas réservé au type integer et s'applique à tous types de variables ou d'objets.
Transformer un string en variable
Et l'inverse ? Si je veux transformer un string en variable ?
Eh bien tout dépend du type de variable souhaité. Si vous voulez une variable du type integer, alors vous pourrez utilisé l'attribut integer'value(). Entre les parenthèses, vous n'aurez qu'à écrire votre string et l'attribut 'value le transformera en un integer (ou un natural, ou un float ...).
Comparaison
Oui, il est possible de comparer des strings ! :-° Il est possible de tester leur égalité avec l'opérateur = ; il est aussi possible d'utiliser les opérateurs d'ordre <, >, <=, >= !
Et il compare quoi le programme ? Ca veut dire quoi si j'écris "Avion" > "Bus" ?
Les opérateurs d'ordres utilisent l'ordre alphabétique et sont insensibles à la casse (Majuscule/Minuscule). La comparaison "Avion" > "Bus" devrait donc renvoyer false, à ceci prêt que le compilateur ne voudra pas que vous l'écriviez tel quel. Il préfèrera :
...
txt1 : string := "Avion" ;
txt2 : string := "Bus" ;
BEGIN
if txt1 > txt2
then ...
Saisie au clavier
Et si je souhaite saisir un nom directement au clavier ?
Alors il existe une fonction pour cela : get_line. Elle saisira tout ce que vous tapez au clavier jusqu'à ce que vous appuyiez sur Entrée (donc pas besoin d'utiliser skip_line par la suite) et renverra ainsi une chaîne de caractères :
Il existe une façon de gérer des chaînes de caractères sans être limité par leur longueur. Pour cela, vous aurez besoin du package Ada.Strings.Unbounded. Et nous déclarerons notre variable ainsi :
txt : unbounded_string ;
Cela signifie que txt sera une "chaîne de caractère illimitée" ! ! !
:p Wouhouh ! J'essaye ça tout de suite ! T'aurais du commencer par là ! ! !
Attendez ! Les unbounded_string ne s'utilisent pas de la même manière que les string normaux ! Simplement parce que leur nature est différente. Lorsque vous déclarez un tableau, par exemple :
txt : string(1..8) ;
L'ordinateur va créer en mémoire l'équivalent de ceci :
1
2
3
4
5
6
7
8
?
?
?
?
?
?
?
?
Lorsque vous déclarez un unbounded_string comme nous l'avons fait tout à l'heure, l'ordinateur créera ceci :
{ }
C'est en fait une liste, vide certes mais une liste tout de même. À cette liste, le programme ajoutera des caractères au fur et à mesure. Il n'est plus question d'indices, ce n'est plus un tableau. Nous verrons les listes après avoir vu les pointeurs, ce qui vous éclairera sur les limites du procédé.
Opérations sur les unbounded_string
Nous pouvons ensuite affecter une valeur à nos unbounded_string. Seulement il est impossible d'écrire ceci :
Pourquoi tu ne présentes pas ça sous la forme d'un tableau, ce serait plus clair et on n'aurait pas besoin de compter pour connaître l'emplacement d'un caractère ?
En effet, de nombreuses fonctionnalités liées aux tableaux ne sont plus disponibles. Voici donc quelques fonctions pour les remplacer :
n := length(txt) ; --la variable n (natural) prendra comme valeur la longueur de l'unbounded_string txt
char := Element(txt,5) ; -- la variable char (character) prendra la 5ème valeur de l'unbounded_string txt
Replace_Element(txt,6,char) ; --le 6ème élément de txt est remplacé par le character char
txt := Null_Unbounded_String ; --txt est réinitialisé en une liste vide
Une indication tout de même, si vous ne souhaitez utiliser qu'une certaine partie de votre unbounded_string et que vous voudriez écrire txt(5..8), vous pouvez vous en sortir en utilisant To_String() et To_Unbounded_String() de la manière suivante :
Comme vous pouvez vous en rendre compte, la manipulation des unbounded_strings est plus lourde que celle des strings. Voila pourquoi nous préfèrerons utiliser en général les strings, nous réserverons l'utilisation des unbounded_strings aux cas d'extrêmes urgence. :D
Nous voila à la fin de ce chapitre sur les strings et les unbounded_strings. Cela constitue également un bon exercice sur les tableaux. Dans le prochain chapitre, nous aborderons la programmation modulaire ou pour être plus clair, l'utilisation et la création de packages.
Ce chapitre sera encore l'occasion de travailler sur les tableaux. Puis, nous apprendrons à manipuler des fichiers, notamment les fichiers textes, et ce sera de nouveau un prétexte pour manipuler les strings et les unbounded_strings.
Bref, vous avez compris, la manipulation des tableaux est LE gros morceau de cette partie sur les types composites. Après cela, les tableaux n'auront plus aucun secret pour vous. ;)
Pour ce nouveau chapitre, nous allons revenir sur le chapitre sur les tableaux.
Encore des tableaux ? Avec les strings, ça va faire le troisième chapitre !
Rassurez-vous, les tableaux ne constitueront qu'un prétexte et non pas le coeur de ce chapitre. Nous avons vu tout ce qu'il y avait à voir sur les tableaux. Mais cela ne doit pas nous faire oublier leur existence, bien au contraire. Nous allons très régulièrement les utiliser. Mais, si vous avez effectué les exercices sur les tableaux, vous avez du vous rendre compte qu'il fallait très régulièrement réécrire les mêmes fonctions, les mêmes procédures, les mêmes déclarations de type ... Se pose alors la question : "Ne serait-il pas possible de mettre tout cela dans un fichier réutilisable à l'envie ?"
Et la réponse, vous vous en doutez, est oui ! Ces fichiers, ce sont les fameux packages !
Avant de créer notre premier package, nous allons créer un nouveau programme appelé Test. dans lequel nous allons pouvoir tester toutes les procédures, fonctions, types, variables que nous allons créer dans notre package. Voici la structure initiale de ce programme :
with Integer_Array ;
use Integer_Array ;
procedure Test is
T : T_Vecteur ;
begin
end Test ;
C'est quoi ce package integer_array et ce type T_Vecteur ?
Ce package integer_array, c'est justement le package que nous allons créer et le type T_Vecteur est un "array of integer" de longueur 10 (pour l'instant). Pour l'instant si l'on tente de compiler ce programme nous nous trouvons face à deux obstacles :
Il n'y a aucune instruction entre begin et end !
Le package Integer_Array est introuvable (tout simplement parce qu'il est inexistant)
Nous allons donc devoir créer ce package. Comment faire ? Vous allez voir, c'est très simple : cliquez sur File > New deux fois pour obtenir deux nouvelles feuilles vierges.
Deux fois ? On voulait pas créer un seul package ? Y a pas erreur ?
Non, non ! J'ai bien dit deux fois ! Vous comprendrez pourquoi ensuite. Sur l'une des feuilles, nous allons écrire le code suivant :
WITH Ada.Integer_Text_IO, Ada.Text_IO ;
USE Ada.Integer_Text_IO, Ada.Text_IO ;
PACKAGE BODY Integer_Array IS
END Integer_Array ;
Puis, dans le même répertoire que votre fichier Test.adb, enregistrer ce nouveau fichier sous le nom Integer_Array.adb.
Dans le second fichier vierge, écrivez :
PACKAGE Integer_Array IS
END Integer_Array ;
Enfin, toujours dans le même répertoire, enregistrer ce fichier sous le nom Integer_Array.ads !
Vous remarquerez que cela ressemble un peu à ce que l'on a l'habitude d'écrire, sauf qu'au lieu de créer une procédure, on crée un package.
Ca me dit toujours pas pourquoi je dois créer deux fichiers qui comportent peu ou prou la même chose ! :colere2:
Nous y arrivons. Pour comprendre, nous allons créer une procédure qui affiche un tableau. Vous vous souvenez ? Nous en avons déjà écrit plusieurs (souvent appelées Afficher). Moi, je décide que je vais l'appeler Put() comme c'est d'usage en Ada.
Euh ... il existe déjà des procédures Put() et elles ne sont pas faites pour les tableaux ! o_O Ca sent le plantage ça ... :-°
Encore une fois, rassurez-vous et faites moi confiance, tout va bien se passer et je vous expliquerai tout ça à la fin ("Oui, ça fait beaucoup de choses inexpliquées", dixit Mulder & Scully :soleil: ). Dans le fichier Test.adb, nous allons écrire
WITH Integer_Array ;
USE Integer_Array ;
PROCEDURE Test IS
T : T_Vecteur(1..10) ;
BEGIN
T := (others => 0) ;
Put(T,2) ;
END Test ;
Je voudrais en effet, que notre procédure Put() puisse également gérer le nombre de chiffres affichés, si besoin est. Puis dans le fichier Integer_Array.ads, nous allons ajouter ces lignes entre is et end :
TYPE T_Vecteur IS ARRAY(integer range <>) OF Integer ;
PROCEDURE Put (T : IN T_Vecteur; Fore : IN Integer := 11);
Je prends les devants : il n'y a aucune erreur, j'ai bien écrit un point-virgule à la fin de la procédure et pas le mot is. Pourquoi ? Pour la simple et bonne raison que notre fichier Integer_Array.ads n'est pas fait pour contenir des milliers de lignes de codes et d'instructions ! Il ne contient qu'une liste de tout ce qui existe dans notre package. On dit que la ligne "PROCEDURE Put (T : IN T_Vecteur; Fore : IN Integer := 11);" est le prototype de la procédure Put(). Le prototype de notre procédure ne contient pas les instructions nécessaires à son fonctionnement, il indique seulement au compilateur : "voilà, j'ai une procédure qui s'appelle Put() et qui a besoin de ces 2 paramètres !".
Le contenu de notre procédure, nous allons l'écrire dans notre fichier Integer_Array.adb, entre is et end. Vous pouvez soit reprendre l'une de vos procédures d'affichage déjà créées et la modifier, soit recopier la procédure ci-dessous :
PROCEDURE Put(T : IN T_Vecteur ; Fore : IN Integer := 11) IS
BEGIN
FOR I IN T'RANGE LOOP
Put(T(I),Fore) ;
put(" ; ") ;
END LOOP ;
END Put ;
Enregistrer vos fichiers, compiler votre programme Test.adb et lancez-le : vous obtenez une jolie suite de 0 séparés par des points virgules. Cela nous fait donc un total de trois fichiers, dont voici les codes :
Test.adb :
WITH Integer_Array ;
USE Integer_Array ;
PROCEDURE Test IS
T : T_Vecteur(1..10) ;
BEGIN
T := (others => 0) ;
Put(T,2) ;
END Test ;
Integer_Array.ads :
PACKAGE Integer_Array IS
TYPE T_Vecteur IS ARRAY(Integer range <>) OF Integer ;
PROCEDURE Put (T : IN T_Vecteur; Fore : IN Integer := 11);
END Integer_Array ;
Integer_Array.adb :
WITH Ada.Integer_Text_IO, Ada.Text_IO ;
USE Ada.Integer_Text_IO, Ada.Text_IO ;
PACKAGE BODY Integer_Array IS
PROCEDURE Put(T : IN T_Vecteur ; Fore : IN Integer := 11) IS
BEGIN
FOR I IN T'RANGE LOOP
Put(T(I),Fore) ;
put(" ; ") ;
END LOOP ;
END Put ;
END Integer_Array ;
Nous pourrions résumer la situation par ce schéma :
Reste l'histoire de la procédure Put(). La procédure Put() ne constitue pas un mot réservé du langage, pour l'utiliser vous êtes obligés de faire appel à un package :
Integer_Text_IO pour afficher un Integer ;
Float_text_IO pour afficher un float ;
notre package Integer_Array pour afficher un T_Vecteur.
À chaque fois, c'est une procédure Put() différente qui apparaît et ce qui les différencie pour le compilateur, ce sont le nombre et le type des paramètres de ces procédures. En cas d'hésitation, le compilateur vous demandera de spécifier de quelle procédure vous parlez en écrivant :
Pour l'heure, notre package ne contient pas grand chose : le type T_Vecteur et une procédure Put(). Il nous faut donc le compléter. De quoi avons-nous besoin ?
Des procédures d'affichage,
Des procédures de création,
Des fonctions de tri,
Des fonctions pour les opérations élémentaires.
Procédures d'affichage
PROCEDURE Put(T : IN T_Vecteur ; FORE : IN integer := 11) ;
PROCEDURE Put_line(T : IN T_Vecteur ; FORE : IN integer := 11) ;
PROCEDURE Put_Column(T : IN T_Vecteur ; FORE : IN integer := 11 ; Index : IN Boolean := true) ;
Procédures de création
PROCEDURE Get(T : IN OUT T_Vecteur) ;
PROCEDURE Init(T : IN OUT T_Vecteur ; Val : IN integer := 0) ;
PROCEDURE Generate(T : IN OUT T_Vecteur ; Min : integer := integer'first ; Max : integer := integer'last) ;
Fonctions de tri
FUNCTION Tri_Selection(T : T_Vecteur) RETURN T_Vecteur ;
Voici les packages Integer_Array.adb et Integer_Array.ads tels que je les ai écrits. Je vous conseille d'essayer de les écrire par vous-même avant de copier-coller ma solution, ce sera un très bon entraînement. ;) Autre conseil, pour les opérations élémentaires, je vous invite à lire la sous-partie qui suit afin de comprendre les quelques ressorts mathématiques.
Integer_Array.adb :
WITH Ada.Integer_Text_IO, Ada.Text_IO, Ada.Numerics.Discrete_Random ;
USE Ada.Integer_Text_IO, Ada.Text_IO ;
package body Integer_Array IS
--------------------------
--Procédures d'affichage--
--------------------------
PROCEDURE Put (
T : IN T_Vecteur;
Fore : IN Integer := 11) IS
BEGIN
FOR I IN T'RANGE LOOP
Put(T(I),Fore) ;
put(" ; ") ;
END LOOP ;
END Put ;
PROCEDURE Put_Column (
T : IN T_Vecteur;
Fore : IN Integer := 11) IS
BEGIN
FOR I IN T'RANGE LOOP
Put(T(I),Fore) ;
new_line ;
END LOOP ;
END Put_Column ;
PROCEDURE Put_Line (
T : IN T_Vecteur;
Fore : IN Integer := 11) IS
BEGIN
Put(T,Fore) ;
New_Line ;
END Put_line ;
------------------------
--Procédures de saisie--
------------------------
PROCEDURE Init (
T : OUT T_Vecteur;
Value : IN Integer := 0) IS
BEGIN
T := (OTHERS => Value) ;
END Init ;
procedure generate(T : in out T_Vecteur ; min : in integer := integer'first ; max : in integer := integer'last) is
subtype Random_Range is integer range min..max ;
Package Random_Array is new ada.Numerics.Discrete_Random(Random_Range) ;
use Random_Array ;
G : generator ;
begin
reset(G) ;
T := (others => random(g)) ;
end generate ;
procedure get(T : in out T_Vecteur) is
begin
for i in T'range loop
put(integer'image(i) & " : ") ;
get(T(i)) ;
skip_line ;
end loop ;
end get ;
--------------------
--Fonctions de tri--
--------------------
function Tri_Selection(T : T_Vecteur) return T_Vecteur is
function RangMin(T : T_Vecteur ; debut : integer ; fin : integer) return integer is
Rang : integer := debut ;
Min : integer := T(debut) ;
begin
for i in debut..fin loop
if T(i)<Min
then Min := T(i) ;
Rang := i ;
end if ;
end loop ;
return Rang ;
end RangMin ;
procedure Echanger(a : in out integer ; b : in out integer) is
c : integer ;
begin
c := a ;
a := b ;
b := c ;
end Echanger ;
Tab : T_Vecteur := T ;
begin
for i in Tab'range loop
Echanger(Tab(i),Tab(RangMin(Tab,i,Tab'last))) ;
end loop ;
return Tab ;
end Tri_Selection ;
---------------------------
--Opérations élémentaires--
---------------------------
function Somme(T:T_Vecteur) return integer is
S : integer := 0 ;
begin
for i in T'range loop
S:= S + T(i) ;
end loop ;
return S ;
end somme ;
FUNCTION "+" (Left,Right : T_Vecteur) return T_Vecteur is
T : T_Vecteur ;
begin
for i in Left'range loop
T(i) := Left(i) + Right(i) ;
end loop ;
return T ;
end "+" ;
FUNCTION "*" (Left : integer ; Right : T_Vecteur) return T_Vecteur is
T : T_Vecteur ;
begin
for i in Right'range loop
T(i) := Left * Right(i) ;
end loop ;
return T ;
end "*" ;
FUNCTION "*" (Left,Right : T_Vecteur) return Integer is
S : Integer := 0 ;
begin
for i in Left'range loop
S := S + Left(i) * Right(i) ;
end loop ;
return S ;
end "*" ;
FUNCTION Minimum(T : T_Vecteur) return integer is
min : integer := T(T'first) ;
BEGIN
FOR I in T'range loop
if T(i)<min
then min := T(i) ;
end if ;
end loop ;
return min ;
end Minimum ;
FUNCTION Maximum(T : T_Vecteur) return integer is
max : integer := T(T'first) ;
BEGIN
FOR I in T'range loop
if T(i)>max
then max := T(i) ;
end if ;
end loop ;
return max ;
end Maximum ;
END Integer_Array ;
Integer_Array.ads :
PACKAGE Integer_Array IS
-------------------------------------
--Définition des types et variables--
-------------------------------------
Taille : CONSTANT Integer := 10;
TYPE T_Vecteur IS ARRAY(1..Taille) OF Integer ;
--------------------------
--Procédures d'affichage--
--------------------------
PROCEDURE Put (
T : IN T_Vecteur;
Fore : IN Integer := 11);
PROCEDURE Put_Column (
T : IN T_Vecteur;
Fore : IN Integer := 11);
PROCEDURE Put_Line (
T : IN T_Vecteur;
Fore : IN Integer := 11);
------------------------
--Procédures de saisie--
------------------------
PROCEDURE Init (
T : OUT T_Vecteur;
Value : IN Integer := 0);
PROCEDURE Generate (
T : IN OUT T_Vecteur;
Min : IN Integer := Integer'First;
Max : IN Integer := Integer'Last);
PROCEDURE Get (
T : IN OUT T_Vecteur);
--------------------
--Fonctions de tri--
--------------------
function Tri_Selection(T : T_Vecteur) return T_Vecteur ;
---------------------------
--Opérations élémentaires--
---------------------------
function Somme(T:T_Vecteur) return integer ;
FUNCTION "+" (Left,Right : T_Vecteur) return T_Vecteur ;
FUNCTION "*" (Left : integer ; Right : T_Vecteur) return T_Vecteur ;
FUNCTION "*" (Left,Right : T_Vecteur) return Integer ;
FUNCTION Minimum(T : T_Vecteur) return integer ;
FUNCTION Maximum(T : T_Vecteur) return integer ;
END Integer_Array ;
Vous remarquerez que j'utilise autant que possible les attributs et agrégats. Pensez que vous serez amenés à réutiliser ce package régulièrement et sûrement aussi à modifier la longueur de nos tableaux T_Vecteur. Il ne faut pas que vous ayez besoin de relire toutes vos procédures et fonctions pour les modifier !
Depuis le début de ce chapitre, nous parlons de T_Vecteur au lieu de tableau à une dimension, pourquoi ?
Le terme T_Vecteur (ou Vector) n'est pas utilisé par le langage Ada, contrairement à d'autres (voir C, C++). Pour Ada, cela reste toujours un array. Mais des analogies peuvent être faites avec l'objet mathématique appelé T_Vecteur. Alors, sans faire un cours de Mathématiques, qu'est-ce qu'un T_Vecteur ?
De manière (très) schématique un T_Vecteur est la représentation d'un déplacement, symbolisé par une flèche :
Ainsi, sur le schéma ci-dessus, le T_Vecteur se déplace de 3 unités vers la droite et de 1 unité vers le haut. Il représente donc le même déplacement que le T_Vecteur et on peut écrire (on remarquera que ces T_Vecteurs sont "parallèles", de même "longueur" et dans le même sens). Du coup, on peut dire que ces deux T_Vecteurs ont comme coordonnées : ou , ce qui devrait commencer à vous rappeler nos tableaux, non ? :lol: Pour les récalcitrants, sachez qu'il est possible en Mathématiques de travailler avec des T_Vecteurs en 3, 4, 5 ... dimensions. Les coordonnées d'un T_Vecteur ressemblent alors à cela :
ou
Ca ressemble sacrément à nos tableaux T_Vecteurs non ? :p
Calcul vectoriel
Plusieurs opérations sont possibles sur les T_Vecteurs. Tout d'abord, l'addition ou Relation de Chasles. Sur le schéma ci-dessus, chacun des T_Vecteurs ou a été décomposé en deux T_Vecteurs noirs tracés en pointillés : que l'on aille de A à B en suivant le T_Vecteur ou en suivant le premier T_Vecteur noir puis le second, le résultat est le même, on arrive en B ! Eh bien, suivre un T_Vecteur puis un autre, cela revient à les additionner. D'où la formule :
Il est aussi possible de multiplier un T_Vecteur par un nombre. Cela revient simplement à l'allonger ou à le rétrécir (notez que multipliez un T_Vecteur par un nombre négatif changera le sens du T_Vecteur). Par exemple :
Troisième opération : le produit scalaire. Il s'agit ici de multiplier deux T_Vecteurs entre eux. Nous ne rentrerons pas dans le détail, ce serait trop long à expliquer et sans rapport avec notre sujet. Voici comment effectuer le produit scalaire de deux T_Vecteurs :
Bien, nous en avons fini avec l'explication mathématique des T_Vecteurs. Pour ceux qui ne connaissaient pas les T_Vecteurs, ceci devrait avoir quelque peu éclairci votre lanterne. Pour ceux qui les connaissaient déjà, vous me pardonnerez d'avoir pris quelques légèretés avec la rigueur mathématique pour pouvoir "vulgariser" ce domaine fondamental des Maths.
Nous avons maintenant un joli package Integer_Array. Nous pourrons l'utiliser aussi souvent que possible, dès lors que nous aurons besoin de tableaux à une seule dimension contenant des integers. Il vous est possible également de créer un package Integer_Array2D pour les tableaux à deux dimensions.
Mais surtout, conserver ce package car nous le complèterons au fur et à mesure avec de nouvelles fonctions de tri, plus puissantes et efficaces, notamment lorsque nous aborderons la récursivité ou les notions de complexité d'algorithme. Lors du chapitre sur la généricité, nous ferons en sorte que ce package puisse être utilisé avec des float, des natural, ... Bref, nous n'avons pas fini de l'améliorer.
Qui plus est, vous avez sûrement remarqué que ce chapitre s'appelle "La programmation modulaire I". C'est donc que nous aborderons plus tard un chapitre "La programmation modulaire II". Mais rassurez-vous, vous en savez suffisamment aujourd'hui pour créer vos packages. Le chapitre II permettra seulement d'améliorer nos packages et ce sera l'occasion d'aborder les notions d'héritage et de privatisation.
Nos programmes actuels souffrent d'un grave inconvénient : tout le travail que nous pouvons effectué, tous les résultats obtenus, toutes les variables enregistrées en mémoire vive ... ont une durée qui se limite à la durée d'utilisation de notre programme. Sitôt fermé, nous perdons toutes ces données, alors qu'elle pourraient s'avérer fort utiles pour une future utilisation.
Il serait donc utile de pouvoir les enregistrer, non pas en mémoire vive, mais sur le disque dur. Et, pour cela, nous devons être capable de créer des fichiers, de les lire ou de les modifier. C'est d'ailleurs ainsi que procèdent la plupart des logiciels. Word ou OpenOffice ont besoin d'enregistrer le travail effectué par l'utilisateur dans un fichier .doc, .odt ... De même, n'importe quel jeu a besoin de créer des fichiers de sauvegardes mais aussi de lire continuellement des fichiers (les images ou les vidéos notamment) s'il veut fonctionner correctement.
C'est donc aux fichiers que nous allons nous intéresser dans ce chapitre. Vous allez voir, cela ne sera pas très compliqué, car vous disposez déjà de la plupart des notions nécessaires. Il y a juste quelques points à comprendre avant de pouvoir nous amuser. ;)
Nous allons voir plusieurs types de fichiers utilisables en Ada. Le premier type est le fichier texte. La première chose à faire lorsque l'on veut manipuler un fichier, c'est de l'ouvrir ! :p Cette remarque peut paraître idiote et pourtant : toute modification d'un fichier existant ne peut se faire que si votre programme a préalablement ouvert le fichier concerné. Et bien entendu, la dernière chose à faire est de le fermer.
Package nécessaire
Le package à utiliser, vous le connaissez déjà : Ada.Text_IO ! Le même que nous utilisions pour afficher du texte ou en saisir sur l'écran de la console. En fait, la console peut être considérée comme une sorte de fichier qui s'ouvre et se ferme automatiquement.
Le type de l'objet
Comme toujours, nous devons déclarer nos variables ou nos objets avant de pouvoir les manipuler. Nous allons créer un objet-fichier qui fera le lien avec le vrai fichier texte :
MonFichier : File_type ;
Fermer un fichier
Pour fermer un fichier, rien de plus simple, il suffit de taper l'instruction suivante (toujours entre begin et end, bien sûr :
close(MonFicher) ;
Euh... avant de le fermer, ne vaudrait-il pas mieux l'ouvrir ? :o
En effet ! :D Si vous fermez un fichier qui n'est pas ouvert, alors vous aurez droit à cette magnifique erreur :
raised ADA.IO_EXCEPTIONS.STATUS_ERROR : file not open
Il faut donc ouvrir avant de fermer ! Mais je commence par la fermeture car c'est ce qu'il y a de plus simple ^^
Ouvrir un fichier
Il y a une subtilité lorsque vous désirez ouvrir un fichier, je vous demande donc de lire toute cette partie et la suivante en me faisant confiance : pas de questions, j'y répondrai par la suite. Il faut distinguer deux cas pour ouvrir un fichier :
Soit ce fichier existe déjà.
Soit ce fichier n'existe pas encore.
Ouvrir un fichier existant
Voici le prototype de l'instruction permettant d'ouvrir un fichier existant :
procedure open(File : in out file_type ;
Mode : in File_Mode := Out_File ;
Name : in string) ;
File est le nom de l'objet-fichier : ici, nous l'avons appelé MonFichier. Nous reviendrons dans la partie suivante sur Mode, pour l'instant nous allons l'ignorer vu qu'il est déjà prédéfini. Name est le nom du fichier concerné, extension comprise. Par exemple, si notre fichier a l'extension .txt et s'appelle enregistrement alors Name doit valoir "enregistrement.txt". Nous pouvons ainsi taper le code suivant :
WITH Ada.Text_IO ;
USE Ada.Text_IO ;
PROCEDURE TestFichier IS
MonFichier : File_type ;
BEGIN
open(MonFichier,Name => "enregistrement.txt") ;
close(MonFichier) ;
END TestFichier ;
Seul souci, si le compilateur ne voit aucune erreur, la console nous affiche toutefois ceci :
raised ADA.IO_EXCEPTIONS.NAME_ERROR : enregistrement.txt: No error
Le fichier demandé n'existe pas. Deux possibilités :
Soit vous le créez "à la main" dans le même répertoire que votre programme.
Soit vous lisez la sous-sous-partie suivante. :p
Créer un fichier
Voici le prototype de l'instruction permettant la création d'un fichier :
procedure Create(File : in out File_Type;
Mode : in File_Mode := Out_File;
Name : in String);
Elle ressemble beaucoup à la procédure open(). Et pour cause, elle fait la même chose (ouvrir un fichier) à la différence qu'elle commence par créer le fichier demandé. Nous pouvons donc écrire le code suivant :
WITH Ada.Text_IO ;
USE Ada.Text_IO ;
PROCEDURE TestFichier IS
MonFichier : File_type ;
BEGIN
create(MonFichier,Name => "enregistrement.txt") ;
close(MonFichier) ;
END TestFichier ;
Et cette fois pas d'erreur après compilation ! Ca marche !
Euh... ça marche, ça marche ... c'est vite dit. Il se passe absolument rien ! Je pensais que mon programme allait ouvrir le fichier texte et que je le verrais à l'écran !
Dans l'exemple donné ci-dessus, notre programme ouvre un fichier, et ne fait rien de plus que de le fermer. Pas d'affichage, pas de modification ... Nous verrons dans ce chapitre comment modifier le fichier, mais nous ne verrons que beaucoup plus tard comment l'afficher (dernière partie du cours).
Alors deuxième question : que se passe-t-il si le fichier existe déjà ?
Eh bien testez ! C'est la meilleure façon de le savoir. Si vous avez déjà lancé votre programme, alors vous disposez d'un fichier "enregistrement.txt". Ouvrez-le avec NotePad par exemple et tapez quelques mots dans ce fichier. Enregistrez, fermez et relancez votre programme. Ouvrez à nouveau votre fichier : il est vide !
La procédure open() se contente d'ouvrir le fichier, mais celui-ci doit déjà exister. La procédure create() crée le fichier, quoiqu'il arrive. Si un fichier porte déjà le même nom, il est supprimé et remplacé par un nouveau, vide.
Détruire un fichier
Puisqu'il est possible de créer un fichier, il doit être possible de le supprimer ?
Tout à fait. Voici le prototype de la procédure en question :
Nous avons laissé une difficulté de côté tout à l'heure : le paramètre mode. Il existe trois modes possibles pour les fichiers en Ada (et dans la plupart des langages) :
Lecture seule : In_File
Ecriture seule : Out_File
Ajout : Append_File
Ca veut dire quoi ?
Lecture seule
En mode Lecture seule, c'est à dire si vous écrivez ceci :
Open(MonFichier,In_File,"enregisrement.txt") ;
Vous ne pourrez que lire ce qui est écrit dans le fichier, impossible de le modifier. C'est un peu comme si notre fichier était un paramètre en mode in.
Ecriture seule
En mode Ecriture seule, c'est à dire si vous écrivez ceci :
Open(MonFichier,Out_File,"enregisrement.txt") ;
Vous ne pourrez qu'écrire dans le fichier à partir du début, en écrasant éventuellement ce qui est déjà écrit, impossible de lire ce qui existe déjà. C'est un peu comme si notre fichier était un paramètre en mode out.
Ajout
Le mode Ajout, c'est à dire si vous écrivez ceci :
Vous pourrez écrire dans le fichier, comme en mode Out_File. La différence, c'est que vous n'écrirez pas en partant du début, mais de la fin. Vous ajouterez des informations à la fin au lieu de supprimer celles existantes.
Et il n'y aurait pas un mode in out des fois ?
Eh bien non. Il va falloir faire avec. D'ailleurs, même Word ne peut guère faire mieux : soit il écrit dans le fichier au moment de la sauvegarde, soit il le lit au moment de l'ouverture. Les autres opérations (mise en gras, changement de police, texte nouveau...) ne sont pas effectuées dans le fichier mais dans Word et ne seront inscrites dans le fichier que si Word les enregistre.
Une fois notre fichier ouvert, il serait bon de pouvoir effectuer quelques opérations avec. Attention, les opérations disponibles ne seront pas les mêmes selon que vous avez ouvert votre fichier en mode In_File ou en mode Out_File/Append_File !
Mode lecture seule : In_File
Saisir un caractère
Tout d'abord vous allez devoir tout au long de ce chapitre imaginez votre fichier et l'emplacement du curseur :
Dans l'exemple ci-dessus, vous pouvez vous rendre compte que mon curseur se trouve à la seconde ligne, vers la fin du mot "situé". Ainsi, si je veux connaître le prochain caractère, je vais devoir utiliser la procédure get() que vous connaissez déjà, mais de manière un peu différente :
procedure Get (File : in File_Type; Item : out Character);
Comme vous pouvez vous en rendre compte en lisant ce prototype, il ne suffira pas d'indiquer entre les parenthèses dans quelle variable de type character vous voulez enregistrer le caractère saisi, il faudra aussi indiquer dans quel fichier ! Comme dans l'exemple ci-dessous :
Get(MonFichier,C) ;
Autre remarque d'importance : si vous êtes en fin de ligne, en fin de page ou en fin de fichier, vous aurez droit à un joli message d'erreur ! Le curseur ne retourne pas automatiquement à la ligne. Pour pallier à cela, deux possibilités. Première possibilité : vous pouvez utiliser préalablement les fonctions suivantes :
function End_Of_Line (File : in File_Type) return Boolean;
function End_Of_Page (File : in File_Type) return Boolean;
function End_Of_File (File : in File_Type) return Boolean;
Elle renvoient true si vous êtes, respectivement, en fin de ligne, en fin de page ou en fin de fichier. Selon les cas, vous devrez alors utiliser ensuite les procédures :
procedure Skip_Line (File : in File_Type; Spacing : in Positive_Count := 1);
procedure Skip_Page (File : in File_Type);
procedure Reset (File : in out File_Type);
Skip_line(MonFichier) vous permettra de passer à la ligne suivante (nous l'utilisions jusque là pour vider le tampon). Il est même possible de lui demander de sauter plusieurs lignes grâce au paramètre Spacing en écrivant Skip_Line(MonFichier,5). Skip_Page(MonFichier) vous permettra de passer à la page suivante. Reset(MonFichier) aura pour effet de remettre votre curseur au tout début du fichier. D'où le code suivant :
loop ;
if end_of_line(MonFichier)
then skip_line(MonFichier) ;
elsif end_of_page(MonFichier)
then skip_page(MonFichier) ;
elsif end_of_file(MonFichier)
then reset(MonFichier) ;
else get(C) ; exit ;
end if ;
end loop ;
Cette boucle permet de traiter les différents cas possibles et de recommencer tant que l'on n'a pas saisi un vrai caractère ! Attention, si le fichier est vide, vous risquez d'attendre un moment :p
Deuxième possibilité :
procedure Look_Ahead(File : in File_Type;
Item : out Character;
End_Of_Line : out Boolean);
Cette procédure ne fait pas avancer le curseur mais regarde ce qui se trouve après : si l'on se trouve en fin de ligne, de page ou de fichier, le paramètre End_Of_Line vaudra true et le paramètre Item ne vaudra rien du tout. Dans le cas contraire, End_Of_Line vaudra false et Item aura la valeur du caractère suivant. Je le répète, le curseur n'est pas avancé dans ce cas là ! Exemple avec une variable fin de type boolean et une variable C de type Character :
Look_Ahead(MonFichier,C,fin);
if not fin
then put("Le caractère vaut :") ; put(C) ;
else put("C'est la fin des haricots !") ;
end if ;
Saisir un string
Pour saisir directement une ligne et pas un seul caractère, vous pourrez utiliser l'une des procédures dont voici les prototypes :
procedure Get (File : in File_Type; Item : out String);
procedure Get_Line(File : in File_Type ; Item : out String ; Last : out Natural);
function Get_Line(File : in File_Type) return string ;
La procédure Get() saisit tout le texte présent dans l'objet-fichier File et l'enregistre dans le string Item (le curseur se trouve alors à la fin du fichier). La procédure get_line() saisit tout le texte situé entre le curseur et la fin de la ligne et l'affecte dans le string Item ; elle renvoie également la longueur de la chaîne de caractère dans la variable Last (le curseur sera alors placé au début de la ligne suivante). Enfin, la fonction Get_line se contente de renvoyer le texte entre le curseur et la fin de ligne (comme la procédure, seule l'utilisation et l'absence de paramètre last diffèrent).
Mais nous nous retrouvons face à un inconvénient de taille : nous ne connaissons pas à l'avance la longueur des lignes et donc la longueur des strings qui seront retournés. A cela, deux solutions : soit nous utilisons des strings suffisamment grands en priant pour que les lignes ne soient pas plus longues (et il faudra prendre quelques précautions à l'affichage), soit nous faisons appel aux unbounded_strings :
Première méthode :
...
S : string(1..100) ;
MonFichier : file_type ;
long : natural ;
BEGIN
open(MonFichier, In_File, "enregistrement.txt") ;
get_line(MonFichier, S, long) ;
put_line(S(1..long)) ;
...
Vous devriez commencer à vous douter des opérations d'écriture applicables aux fichiers textes, car , à dire vrai, vous les avez déjà vues. Voici quelques prototypes :
procedure New_Line (File : in File_Type; Spacing : in Positive_Count := 1);
procedure New_Page (File : in File_Type);
procedure Put (File : in File_Type; Item : in Character);
procedure Put (File : in File_Type; Item : in String);
procedure Put_Line(File : in File_Type; Item : in String);
Ai-je besoin de tout réexpliquer ? J'espère que non, mais si certains en ont tout de même besoin, les explications sont cachées ci-dessous.
New_line() insère un saut de ligne dans notre fichier à l'emplacement du curseur (par défaut, mais le paramètre spacing permet d'insérer 2, 3, 4 ... sauts de lignes). New_Page() insére un saut de page. Les procédures Put() permettent d'insérer un caractère ou toute une chaîne de caractères. La procédure put_line() insère une chaîne de caractères et un saut de ligne.
Autres opérations
Il existe également quelques fonctions ou procédures utilisables quelle que soient les modes ! En voici quelques-unes pour se renseigner sur notre fichier :
Pour connaître le mode dans lequel un fichier est ouvert (In_File, Out_File, Append_File). Permet d'éviter des erreurs de manipulation.
function Mode (File : in File_Type) return File_Mode;
Pour connaître le nom du fichier ouvert.
function Name (File : in File_Type) return String;
Pour savoir si un fichier est ouvert ou non. Pour éviter de fermer un fichier déjà fermé, ou d'ouvrir un fichier déjà ouvert etc ...
function Is_Open (File : in File_Type) return Boolean;
Et en voici quelques autres pour déplacer le curseur ou se renseigner sur sa position. Pour information, le type Positive_Count sont en fait des natural mais 0 en est exclu (les prototypes ci-dessous sont écrits tels qu'ils le sont dans le package Ada.Text_IO).
Pour placer le curseur à une certaine colonne.
procedure Set_Col (File : in File_Type; To : in Positive_Count);
Pour placer le curseur à une certaine ligne.
procedure Set_Line (File : in File_Type; To : in Positive_Count);
Pour connaître la colonne où se situe le curseur.
function Col (File : in File_Type) return Positive_Count;
Pour connaître la ligne où se situe le curseur.
function Line (File : in File_Type) return Positive_Count;
Pour connaître la page où se situe le curseur.
function Page (File : in File_Type) return Positive_Count;
Et on ne peut manipuler que des fichiers contenant du texte ? Comment je fais si je veux enregistrer les valeurs contenues dans un tableau par exemple ? Je dois absolument utiliser les attributs 'image et 'value ?
Non, le fichier texte n'est pas obligatoire, mais il a l'avantage d'être modifiable par l'utilisateur grâce à un simple éditeur de texte, type notepad par exemple. Mais si vous ne souhaitez qu'enregistrer des integer (par exemple), il est possible d'enregistrer vos données dans des fichiers binaires prévus à cet effet.
C'est quoi un fichier binaire ?
C'est un fichier constitué d'une suite de bits (les chiffres 0 et 1, seuls chiffres connus de l'ordinateur). Ca ne vous aide pas beaucoup ? :( Eh bien c'est le but. :p Ces fichiers contiennent une suite d'informations illisibles par l'utilisateur. Pour pouvoir lire ces données, il faut faire appel à un logiciel qui connaitra le type d'informations contenues dans le fichier et qui saura comment les traiter. Par exemple :
Les fichiers MP3, sont illisibles par le commun des mortels. En revanche, en utilisant un logiciel tel VLC ou amarok vous pourrez écouter votre morceau de musique.
Les fichiers images (.bmp, .tiff, .png, . jpg, .gif ...) ne seront lisibles qu'à l'aide d'un logiciel comme photofiltre par exemple.
On pourrait encore multiplier les exemples, la plupart des fichiers utilisés aujourd'hui étant des fichiers binaires.
Parmi ces fichiers binaires, il en existe deux sortes : les fichiers séquentiels et les fichiers à accès direct. La différence fondamentale réside dans la façon d'accéder aux données qu'ils contiennent. Les premiers sont utilisables comme les fichiers textes (qui sont eux-même des fichiers séquentiels), c'est pourquoi nous allons les aborder de ce pas. Les seconds sont utilisés un peu différemment, et nous les verrons dans la sous-partie suivante.
Nous allons créer un programme Enregistrer qui, comme son nom l'indique, enregistrera des données de type integer dans un fichier binaire à accès séquentiel. Nous devons d'abord régler le problème des packages. Celui que nous allons utiliser ici est Ada.sequential_IO. Le souci, c'est qu'il est fait pour tous les types de données (float, natural, array, string, integer, character ...), on dit qu'il est générique (nous aborderons cette notion dans la quatrième partie de ce cours). La première chose à faire est donc de créer un package plus spécifique :
WITH Ada.Sequential_IO, Ada.Integer_Text_IO ;
USE ada.Integer_Text_IO ;
PROCEDURE Enregistrer IS
PACKAGE integer_file IS NEW Ada.Sequential_IO(integer) ;
USE integer_file ;
...
Comme vous pouvez le remarquer, Ada.Sequential_IO n'est pas déclaré après USE (du fait de sa généricité) et doit être "redéclaré" plus loin : nous créeons un package integer_file qui est en fait le package Ada.Sequential_IO mais réservé aux données de type integer. Et nous pouvons ensuite écrire notre clause use integer_file. Nous avons déjà vu ce genre de chose durant notre premier TP pour créer des nombres aléatoires. Je ne vais pas m'étendre davantage sur cette notion un peu compliquée car nous y reviendrons plus tard.
Nous allons ensuite déclarer notre objet-fichier, notre type T_Tableau et notre objet T de type T_Tableau. Je vous laisse le choix dans la manière de saisir les valeurs de T. Puis nous allons devoir créer notre fichier, l'ouvrir et le fermer :
...
MonFichier : File_Type ; --tout ça c'est du déjà vu
type T_Tableau is array(1..5,1..5) of integer ;
T : T_Tableau ;
BEGIN
-----------------------------------------
-- Saisie libre de T (débrouillez-vous)--
-----------------------------------------
create(MonFichier,Out_File,"sauvegarde.inf") ;
-------------------------------
-- enregistrement (vu après) --
-------------------------------
close(MonFichier) ;
END Enregistrer ;
Comme je vous l'ai dit, l'encart "Saisie libre de T" est à votre charge (affectation au clavier, aléatoire ou prédéterminée, à vous de voir). La procédure create() peut être remplacée par la procédure open(), comme nous en avions l'habitude avec les fichiers textes. Les modes d'ouverture (In_File, Out_File, Append_File) sont également les mêmes. Concentrons-nous plutôt sur le deuxième encart : comment enregistrer nos données ? Les procédures put_line() et put() ne sont plus utilisables ici ! En revanche, elles ont une "sœur jumelle" : write() ! Traduction pour les anglophobes : "écrire". Notre second encart va donc pouvoir être remplacé par ceci :
...
for i in T'range(1) loop
for j in T'range(2) loop
write(MonFichier,T(i,j)) ;
end loop ;
end loop ;
...
Compiler votre code et exécutez-le. Un fichier "sauvegarde.inf" doit avoir été créé. Ouvrez-le avec le bloc-notes : il affiche des symboles bizarres, mais rien de ce que vous avez enregistré ! Je vous rappelle qu'il s'agit d'un fichier binaire ! Donc il est logique qu'il ne soit pas lisible avec un simple éditeur de texte. Pour le lire, nous allons créer, dans le même répertoire, un second programme : Lire. Il faudra donc "redéclarer" notre package integer_file et tout et tout. ;) Pour la lecture, nous ne pouvons, bien entendu, pas non plus utilisé get() ou get_line(). Nous utiliserons la procédure read() (traduction : lire) pour obtenir les informations voulues et la fonction Enf_Of_File() pour être certains de ne pas saisir de valeur une fois rendu à la fin du fichier (à noter que les fins de ligne ou fins de page n'existe pas dans un fichier binaire).
WITH Ada.Sequential_IO, Ada.Integer_Text_IO ;
USE ada.Integer_Text_IO ;
PROCEDURE Lire IS
PACKAGE integer_file IS NEW Ada.Sequential_IO(integer) ;
USE integer_file ;
MonFichier : File_Type ;
type T_Tableau is array(1..5,1..5) of integer ;
T : T_Tableau ;
BEGIN
open(MonFichier,In_File,"sauvegarde.dat") ;
for i in T'range(1) loop
for j in T'range(2) loop
exit when Enf_Of_File(MonFichier) ;
read(MonFichier,T(i,j)) ;
put(T(i,j)) ;
end loop ;
end loop ;
close(MonFichier) ;
END Lire ;
Voilà, nous avons dors et déjà fait le tour des fichiers binaires à accès séquentiel. Le principe n'est guère différent des fichiers textes (qui sont, je le rappelle, eux aussi à accès séquentiels), retenez simplement que put() est remplacé par write(), que get() est remplacé par read() et qu'il faut préalablement spécifier le type de données enregistrées dans vos fichiers. Nous allons maintenant attaquer les fichiers binaires à accès direct. :pirate:
Les fichiers binaires à accès directs fonctionnent à la manière d'un tableau. Chaque élément enregistré dans le fichier est doté d'un numéro, d'un indice, comme dans un tableau. Tout accès à une valeur, que ce soit en lecture ou en écriture, se fait en indiquant cet indice. Première conséquence et première grande différence avec les fichiers séquentiels, le mode Append_File n'est plus disponible. En revanche, un mode InOut_File est enfin disponible ! :D
Nous allons enregistrer cette fois les valeurs contenues dans un tableau de float unidimensionnel. Nous utiliserons donc le package Ada.Direct_IO qui, comme Ada.Sequential_IO, est un package générique (fait pour tous types de données). Il nous faudra donc créer un package comme précédemment avec integer_file (mais à l'aide de Ada.Direct_IO cette fois). Voici le code de ce programme :
WITH Ada.Direct_IO, Ada.Float_Text_IO ;
USE Ada.Float_Text_IO ;
PROCEDURE FichierDirect IS
PACKAGE float_file IS NEW Ada.Direct_IO(Float) ;
USE float_file ;
MonFichier : File_Type ;
TYPE T_Vecteur IS ARRAY(1..8) OF Float ;
T : T_Vecteur := (1.0,2.0,4.2,6.5,10.0,65.2,5.3,101.01);
x : float ;
BEGIN
create(MonFichier,InOut_File,"vecteur.inf") ;
for i in 1..8 loop
write(MonFichier,T(i),count(i)) ;
read(MonFichier,x,count(i)) ;
put(x) ;
end loop ;
close(MonFichier) ;
END FichierDirect ;
Là encore, si vous tentez d'ouvrir votre fichier "vecteur.inf", vous aurez droit à un joli texte incompréhensible.
En effet, l'instruction set_index() place le curseur à l'endroit voulu, et il existe une deuxième procédure write() qui ne spécifie pas l'indice où vous souhaitez écrire. Cette procédure écrit donc là où se trouve le curseur. Et il en est de même pour la procédure Read().
Créer un fichier texte appelé "poeme.txt" et dans lequel vous copierez le texte suivant :
Que j'aime a faire apprendre un nombre utile aux sages ! Immortel Archimede, artiste, ingenieur, Qui de ton jugement peut priser la valeur ? Pour moi ton probleme eut de pareils avantages.
Jadis, mysterieux, un probleme bloquait Tout l'admirable procede, l'oeuvre grandiose Que Pythagore decouvrit aux anciens Grecs. O quadrature ! Vieux tourment du philosophe
Insoluble rondeur, trop longtemps vous avez Defie Pythagore et ses imitateurs. Comment integrer l'espace plan circulaire ? Former un triangle auquel il equivaudra ?
Nouvelle invention : Archimede inscrira Dedans un hexagone ; appreciera son aire Fonction du rayon. Pas trop ne s'y tiendra : Dedoublera chaque element anterieur ;
Toujours de l'orbe calculee approchera ; Definira limite ; enfin, l'arc, le limiteur De cet inquietant cercle, ennemi trop rebelle Professeur, enseignez son probleme avec zele
Ce poème est un moyen mnémotechnique permettant de réciter les chiffres du nombre (), il suffit pour cela de compter le nombre de lettres de chacun des mots (10 équivalant au chiffre 0).
Puis créer un programme poeme.exe qui lira ce fichier et l'affichera dans la console.
Solution
with ada.Text_IO, ada.Strings.Unbounded ;
use ada.Text_IO, ada.Strings.Unbounded ;
procedure poeme is
F : File_Type ;
txt : unbounded_string ;
begin
open(F,in_file,"poeme.txt") ;
while not end_of_file(F) loop
txt :=to_unbounded_string(get_line(F)) ;
put_line(to_string(txt)) ;
end loop ;
close(F) ;
end poeme ;
Exercice 2
Enoncé
Plus compliqué, reprendre le problème précédent et modifier le code source de sorte que le programme affiche également les chiffres du nombre . Attention ! La ponctuation ne doit pas être comptée et je rappelle que la seule façon d'obtenir 0 est d'avoir un nombre à 10 chiffres !
Solution
WITH Ada.Text_IO, Ada.Integer_Text_IO, Ada.Strings.Unbounded ;
USE Ada.Text_IO, Ada.Integer_Text_IO, Ada.Strings.Unbounded ;
PROCEDURE Poeme IS
F : File_Type;
Txt : Unbounded_String;
PROCEDURE Comptage (Txt : String) IS
N : Natural := 0;
BEGIN
FOR I IN Txt'RANGE LOOP
CASE Txt(I) IS
WHEN ' ' => IF N/=0 THEN Put(N mod 10,3) ; N:= 0 ; END IF ;
WHEN '.' | '?' | ',' | ';' | '!' | ':' | ''' => IF N/=0 THEN Put(N mod 10,3) ; N:= 0 ; END IF ;
WHEN others => n := n+1 ;
END CASE ;
END LOOP ;
END Comptage ;
BEGIN
Open(F,In_File,"poeme.txt") ;
WHILE NOT End_Of_File(F) LOOP
Txt :=To_Unbounded_String(Get_Line(F)) ;
Put_Line(To_String(Txt)) ;
Comptage(To_String(Txt)) ;
New_line ;
END LOOP ;
Close(F) ;
END Poeme ;
Exercice 3
Enoncé
Nous allons créer un fichier "Highest_Score.txt" dans lequel seront enregistrés les informations concernant le meilleur score obtenu à un jeu (ce code pourra être mis en package pour être réutilisé plus tard). Seront demandés : le nom du gagnant, le score obtenu, le jour, le mois et l'année d'obtention de ce résultat.
Voici ci-dessous un exemple de la présentation de ce fichier texte. Pas d'espaces, les intitulés sont en majuscule suivis d'un signe =. Il y aura 4 valeurs entières à enregistrer et un string.
Le programme donnera le choix entre lire le meilleur score et en enregistrer un nouveau. Vous aurez besoin pour cela du package Ada.Calendar et de quelques fonctions :
clock : renvoie la date du moment. Résultat de type Time.
year(clock) : extrait l'année de la date du moment. Résultat : integer.
month(clock) : extrait le mois de la date du moment. Résultat : integer.
day(clock) : extrait le jour de la date du moment. Résultat : integer.
Solution
with Ada.Text_IO, Ada.Integer_Text_IO, Ada.Calendar, Ada.Characters.Handling, Ada.Strings.Unbounded ;
use Ada.Text_IO, Ada.Integer_Text_IO, Ada.Calendar, Ada.Characters.Handling, Ada.Strings.Unbounded ;
procedure BestScore is
--------------------
--Lecture du score--
--------------------
procedure read_score(F : file_type) is
txt : unbounded_string ;
long : natural ;
Score, Jour, Mois, Annee : natural ;
Nom : unbounded_string ;
begin
while not end_of_file(F) loop
txt:=To_Unbounded_String(get_line(F)) ;
long := length(txt) ;
if long>=6
then if To_String(txt)(1..6)="SCORE="
then Score := natural'value(To_String(txt)(7..long)) ;
end if ;
if To_String(txt)(1..6)="MONTH="
then Mois := natural'value(To_String(txt)(7..long)) ;
end if ;
end if ;
if long >= 5
then if To_String(txt)(1..5)="YEAR="
then Annee := natural'value(To_String(txt)(6..long)) ;
end if ;
if To_String(txt)(1..5)="NAME="
then Nom := to_unbounded_string(To_string(txt)(6..long)) ;
end if ;
end if ;
if long >= 4 and then To_String(txt)(1..4)="DAY="
then Jour := natural'value(To_String(txt)(5..long)) ;
end if ;
end loop ;
Put_line(" " & to_string(Nom)) ;
Put("a obtenu le score de ") ; Put(Score) ; New_line ;
Put("le " & integer'image(jour) & "/" & integer'image(mois) & "/" & integer'image(annee) & ".") ;
end read_score ;
---------------------
--Ecriture du score--
---------------------
procedure Write_Score(F : file_type) is
txt : unbounded_string ;
score : integer ;
begin
Put("Quel est votre nom ? ") ; txt := to_unbounded_string(get_line) ;
Put_line(F,"NAME=" & to_string(txt)) ;
Put("Quel est votre score ? ") ; get(score) ; skip_line ;
Put_line(F,"SCORE=" & integer'image(score)) ;
Put_line(F,"YEAR=" & integer'image(year(clock))) ;
Put_line(F,"MONTH=" & integer'image(month(clock))) ;
Put_line(F,"DAY=" & integer'image(day(clock))) ;
end Write_Score ;
------------------------------
-- PROCEDURE PRINCIPALE --
------------------------------
c : character ;
NomFichier : constant string := "Highest_Score.txt" ;
F : file_type ;
begin
loop
Put_line("Que voulez-vous faire ? Lire (L) le meilleur score obtenu,");
Put("ou en enregistrer un nouveau (N) ? ") ;
get_immediate(c) ; new_line ; new_line ;
c := to_upper(c) ;
exit when c = 'L' or c = 'N' ;
end loop ;
if c = 'L'
then open(F,In_File,NomFichier) ;
read_score(F) ;
close(F) ;
else create(F,Out_File,NomFichier) ;
write_score(F) ;
close(F) ;
open(F,In_File,NomFichier) ;
read_score(F) ;
close(F) ;
end if ;
end BestScore ;
Ce chapitre sur les fichiers est un peu long mais au final vous n'aurez pas appris tant de nouveautés que cela.Toutefois, vous voilà désormais armés pour créer des programmes plus complets. Vous pouvez dors et déjà réinvestir ce que vous avez vu et conçu dans ces derniers chapitres pour améliorer votre jeu de craps (vous vous souvenez, le TP) en permettant au joueur de sauvegarder son (ses) score(s), par exemple.
Nous allons, maintenant mettre de côté les tableaux (vous les retrouverez vite, rassurez vous :-° ) pour créer nos propres objets. ;)
Marre de parler d'objets sans en voir vraiment l'utilité ? Peu ou pas convaincu par la révolution des tableaux et des strings ? Alors ce chapitre est fait pour vous ! Nous allons cette fois créer nos propres objets. Oui oui, vous avez bien lu. ;)
Nous allons ici apprendre à créer des types d'objets, à les modifier, à les faire évoluer et même à créer "sous-types" de nos propres types d'objet !
Cette partie n'est pas la plus folichonne : nous allons réutiliser des types préexistants pour en créer des nouveaux. Malgré tout, elle vous sera souvent très utile et elle n'est pas très compliquée à comprendre.
Sous-type comme intervalle
Schématiquement, Integer couvre les nombres entiers (0, 1, 2, 3, ... -1, -2, -3, ...) et natural les nombres entiers naturels (0, 1, 2, 3, ...). Nous souhaiterions créer un type T_positif et un type T_negatif qui ne comportent pas le nombre 0. Pour cela, nous allons créer un sous-type (subtype) de natural ou de integer qui couvrira l'intervalle (range) allant de 1 à l'infini (symbole : ) pour les positifs et de "l'infini négatif" (symbole : ) à -1 pour les négatifs.
Nous allons donc, dans la partie déclarative, écrire soit :
subtype T_positif is integer range 1..integer'last ;
subtype T_negatif is integer range integer'first..-1 ;
Soit :
subtype T_positif is natural range 1..natural'last ;
Il sera alors impossible d'écrire ceci :
n : T_positif := 0 ;
m : T_negatif := 1 ;
Comme T_positif et T_negatifdérivent des types integer ou natural (lui-même dérivant du type integer), toutes les opérations valables avec les integer/natural, comme l'addition ou la multiplication, sont bien sûr valables avec les types T_positif et T_negatif, tant que vous ne sortez pas des intervalles définis.
Types modulaires
Deuxième exemple, nous souhaiterions créer un type T_chiffre allant de 0 à 9. Nous écrirons alors :
subtype T_chiffre is integer range 0..9 ;
Seulement, les opérations suivantes engendreront une erreur :
...
c : T_chiffre ;
BEGIN
c:= 9 ; --Jusque là, tout va bien
c:= c+2 ; --c devrait valoir 11. Ouille ! Pas possible !
...
Il serait donc plus pratique si après 9, les comptes recommençaient à 0 ! Dans ce cas 9+1 donnerait 0, 9+2 donnerait 1, 9+3 donnerait 2 ... C'est à cela que servent les sous-types modulaires que l'on définira ainsi :
type T_chiffre is mod 10;
Le type T_chiffre comportera 10 nombres : 0, 1, 2, 3, 4, 5, 6, 7, 8, 9 ! Pour ceux qui ont de bonnes connaissances en mathématiques, c= 9 équivaudra à écrire , c'est à dire que "c est congru à 9 modulo 10".
Autre exemple, nous allons créer des types T_Heure, T_Minute, T_Seconde, T_Milliseconde pour indiquer le temps. Remarquez que depuis le début, j'introduis mes types par la lettre T, ce qui permet de distinguer rapidement si un mot correspond à un type ou à une variable.
type T_Heure is mod 24 ;
type T_Minute is mod 60 ;
type T_Seconde is mod 60 ;
type T_Milliseconde is mod 1_000 -- on peut aussi écrire 1000, mais le symbole _ (touche 8)
-- permet de séparer les chiffres pour y voir plus clair
Continuons avec notre exemple du temps. Les types T_Heure, T_Minute, T_Seconde et T_Milliseconde ont été créés comme des types modulaires. Créer un type T_Annee ne devrait pas vous poser de soucis. Très bien. Mais pour les jours ou les mois, il serait bon de distinguer trois types distincts :
T_Numero_Jour : type allant de 1 à 31 (non modulaire car commençant à 1 et non 0)
T_Nom_Jour : type égal à LUNDI, MARDI, MERCREDI ...
T_Mois : type égal à JANVIER, FEVRIER, MARS ...
Nous savons déclarer les premiers types :
subtype T_Numero_Jour is integer range 1..31 ;
Pour les suivants, il faut créer ce que l'on appelle un type énuméré (un type où il faut énumérer toutes les valeurs disponibles), de la manière suivante :
type T_Mois is (JANVIER,FEVRIER,MARS,AVRIL,MAI,JUIN,
JUILLET,AOUT,SEPTEMBRE,OCTOBRE,NOVEMBRE,DECEMBRE) ;
type T_Nom_Jour is (LUNDI,MARDI,MERCREDI,JEUDI,VENDREDI,SAMEDI,DIMANCHE) ;
Pourquoi ne pas se contenter d'un nombre pour représenter le jour ou le mois ?
Eh bien par souci de clarté et de mémorisation. Est-il plus simple d'écrire : "jour = 4" ou "jour = JEUDI" ? "mois := 5" ou "mois := MAI" ? La deuxième façon est bien plus lisible. Et souvenez-vous des fichiers et de leur mode d'ouverture : ne vaut-il pas mieux écrire "In_File", "Out_File" ou "Append_File" que 0, 1 ou 2 ? Ne vaut-il mieux pas écrire true ou false que 1 ou 0 ? De plus, il est possible d'utiliser les attributs avec les types énumérés :
T_Mois'first renverra JANVIER (le premier mois)
T_Nom_Jour'last renverra DIMANCHE (le dernier jour)
T_Mois'succ(JUIN) renverra JUILLET (le mois suivant JUIN)
T_Mois'pred(JUIN) renverra MAI (le mois précédant JUIN)
T_Mois'pos(JUIN) renverra 5 (le numéro du mois de JUIN dans la liste)
T_Mois'val(1) renverra FEVRIER (le mois n°1 dans la liste, voir après)
put(T_Nom_Jour'image(MARDI)) permettra d'écire MARDI à l'écran
Par conséquent, il est même possible de comparer des variables de type énuméré : MARDI>JEUDI renverra false ! Enfin, les affectations se font de la manière la plus simple qu'il soit :
Nous disposons maintenant des types T_Heure, T_Minute, T_Seconde, T_Milliseconde, T_Annee (je vous ai laissé libres de le faire), T_Mois, T_Nom_Jour et T_Numero_Jour, ouf ! C'est un peu long tout ça non ? :waw: Il serait plus pratique de tout mettre dans un seul type de données (T_Temps ou T_Date par exemple) de manière à éviter de déclarer tout un escadron de variables pour enregistrer une simple date.
C'est ce que nous permettent les types structurés ou types articles (d'ailleurs en C, le mot clé est struct, pour une fois les termes du C me semblent plus clairs :D ). Nous allons donc créer notre type structuré en écrivant "type T_Temps is" comme d'habitude puis nous allons ouvrir un bloc record. L'exemple par l'image :
type T_Temps is
record
...
end record ;
Rappelons que "to record" signifie "Enregistrer". C'est donc entre les instructions record et end record que nous allons enregistrer le contenu du type T_Temps, c'est à dire l'heure, les minutes, les secondes et les millisecondes :
type T_Temps is
record
H : T_Heure ;
Min : T_Minute ;
S : T_Seconde ;
Milli : T_Milliseconde ;
end record ;
Ainsi, c'est comme si l'on déclarait quatre variables de types différents sauf que ce que l'on déclare, ce sont les quatre composantes de notre type. Par la suite, nous n'aurons plus qu'une seule variable de type T_Temps à déclarer et à modifier. Il est même possible d'attribuer des valeurs par défaut à nos différentes composantes. Ainsi, contrairement aux autres types de variables ou d'objets prédéfinis, il sera possible d'initialiser un objet de type T_Temps simplement en le déclarant.
type T_Temps is
record
H : T_Heure := 0 ;
Min : T_Minute := 0 ;
S : T_Seconde := 0 ;
Milli : T_Milliseconde := 0 ;
end record ;
t : T_Temps ; --Sans rien faire, t vaut automatiquement 0 H 0 Min 0 S 0 mS !
La pratique
Quelques petits exercices d'application bêtes et méchant :
créer un type T_Jour contenant le nom et le numéro du jour
créer le type T_Date contenant le jour, le mois et l'année
La réponse
type T_Jour is
record
nom : T_Nom_Jour := LUNDI;
num : T_Numero_Jour := 1 ;
end record ;
type T_Date is
record
jour : T_Jour ;
mois : T_Mois ;
annee : T_Annee ;
end record ;
Ordre des déclarations
En effet, le type T_Jour a besoin pour être déclaré que les types T_Numero_Jour et T_Nom_Jour soient déjà déclarés, sinon, lors de la compilation, le compilateur va tenter de construire notre type T_Jour et découvrir que pour cela il a besoin de deux types inconnus ! Car le compilateur va lire votre code du haut vers le bas et il lève les erreurs au fur et à mesure qu'elles apparaissent.
Pour pallier à ce problème, soit vous respectez l'ordre logique des déclarations, soit vous ne voulez pas (c'est bête) ou vous ne pouvez pas (ça arrive) respecter cet ordre et auquel cas, je vous conseille d'écrire les prototypes des types nécessaires auparavant :
type T_Nom_Jour ; --Liste des prototypes évitant les soucis à la compilation
type T_Numero_Jour ;
type T_Jour ;
type T_Date is --début des déclarations des sources (le tout en vrac)
record
...
end record ;
type T_Jour is
record
...
end record ;
type T_Nom_Jour is
record
...
end record ;
type T_Numero_Jour is
record
...
end record ;
Déclarer et modifier un objet de type structuré
Déclaration d'un objet de type structuré
Le langage Ada considère automatiquement les types que vous construisez comme les siens. Et donc la déclaration se fait le plus simplement du monde, comme pour n'importe quelle variable :
t : T_Temps ;
prise_bastille : T_Date ;
Affectation d'un objet de type structuré
Comment attribuer une valeur à notre objet t de type T_Temps ? Il y a plusieurs façons. Tout d'abord avec les agrégats, comme pour les tableaux (à la différence que les valeurs ne sont pas toutes du même type) :
t := (11,55,48,763) ; --pensez à respecter l'ordre dans lequel les composantes
--ont été déclarées lors du record : H,Min,S,Milli
-- OU BIEN
t := (7, Min => 56, Milli => 604 , S => 37) ; --Plus de soucis d'orde
Cette méthode est rapide, efficace mais pas très lisible ? Si on ne connaît pas bien le type T_Temps, on risque de se tromper dans l'ordre des composantes. Et puis, si on veut seulement faire une affectation sur les minutes ? Voici donc une seconde façon, sans agrégats :
t.H := 11 ;
t.S := 48 ;
t.Min := 55 ;
t.Milli := 763 ;
...
t.Min := t.Min + 15 ; --Possible car t.Min est la composante de type T_Minute qui est un type modulaire
--En revanche, les t.H n'est pas incrémenté pour autant !
Un nouvel exercice et sa correction
A vous d'affecter une valeur à notre objet prise_bastille ! Pour rappel, la Bastille est tombée le 14 juillet 1789 (et c'était un mardi).
Il faudra, pour la deuxième méthode, utiliser deux fois les points pour accéder à la composante de composante.
22 ! Rev'là les tableaux !
Compliquons notre tâche en mélangeant tableaux et dates !
Tableau dans un type
Tout d'abord, il pourrait être utile que certaines dates aient un nom ("Marignan ", "La Bastille ", "Gergovie "...) enregistré dans un string de 15 cases (par exemple). Reprenons notre type T_Date :
type T_Date is
record
nom : string(1..15) := "Pas d'An 0 !!! ";
jour : T_Jour := (LUNDI,1) ;
mois : T_Mois := JANVIER;
annee : T_Annee := 0 ;
end record ;
Il contient désormais un tableau (le string). Les opérations suivantes sont alors possibles :
...
prise_bastille : T_Date ;
BEGIN
prise_bastille.nom := "La Mastique " ;
prise_bastille.nom(4) := 'B' ;
prise_bastille.nom(9..10) := "ll" ;
Type dans un tableau (Euh... Van Gogh ? :-° )
Plus compliqué, on veut créer un tableau avec des dates à retenir (10 dates par exemple). Une fois notre type T_Date déclaré, déclarons notre type T_Chronologie et une variable T :
type T_Chronologie is array(1..10) of T_Date ;
T : T_Chronologie ;
Cette fois c'est T qui est notre tableau et T(1), T(2) ... sont des dates. Allons-y pour quelques affectations :
Le polymorphisme est la propriété d'avoir plusieurs formes, plusieurs apparences. En informatique, c'est l'idée de permettre à un type donné, d'avoir plusieurs apparences distinctes. Nos types T_Date et T_Temps ne conviennent plus à cette partie, prenons un nouvel exemple : un type T_Bulletin qui contient les moyennes d'un élèves dans différentes matières. Selon que notre élève est en primaire, au collège ou au lycée, il n'aura pas les mêmes matières (nous n'entrerons pas dans le détail des filières et des options par classe, l'exemple doit rester compréhensible, quitte à être caricatural). Considérons les données suivantes :
Un élève de primaire a du Français, des Maths et du Sport.
Un élève de collège a du Français, des Maths, du Sport, une langue étrangère (LV1) et de la Biologie.
Un élève de lycée a du Français, des Maths, du Sport, une langue étrangère (LV1), de la Biologie, de la chimie et une deuxième langue étrangère (LV2).
Notre type T_Bulletin n'a pas besoin d'avoir une composante chimie si notre élève est en primaire ; il doit donc s'adapter à l'élève ou plutôt à sa classe ! Nous allons donc définir deux autres types : un type énumératif T_Classe et un type structuré T_Eleve.
type T_Classe is (PRIMAIRE, COLLEGE, LYCEE) ;
type T_Eleve is
record
nom : string(1..20) ; --20 caractères devraient suffire
prenom : string(1..20) ; --on complètera au besoin par des espaces
classe : T_Classe ; --Tout l'intérêt d'écrire un T devant le nom de notre type ! ! !
end record ;
Créer un type polymorphe T_Bulletin
Maintenant, nous allons pouvoir créer notre type T_Bulletin, mais comme nous l'avons dit, sa structure dépend de l'élève et surtout de sa classe. Il faut donc paramétré notre type T_Classe !
Paramétrer un type ? C'est possible ?
Bien sûr, souvenez vous des tableaux ! Le type array est générique, il peut marcher avec des integer, des float ... Pour notre type T_Bulletin, cela devrait donner ceci :
type T_Bulletin(classe : T_Classe) is
record
--PARTIE FIXE
francais, math, sport : float ; --ou float range 0.0..20.0 ;
--PARTIE VARIABLE : COLLEGE ET LYCEE
case classe is
when PRIMAIRE =>
null ;
when COLLEGE | LYCEE =>
lv1, bio : float ;
--PARTIE SPECIFIQUE AU LYCEE
case classe is
when LYCEE =>
chimie, lv2 : float ;
when others =>
null ;
end case ;
end case ;
end record ;
Ce paramétrage nous permet ainsi d'éviter d'avoir à définir plusieurs types T_Bulletin_Primaire, T_Bulletin_College, T_Bulletin_Lycee. Il suffit de fournir en paramètre la classe en question. Attention toutefois ! Le paramètre fournit doit être discret.
Parce qu'un paramètre peut-être bruyant ? o_O
Non, discret n'est pas ici le contraire de bruyant ! C'est une notion mathématique qui signifie que les valeurs sont toutes "isolées les unes des autres" ou, d'une autre façon, si je prends deux valeurs au hasard, il n'y a qu'un nombre fini de valeurs comprises entre les deux que j'ai prises. Exemple : les integer sont de type discret (entre 2 et 5, il n'y a que 3 et 4, soit 2 nombres) ; les nombres réels (et le type float) ne sont pas discrets (entre 2.0 et 5.0, il y a une infinité de nombres comme 3.0 ou 3.01 ou 3.001 ou 3.00000000002 ou 4.124578521 ...). De même, nos types énumérés sont discrets, mais les types structurés ne sont pas acceptés comme discrets !
Autre souci : c'était pas plus simple d'utiliser if/elsif plutôt que des case imbriqués ?
Vous vous doutez bien que non ! Les conditions sont strictes lorsque l'on construit un type polymorphe. Pas de if, ne pas faire de répétition dans l'instruction when (ne pas répéter la composante lv1 par exemple), un seul case et c'est fini (d'où l'obligation de les imbriquer plutôt que d'en écrire deux distincts)... c'est qu'on ne ferait plus ce que l'on veut ! :p
Des objets polymorphes
Maintenant que nous avons déclarer nos types, il faut déclarer nos objets :
Il faut fournir un paramètre quand on définit Bltn_Kevin et Bltn_Laura, sans quoi le compilateur échouera et vous demandera de préciser votre pensée.
Par conséquent, lorsque vous déclarez les objets Kevin et Laura, vous devez les avoir initialisés (ou tout du moins avoir initialisé Kevin.classe et Laura.classe).
Nous avons ainsi obtenu deux objets Bltn_Kevin et Bltn_Laura qui n'ont pas la même structure. Bltn_Kevin a comme composantes :
Bltn_Kevin.classe : accessible seulement en lecture, pour des tests par exemple.
Bltn_Kevin.Math, Bltn_Kevin.Francais et Bltn_Kevin.sport : accessibles en lecture et en écriture.
Quant à lui, l'objet Bltn_Laura a davantage de composantes :
Bltn_Laura.classe : en lecture seulement
Bltn_Laura.Math, Bltn_Laura.francais, Bltn_Laura.sport : en lecture et écriture (comme Bltn_Kevin)
Bltn_Laura.lv1, Bltn_Laura.lv2, Bltn_Laura.bio, Bltn_Laura.chimie : en lecture et écriture.
Il est ensuite possible de créer des sous-types (pour éviter des erreurs par exemple) :
type T_Bulletin_Primaire is T_Bulletin(PRIMAIRE) ;
type T_Bulletin_College is T_Bulletin(COLLEGE) ;
type T_Bulletin_Lycee is T_Bulletin(LYCEE) ;
Les types structurés mutants
Comment peut-on muter ?
Je vous arrête tout de suite : il ne s'agit pas de monstres ou de types avec des pouvoirs spéciaux ! Non, un type mutant est simplement un type structuré qui peut muter, c'est-à-dire changer. Je vais pour cela reprendre mon type T_Bulletin. Attention ça va aller très vite :
type T_Bulletin(classe : T_Classe := PRIMAIRE) is
record
--PARTIE FIXE
francais, math, sport : float ; --ou float range 0.0..20.0 ;
--PARTIE VARIABLE : COLLEGE ET LYCEE
case classe is
when PRIMAIRE =>
null ;
when COLLEGE | LYCEE =>
lv1, bio : float ;
--PARTIE SPECIFIQUE AU LYCEE
case classe is
when LYCEE =>
chimie, lv2 : float ;
when others =>
null ;
end case ;
end case ;
end record ;
Euh ... t'aurais pas oublier de faire une modification après ton copier-coller ?
Non, regardez bien mon paramètre classe tout en haut : il a désormais une valeur par défaut : PRIMAIRE ! Vous allez me dire que ça ne change pas grand chose, et pourtant si ! Ainsi vous allez pouvoir écrire :
Eric : T_Eleve ; -- non prédéfini
Bltn_Eric : T_Bulletin ; -- pas la peine d'indiquer un paramètre, il est déjà prédéfini
Et désormais, Bltn_Eric est un type mutant, il va pouvoir changer de structure en cours d'algorithme ! Nous pourrons ainsi écrire :
...
Eric : T_Eleve ;
Bltn_Eric : T_Bulletin ;
BEGIN
Bltn_Eric := (COLLEGE,12.5,13.0,9.5,15.0,8.0) ;
Bltn_Eric := Bltn_Kevin ; --On suppose bien-sûr que Bltn_Kevin est déjà "prérempli"
...
Toujours plus loin !
Pour aller plus loin il serait judicieux de "fusionner" les types T_Eleve et T_Bulletin de la manière suivante :
type T_Bulletin(classe : T_Classe := PRIMAIRE) is --!!! POUR L'INSTANT, PAS DE CHANGEMENTS !!!
record
--PARTIE FIXE
francais, math, sport : float ; --ou float range 0.0..20.0 ;
--PARTIE VARIABLE : COLLEGE ET LYCEE
case classe is
when PRIMAIRE =>
null ;
when COLLEGE | LYCEE =>
lv1, bio : float ;
--PARTIE SPECIFIQUE AU LYCEE
case classe is
when LYCEE =>
chimie, lv2 : float ;
when others =>
null ;
end case ;
end case ;
end record ;
type T_Eleve is --!!! LA MODIFICATION SE FAIT ICI !!!
record
nom : string(1..20) ;
prenom : string(1..20) ;
bulletin : T_Bulletin ;
end record ;
Inutile de garder deux types : le type T_Bulletin sera intégré au type T_Eleve. En revanche il faudra que le type T_Eleve soit déclaré après le type T_Bulletin. Si cela se révélait impossible, vous pouvez toujours éviter ce problème en écrivant le prototype de T_Eleve, puis en décrivant T_Bulletin et enfin T_Eleve :
type T_Eleve ; -- !!! AJOUTE D'UN PROTOTYPE !!! Le reste ne change pas
type T_Bulletin(classe : T_Classe := PRIMAIRE) is
record
--PARTIE FIXE
francais, math, sport : float ; --ou float range 0.0..20.0 ;
--PARTIE VARIABLE : COLLEGE ET LYCEE
case classe is
when PRIMAIRE =>
null ;
when COLLEGE | LYCEE =>
lv1, bio : float ;
--PARTIE SPECIFIQUE AU LYCEE
case classe is
when LYCEE =>
chimie, lv2 : float ;
when others =>
null ;
end case ;
end case ;
end record ;
type T_Eleve is
record
nom : string(1..20) ;
prenom : string(1..20) ;
bulletin : T_Bulletin ;
end record ;
Plus besoin non plus de garder une composante classe dans le type T_Eleve puisqu'elle existe dans la composante bulletin !
Mais pourquoi ne pas avoir fait ça tout de suite ?
Pour plusieurs raisons : tout d'abord, avec un type polymorphe, la déclaration de la composante bulletin du type T_Eleve eût été inutilement compliquée et mon but n'est pas de vous embrouiller. Deuxième raison, j'ai changé mon fusil d'épaule en cours de rédaction du tutoriel :p : quel manque d'anticipation, c'est consternant. Sauf que cela me conduit à ma troisième raison : plutôt que de tout modifier, j'ai pensé qu'il était préférable de vous faire suivre un cheminement de pensée. Il est rare que l'on ait tout de suite la bonne idée, programmer exige une réflexion préalable sur les types qu'il faut définir, les fonctions ou procédures nécessaires etc ... or en cours de développement, des détails techniques peuvent parfois (et doivent) vous amener à revoir vos plans. Programmer, c'est anticiper, mais aussi s'adapter (aux contraintes techniques, aux choix du client ...)
Vous voilà désormais armés pour créer vos propres types (énumérés, sous-types, structurés [non paramétré, polymorphe ou mutant]). Combiné à l'usage des tableaux, voilà qui élargit vraiment nos horizons et nos possibilités. Combiné avec les packages, cela nous permet de créer l'équivalent des classes des langages C++, Java ...
Si nous développions notre type T_Eleve et les fonctionnalités qui s'y rapportent, nous pourrions créer un package volumineux et complet permettant d'établir une sorte de base de données des élèves d'un établissement : création et modification de "fichiers élèves" ou d'un seul grand fichier binaire enregistrant les différents objets de type T_Eleve possibles, enregistrement du numéro de téléphone, de l'adresse, des notes par matière (dans des tableaux inclus dans le type T_Eleve), création de fonctions calculant les moyennes, moyennes pondérées (avec coefficient), note minimale, note maximale ... la seule limite est votre imagination et votre temps libre :lol:
D'ailleurs, nous allons réaliser ce genre de programme dans le prochain chapitre : il s'agira de créer un logiciel gérant, non pas des élèves, mais votre collection de CD, DVD ... Comme vous l'avez deviné, notre prochain chapitre ne sera pas théorique, ce sera un TP ! Alors, si certains points vous posent encore problème, n'hésitez pas à les revoir.
Bienvenue dans le premier TP de la partie III, c'est-à-dire le second TP de ce cours. Comme je vous le disais dans le précédent chapitre, nous allons cette fois créer un logiciel pour gérer votre collection de CD, DVD, VHS, BluRay ... Plus précisément, notre programme permettra d'enregistrer un film, un album de musique, un jeu vidéo ou un autre type de donnée, mais aussi de consulter a posteriori la liste des œuvres. Je vous propose d'appeler notre programme Maktaba, ce qui signifie "Bibliothèque" en Swahili (pourquoi pas ? On a bien Ubuntu, Amarok ...).
Cela nous permettra de réutiliser les types de données structurés (pour enregistrer un film, il faut indiquer son titre, le type de support, son genre ...), les types énumérés (les supports CD, DVD, ...), les fichiers binaires ou texte (pour enregistrer notre liste d'œuvres ou exporter des informations sur une œuvre), les strings (pour enregistrer les titres des morceaux de musique par exemple) ou encore les packages (notre programme devrait être assez conséquent).
Cette fois encore, je commencerai ce TP par vous fournir un cahier des charges : que veut-on comme fonctionnalités ? comme données ? quelle structure pour nos fichiers et notre code source ? Puis je vous guiderai dans la conception du programme : nous ne réaliserons pas tout en seule fois, je commencerai par vous demander de réaliser un programme simple (simpliste ?) avant d'ajouter des fonctionnalités supplémentaires ou de prendre en charge des cas particuliers. Enfin, je vous transmettrai les sources et les prototypes d'une solution possible (bien entendu il n'y a pas qu'une seule solution mais bien plusieurs, chacune ayant ses avantages et inconvénients). En conclusion, comme pour le premier TP, je vous soumettrai quelques idées d'améliorations possibles de notre programme.
Prêt à démarrer ce nouveau challenge ? Alors au travail ! :soleil:
Pour établir les types dont nous pourrions avoir besoin, nous devons lister les données nécessaires à notre programme pour l'enregistrement ou la lecture.
Le contenu d'une œuvre
Nous souhaitons enregistrer des œuvres, mais qu'est-ce qu'une œuvre ? C'est avant tout :
un titre : "autant en emporte le vent", "mario bros 3", "Nevermind" ...
une catégorie : FILM, JEU (VIDEO), ALBUM (DE MUSIQUE), AUTRE ...
un support : CD, DVD, BLURAY, VHS, HDDVD ...
une note : de zéro à trois étoiles
Ensuite, selon la catégorie de l'œuvre, d'autres informations peuvent être nécessaires. Pour un film, nous aurons besoin :
du nom du réalisateur.
de savoir si le film est en VF
Pour un jeu vidéo nous aurons besoin :
de la console : Nes, PS1, PC, Nintendo64 ...
de savoir si vous avez terminé le jeu.
Pour un album de musique, nous aurons besoin :
du nom de l'artiste : "Nirvana", "ACDC", "Bob Marley" ...
D'une liste des morceaux dans l'ordre : "Come as you are", "Something in the way"
Il serait bon également qu'un type d'oeuvre par défaut existe : appréciation 0, ayant pour titre "" ...
Des types en cascade
Suite à cela, vous avez du comprendre que nous aurons besoin d'un type T_oeuvre qui soit structuré et polymorphe (voire même mutable, ce serait encore mieux et je vous le conseille fortement). Ce type structuré devrait comprendre de nombreuses composantes de types aussi divers que du texte (string mais pas d'unbounded_string, je vous expliquerai plus tard pourquoi), des tableaux, des booléens, des types énumérés (pour les supports ou la catégorie) ...
Rien que ça ? T'avais pas plus long ? :(
Tout cela laisse supposer que nous devrions créer un package spécifique pour déclarer notre type T_Oeuvre afin de libérer notre code source principal. Enfin, dernière information, nos textes devant être enregistrés dans des fichiers, nous ne pourrons pas utiliser les unbounded_string, mais seulement les string. L'explication technique vous sera révélée à la fin de la partie III, lors du chapitre sur les listes. Mais cela implique donc que vos strings devront être suffisamment longs pour pouvoir accueillir des titres à rallonge comme "Frances Farmer will have her revenge on Seattle" (titre de Nirvana, un peu long non ?).
Les types de fichiers
Qui dit enregistrement dit nécessairement fichiers. Aux vues de notre type structuré T_Oeuvre, cela signifie que nous aurions besoin d'un fichier binaire pour jouer le rôle de base de donnée (séquentiel ou à accès direct, c'est à vous de voir, pour ma part j'ai choisi les fichiers séquentiels dont la manipulation sera plus simple pour vous). Il serait même bon de séparer les bases de données (une pour les jeux, une pour la musique... ). Ces fichiers porteront par conséquent les noms de "ListeJeu.bdd", "ListeAlbum.bdd", "ListeFilm.bdd" et "ListeAutre.bdd" (bdd = Base De Données).
Quelle architecture pour les fichiers
Notre programme ayant besoin de divers types de fichiers, il serait judicieux de ne pas tout mélanger.
Maktaba.exe devra se trouver dans un répertoire Maktaba, libre à vous de placer un raccourci sur le bureau si vous le souhaitez.
Les bases de données ListeJeu.bdd et autres devront se trouver dans un sous-répertoire "data".
Un sous-répertoire "Manual" permettra l'enregistrement d'un fichier texte.
Cela nous fait donc un répertoire principal et deux sous-répertoires.
Quelles fonctionnalités pour quelles fonctions et procédures ?
Maktaba.exe devra proposer les fonctionnalités suivantes :
Saisie d'une nouvelle œuvre par l'utilisateur.
Enregistrement d'une nouvelle œuvre par l'utilisateur (ajout dans la base de donnée).
Modification par l'utilisateur d'une œuvre existante.
Suppression par l'utilisateur d'une œuvre existante.
Affichage de la base de donnée ou d'une oeuvre dans la console (sous la forme d'un tableau).
Accès aux fonctionnalités par lignes de commande : l'utilisateur devra taper add, modify, delete, print pour accéder à une fonctionnalité. Le programme gèrera bien-sûr d'éventuelles erreurs de frappe commises par l'utilisateur.
Possibilité d'accéder à un manuel en console par la commande manual. Ce manuel sera rédigé dans un fichier texte "manual.txt" placé dans le sous-répertoire "manual" évoqué précédemment et décrira les différentes commandes possibles.
Architecture du code source
Argh ! ! ! :waw: Mais jamais je ne parviendrai à faire tout ça ! Je savais bien que je n'aurais pas du me lancer dans cette galère ! :'(
Gardez espoir ! Ce ne sera pas aussi compliqué que cela peut paraître. En revanche, cela risque d'être long (notamment le codage des procédures de saisie et d'affichage), donc il sera nécessaire d'y aller étape par étape et d'adopter une approche par modules (tiens, ça devrait vous rappeler les packages ça). Nous aurons donc à créer les fichiers Ada suivants :
Maktaba.adb : la procédure principale qui ne se chargera que de l'interface utilisateur, du cœur du logiciel.
Maktaba_Types.ads : pour déclarer nos types et nos constantes.
Maktaba_Functions.adb et Maktaba_Functions.ads : pour les différentes fonctionnalités liées à la base de données (lecture, saisie, enregistrement, affichage).
Cette partie n'est pas obligatoire, elle permettra toutefois à ceux qui hésitent à se lancer ou qui ne voient pas comment faire, de trouver une méthode ou des voies pour programmer. Attention, il ne s'agit pas d'une solution toute faite (celle-ci sera fournie à la fin) mais plutôt d'un guide et je vous invite à essayer de réaliser ce TP par vous même, en recourant le moins possible à cette partie.
Création des types
Nous allons commencer par créer deux fichiers : Maktaba.adb et Maktaba_Types.ads. Notre fichier Maktaba.adb ne contiendra pour l'instant pas grand chose :
WITH Maktaba_Types ; USE Maktaba_Types ;
WITH Ada.Text_IO ; USE Ada.Text_IO ;
PROCEDURE Maktaba IS
Oeuvre : T_Oeuvre ;
BEGIN
END Maktaba ;
Comme vous pouvez le constater il n'y a quasiment rien. Nous allons nous concentrer sur le fichier Maktaba_Types.ads et les différents types : nous devons créer un type structuré et polymorphe (et même mutable) T_Oeuvre. Ce type devra contenir différentes composantes :
titre de l’œuvre, realisateur, console et artiste seront des strings (avec les contraintes que cela implique en terme de taille), mais surtout pas des unbounded_string (cela poserait problème pour l'enregistrement). Il serait bon que les strings soient initialisés.
Categorie et support seront des types énumérés.
VF et Termine seront des boolean (vrai ou faux).
Note sera un sous-type natural de 0 à 3 ou Integer (voire modulaire).
Morceaux sera un tableau de 30 strings (ou plus).
A vous donc de créer ce type T_Oeuvre ainsi que les types énumérés T_Categorie et T_Support et le sous-type T_Note. Pensez toutefois que, pour être polymorphe, T_Oeuvre doit dépendre de la catégorie de l'oeuvre et que pour être mutable, cette catégorie doit être initialisée :
type T_Oeuvre(categorie : T_Categorie := #Une_Valeur#)is
record
...
case categorie is
when FILM => ...
...
end case ;
end record ;
Affichage d'une œuvre
Il est temps de créer nos fichiers Maktaba_Functions.adb et Maktaba_Functions.ads ! Nous aurons besoin à l'avenir d'afficher l'intégralité de notre base de données, mais avant d'afficher 300 œuvres, nous devrions créer une fonction ou procédure qui en affiche une et une seule. Cela nous permettra d'avoir dors et déjà un programme Maktaba.exe opérationnel qui saisirait une œuvre (arbitrairement pour l'instant) puis l'afficherait.
procedure Affichage(oeuvre : T_Oeuvre) ;
Pensez à faire un affichage compact et clair : il y aura à terme des dizaines d'oeuvres ! Pensez également à terminer l'affichage par un ou plusieurs new_line pour éviter les soucis d'affichage plus tard.
Saisie d'une oeuvre
La première chose à faire par la suite sera de créer une procédure ou une fonction de saisie d'une œuvre. Le sous-programme de saisie ne sera pas compliqué à mettre en oeuvre mais sera long à rédiger car il devra prévoir toutes les composantes. Mais avant de vous lancer dans la saisie d'une œuvre, je vous conseille d'implémenter une fonction de saisie de string. Il existe bien get_line ou get, mais si vous souhaitez saisir un string de taille 20, il ne faut pas que l'utilisateur saisisse un texte de 35 ou 3 caractères. Or l'utilisateur final n'aura généralement aucune connaissance de ces contraintes, donc je conseille de commencer par là :
function get_text(taille : natural) return string ;
Autre indication pour simplifier votre code, il serait bon que votre fonction de saisie d’œuvre (appelons-la Saisie_Oeuvre) ne s’occupe pas de la saisie de la catégorie. Ce travail sera effectué par une fonction tierce (Saisie_Categorie) qui fournira à la première la catégorie à saisir. Cela simplifiera grandement votre travail et votre réflexion. De manière générale, une grande partie de vos fonctions et procédures devraient avoir la catégorie de l'œuvre en paramètre.
Function Saisie_Categorie return T_Categorie ;
Function Saisie_Oeuvre(Cat : T_Categorie) return T_Oeuvre ;
Les saisies de strings se feront avec notre fonction get_text. En revanche, les saisies d'entiers devront gérer les cas où l'utilisateur entrerait une note supérieure à 3 :
TANT QUE choix>3
| Saisir(choix)
FIN DE BOUCLE
De même, pour saisir un booléen ou un type structuré, vous pourrez proposer à l'utilisateur un choix similaire à celui-ci :
Votre film est enregistré sur :
1. un CD
2. un DVD
3. une VHS
Votre film est-il en VF ? (O : oui / N : Non) _
Donc prévoyez les cas où l'utilisateur répondrait de travers pour limiter les plantages.
Gestion des fichiers
La plupart des opérations suivantes se feront uniquement sur les fichiers : sauvegarde dans la base de données (bdd), affichage d'une bdd, modification d'un élément d'une bdd, suppression d'un élément d'une bdd ... Nous devrons créer un package pour manipuler des fichiers binaires. Comme dit précédemment, je vous invite à utiliser les fichiers séquentiels plutôt qu'à accès direct pour éviter de rajouter de la difficulté à la difficulté (bien sûr vous êtes libres de votre choix, le type de fichier binaire ne fait pas partie du cahier des charges).
Sauvegarde et affichage avec la BDD
L'implémentation de ces deux fonctionnalités ne devrait pas poser de problème. Il vous suffira d'ouvrir un fichier, de le fermer, en pensant entre temps à soit ajouter un élément (Append_File), soit parcourir le fichier pour le lire (In_file).
Mais si vous avez essayé d'implémenter ces fonctionnalités, vous avez du vous rendre compte qu'elles exigent toutes les deux de commencer par traiter une question toute bête : "Quel fichier dois-je ouvrir ? ". Et cette question, vous devrez vous la reposer à chaque fois. Donc il y a plusieurs façons de faire : soit on la joue gros bourrin et alors "Vive le copier-coller ! " :pirate: Soit on est un peu plus futé et on rédige une procédure qui se charge d'ouvrir le bon fichier selon la catégorie fournie en paramètre (paramètre pouvant être lui-même fourni par la fonction Saisie_categorie évoquée précédemment) :
Modification et suppression d'un élément de la BDD
Le plus simple pour effectuer cette opération est de ne manipuler que des fichiers : pas la peine de se casser la tête à tenter de supprimer un élément du fichier. Voici une méthode pour supprimer l'élément numéro N d'un fichier F :
Ouvrir le fichier F (Nom : truc)
Ouvrir le fichier G (Nom : truc2)
Copier les (N-1) premiers éléments de F dans G
sauter le N-ème élément de F
Copier le reste des éléments de F dans G
Supprimer F
Recreer F (Nom : Truc) comme une copie de G
Fermer F
Fermer G
Un raisonnement similaire peut être effectué pour la modification de la BDD.
Affichage du manuel
Là j'espère bien que vous n'avez pas besoin de moi ! :colere:
Les commandes
Jusque là, notre fichier Maktaba.adb ne contient rien de bien sérieux, il ne nous sert qu'à tester nos procédures et fonctions. Mais puisque nous avons fini, nous allons pouvoir le rédiger correctement. L'idée ici est simple : si l'utilisateur tape un mot particulier, le programme réalise une opération particulière. Nous allons donc réutiliser notre fonction get_text pour la saisie des commandes. Le corps de la procédure principale sera simple : une boucle infinie qui se contente de demander de saisir du texte et qui, si le texte correspond à une commande connue, lance quelques sous-programmes déjà rédigés. L'un de ces strings entraînera bien entendu la sortie de la boucle (commande : quit ou exit par exemple). En cas d'erreur de l'utilisateur, le programme affichera toutefois une phrase du genre "Si vous ne comprenez rien, vous n'avez qu'à taper Manual pour lire ce #*§%$€ de Manuel (RTFM)" (en plus aimable bien sûr :-° ) de façon à ne pas laisser l'utilisateur sans indications.
Comme promis, voici une solution possible à comparer avec votre travail.
Maktaba.adb :
------------------------------------------------------------------------------
-- --
-- PROJET MAKTABA --
-- --
-- MAKTABA.ADS --
-- --
-- --
-- AUTEUR : KAJI9 --
-- DATE : 13/11/2011 --
-- --
-- Contient la procédure principale du logiciel MAKTBA ainsi que les --
-- procédures d'affichage et de saisie. --
-- --
------------------------------------------------------------------------------
--Retrouvez le tuto à l'adresse suivante http://www.siteduzero.com/tutoriel-3-558031-1-second-tp-un-logiciel-de-gestion-de-bibliotheque.html
with Maktaba_Types ; use Maktaba_Types ;
with Maktaba_Functions ; use Maktaba_Functions ;
with Ada.Characters.Handling ; use Ada.Characters.Handling ;
with Ada.Text_IO ; use Ada.Text_IO ;
procedure Maktaba is
oeuvre : T_Oeuvre ;
reponse : string(1..6) ;
begin
loop
Put("> ") ; reponse := Get_Text(6) ;
reponse := To_Upper(Reponse) ;
if reponse = "QUIT " or reponse = "EXIT "
then exit ;
elsif reponse = "NEW "
then oeuvre := saisie(get_categorie) ;
sauvegarde(oeuvre) ;
elsif reponse = "MANUAL"
then Affichage_Manuel ;
elsif reponse = "INIT " or reponse = "ERASE "
then creation(get_categorie) ;
elsif reponse = "PRINT "
then affichage_bdd(get_categorie) ;
elsif reponse = "EDIT "
then Edit_bdd(get_categorie) ;
else put_line("Commande inconnue. Pour plus d'informations, tapez l'instruction MANUAL. ") ;
end if ;
end loop ;
end Maktaba ;
Maktaba_Types.ads :
------------------------------------------------------------------------------
-- --
-- PROJET MAKTABA --
-- --
-- MAKTABA_TYPES.ADS --
-- --
-- --
-- AUTEUR : KAJI9 --
-- DATE : 13/11/2011 --
-- --
-- Contient les différents types nécessaires au fonctionnement du logiciel --
-- MAKTABA. --
-- --
------------------------------------------------------------------------------
--Retrouvez le tuto à l'adresse suivante http://www.siteduzero.com/tutoriel-3-558031-1-second-tp-un-logiciel-de-gestion-de-bibliotheque.html
package Maktaba_Types is
type T_Categorie is (FILM,JEU,ALBUM,AUTRE) ;
type T_Support is (CD, DVD, BLURAY, VHS, HDDVD) ;
type T_Morceaux is array(1..30) of string(1..50) ;
type T_Oeuvre(categorie : T_Categorie := AUTRE) is
record
titre : string(1..50) := (others => ' ') ;
support : T_Support := CD ;
note : natural range 0..3 ;
case categorie is
when FILM => realisateur : string(1..20) := (others => ' ') ;
VF : boolean := false ;
when JEU => console : string(1..20) := (others => ' ') ;
termine : boolean := false ;
when ALBUM => artiste : string(1..20) := (others => ' ') ;
morceaux : T_Morceaux := (others =>(others => ' ')) ;
when AUTRE => null ;
end case ;
end record ;
type T_Film is new T_Oeuvre(FILM) ;
type T_Jeu is new T_Oeuvre(JEU) ;
type T_Album is new T_Oeuvre(ALBUM) ;
type T_Autre is new T_Oeuvre(AUTRE) ;
end ;
Maktaba_Functions.ads :
------------------------------------------------------------------------------
-- --
-- PROJET MAKTABA --
-- --
-- MAKTABA_FUNCTIONS.ADS --
-- --
-- --
-- AUTEUR : KAJI9 --
-- DATE : 13/11/2011 --
-- --
-- Contient les fonctions de saisie, d'affichage, de sauvegarde ... du --
-- logiciel MAKTABA. --
-- --
------------------------------------------------------------------------------
--Retrouvez le tuto à l'adresse suivante http://www.siteduzero.com/tutoriel-3-558031-1-second-tp-un-logiciel-de-gestion-de-bibliotheque.html
with Maktaba_Types ; use Maktaba_Types ;
WITH Ada.Sequential_IO ;
package Maktaba_Functions is
Package P_Fichier is new Ada.Sequential_IO(T_Oeuvre) ;
use P_Fichier ;
subtype T_Fichier is P_Fichier.File_type ;
procedure sauvegarde(Oeuvre : in T_Oeuvre) ;
procedure sauvegarde(oeuvre : in T_Oeuvre ; rang : natural) ;
procedure creation(cat : T_categorie) ;
procedure Ouvrir(F: in out T_Fichier ; mode : P_Fichier.File_Mode := P_Fichier.In_file ; cat : T_Categorie);
procedure supprimer(cat : T_Categorie ; rang : natural) ;
-- SAISIES
function get_text(size : integer) return string ;
function get_categorie return T_Categorie ;
function saisie(cat : T_Categorie) return T_Oeuvre ;
-- MANIPULATION DE LA BDD
procedure affichage_oeuvre(Oeuvre : in T_Oeuvre) ;
procedure affichage_bdd(cat : T_categorie) ;
procedure Edit_bdd(cat : T_Categorie) ;
-- Manuel
procedure affichage_manuel ;
end Maktaba_Functions ;
Maktaba_Functions.adb :
------------------------------------------------------------------------------
-- --
-- PROJET MAKTABA --
-- --
-- MAKTABA_FUNCTIONS.ADB --
-- --
-- --
-- AUTEUR : KAJI9 --
-- DATE : 13/11/2011 --
-- --
-- Contient les fonctions de saisie, d'affichage, de sauvegarde ... du --
-- logiciel MAKTABA. --
-- --
------------------------------------------------------------------------------
--Retrouvez le tuto à l'adresse suivante http://www.siteduzero.com/tutoriel-3-558031-1-second-tp-un-logiciel-de-gestion-de-bibliotheque.html
with Ada.Text_IO ; use Ada.Text_IO ;
with Ada.Integer_Text_IO ; use Ada.Integer_Text_IO ;
with Ada.Characters.Handling ; use Ada.Characters.Handling ;
with ada.Strings.Unbounded; Use ada.Strings.Unbounded ;
package body Maktaba_Functions is
-----------------------------------------------
-- GESTION DES FICHIERS --
-----------------------------------------------
procedure sauvegarde(Oeuvre : in T_Oeuvre) is
F : T_Fichier ;
begin
ouvrir(F,Append_File,oeuvre.categorie) ;
write(F,Oeuvre) ;
close(F) ;
end sauvegarde ;
procedure sauvegarde(oeuvre : in T_Oeuvre ; rang : natural) is
F,G : T_Fichier ;
tmp : T_Oeuvre ;
begin
-- Ouverture de F en In et de G en Append
ouvrir(F,In_File,oeuvre.categorie) ;
create(G,Append_File,Name(F) & "2") ;
-- copie de F+oeuvre dans G
for i in 1..rang-1 loop
read(F,tmp) ;
write(G,tmp) ;
end loop ;
write(G,oeuvre) ;
read(F,tmp) ; --lecture de l'élément à supprimer
while not end_of_file(F) loop
read(F,tmp) ;
write(G,tmp) ;
end loop ;
-- Suppression de F / recréation de F
-- fermeture de G / réouverture de G
delete(F) ;
creation(oeuvre.categorie) ;
ouvrir(F,Append_File,oeuvre.categorie) ;
close(G) ;
open(G,In_File,Name(F) & "2") ;
-- copie de G dans F
while not end_of_file(G) loop
read(G,tmp) ;
write(F,tmp) ;
end loop ;
--Fermeture de F / Suppression de G
close(F) ;
delete(G) ;
end sauvegarde ;
procedure Creation(cat : T_categorie) is
F : T_Fichier ;
begin
case cat is
when FILM => create(F,out_file,"./data/ListeFilm.bdd") ;
close(F) ;
when JEU => create(F,out_file,"./data/ListeJeu.bdd") ;
close(F) ;
when ALBUM => create(F,out_file,"./data/ListeAlbum.bdd") ;
close(F) ;
when AUTRE => create(F,out_file,"./data/ListeAutre.bdd") ;
close(F) ;
end case ;
end creation ;
procedure Ouvrir(F: in out T_Fichier ;
mode : P_Fichier.File_Mode := P_Fichier.In_file ;
cat : T_Categorie) is
begin
case cat is
when FILM => open(F,mode,"./data/ListeFilm.bdd") ;
when JEU => open(F,mode,"./data/ListeJeu.bdd") ;
when ALBUM => open(F,mode,"./data/ListeAlbum.bdd") ;
when AUTRE => open(F,mode,"./data/ListeAutre.bdd") ;
end case ;
end Ouvrir;
procedure supprimer(cat : T_Categorie ; rang : natural) is
F,G : T_Fichier ;
tmp : T_Oeuvre ;
begin
-- Ouverture de F en In et de G en Append
ouvrir(F,In_File,cat) ;
create(G,Append_File,Name(F) & "2") ;
-- copie de F-1 oeuvre dans G
for i in 1..rang-1 loop
read(F,tmp) ;
write(G,tmp) ;
end loop ;
read(F,tmp) ;
while not end_of_file(F) loop
read(F,tmp) ;
write(G,tmp) ;
end loop ;
-- Suppression de F / recréation de F
-- fermeture de G / réouverture de G
delete(F) ;
creation(cat) ;
ouvrir(F,Append_File,cat) ;
close(G) ;
open(G,In_File,Name(F) & "2") ;
-- copie de G dans F
while not end_of_file(G) loop
read(G,tmp) ;
write(F,tmp) ;
end loop ;
--Fermeture de F / Suppression de G
close(F) ;
delete(G) ;
end supprimer ;
----------------------------------
-- SAISIE --
----------------------------------
function get_text(size : integer) return string is
U : Unbounded_String := Null_Unbounded_String ;
T : string(1..size) := (others => ' ') ;
begin
U := to_unbounded_string(get_line) ;
if length(U) > size
then T := to_string(U)(1..size) ;
else T(1..length(U)) := to_string(U) ;
for i in length(U)+1..size loop
T(i) := ' ' ;
end loop ;
end if ;
return T ;
end get_text ;
function get_categorie return T_Categorie is
choix_cat : character ;
begin
Put_line("Choisissez la categorie desiree : ") ;
Put_line("F-Film M-Album de Musique") ;
Put_line("J-Jeu Video Autre ?") ;
Get_Immediate(choix_cat) ; choix_cat := to_upper(choix_cat) ;
case choix_cat is
when 'F' => return FILM ;
when 'M' => return ALBUM ;
when 'J' => return JEU;
when others => return AUTRE ;
end case ;
end get_categorie ;
function saisie(cat : T_Categorie) return T_Oeuvre is
oeuvre : T_Oeuvre(cat) ;
choix : character ;
note : integer ;
begin
-- SAISIE DES PARAMETRES COMMUNS
Put_line("Quel est le titre de l'oeuvre ? ") ;
oeuvre.titre := get_text(50) ;
Put_line("Quelle note donneriez-vous ? (Entre 0 et 3) ") ;
loop
get(note) ; skip_line ;
if note in 0..3
then oeuvre.note := note ;
exit ;
else Put_line("ERREUR ! La note doit être comprise entre 0 et 3 !") ;
end if ;
end loop ;
Put_line("Sur quel type de support l'oeuvre est-elle enregistree ?") ;
Put_line("1-VHS 2-CD 3-DVD") ;
Put_Line("4-HDDVD 5-BLURAY") ;
loop
get_immediate(choix) ; choix := to_upper(choix) ;
case choix is
when '1' => oeuvre.support := VHS ; exit ;
when '2' => oeuvre.support := CD ; exit ;
when '3' => oeuvre.support := DVD ; exit ;
when '4' => oeuvre.support := HDDVD ; exit ;
when '5' => oeuvre.support := BLURAY ; exit ;
when others => Put_line("Veuillez reconfirmer votre choix.") ;
end case ;
end loop ;
-- SAISIE DES PARAMETRES SPECIFIQUES
case cat is
when FILM => Put_line("Quel est le realisateur ? ") ;
oeuvre.realisateur:= get_text(20) ;
Put_line("Le film est-il en VF ? (O : Oui / N : Non)") ;
loop
get_immediate(choix) ; choix := to_upper(choix) ;
if choix = 'O'
then oeuvre.vf := true ; exit ;
elsif choix = 'N'
then oeuvre.vf := false ; exit ;
else Put_line("Veuillez appuyer sur O pour Oui ou sur N pour Non") ;
end if ;
end loop ;
return oeuvre ;
when ALBUM => Put_line("Quel est l'artiste ? ") ;
oeuvre.artiste := get_text(20) ;
for i in oeuvre.morceaux'range loop
Put_line("Voulez-vous ajouter un morceau ? (O : Oui / N : Non)") ;
get_immediate(choix) ; choix := to_upper(choix) ;
if choix = 'O'
then Put_line("Quel est le titre du morceau ? ") ;
oeuvre.morceaux(i) := get_text(50) ;
else exit ;
end if ;
end loop ;
return oeuvre ;
when JEU => Put_line("Quelle est la console ? ") ;
oeuvre.console := get_text(20) ;
Put_line("Avez-vous fini le jeu ? (O : Oui / N : Non)") ;
loop
get_immediate(choix) ; choix := to_upper(choix) ;
if choix = 'O'
then oeuvre.termine := true ; exit ;
elsif choix = 'N'
then oeuvre.termine := false ; exit ;
else Put_line("Veuillez appuyer sur O pour Oui ou sur N pour Non") ;
end if ;
end loop ;
return oeuvre ;
when AUTRE => return oeuvre ;
end case ;
end Saisie ;
-----------------------------------------------
-- AFFICHAGE D'UNE BDD --
-----------------------------------------------
procedure affichage_oeuvre(oeuvre : T_oeuvre) is --Affiche une seule oeuvre
null_string : constant string(1..50) := (others => ' ') ;
begin
put(" >>>Titre : ") ; put(Oeuvre.titre) ; new_line ;
put(" >>>Support : ") ; put(T_Support'image(Oeuvre.support)) ; new_line ;
put(" >>>Note : ") ; put(Oeuvre.note,1) ; new_line ;
case oeuvre.categorie is
when FILM => put(" >>>Realisateur : ") ; put(Oeuvre.realisateur) ; new_line ;
put(" >>>VF : ") ;
if Oeuvre.vf
then put("oui") ;
else put("non") ;
end if ; new_line(2) ;
when JEU => put(" >>>Console : ") ; put(Oeuvre.console) ; new_line ;
put(" >>>Termine : ") ;
if Oeuvre.termine
then put("oui") ;
else put("non") ;
end if ; new_line(2) ;
when ALBUM => put(" >>>Artiste : ") ; put(Oeuvre.artiste) ; new_line ;
put_line(" >>>Morceaux : ") ;
for i in Oeuvre.morceaux'range loop
exit when Oeuvre.morceaux(i) = null_string ;
put(" ") ; put(i,2) ; put(" : ") ; Put(oeuvre.morceaux(I)); New_Line;
end loop ;
new_line(2) ;
when AUTRE => new_line ;
end case ;
end affichage_oeuvre ;
procedure affichage_bdd(cat : T_categorie) is --Affiche toute une base de données selon la catégorie demandée
n : natural := 1 ;
suite : character ;
Oeuvre : T_Oeuvre(cat) ;
F : T_Fichier ;
begin
ouvrir(F,In_File,cat) ;
while not end_of_file(F) loop
if n = 0
then put("Cliquez pour continuer") ;
get_immediate(suite) ; new_line ;
end if ;
read(F,Oeuvre) ;
Affichage_oeuvre(oeuvre) ;
n := (n + 1) mod 5 ;
end loop ;
close(F) ;
end Affichage_bdd ;
------------------------------------------------------
-- EDITION DE LA BASE DE DONNEES --
------------------------------------------------------
procedure Edit_bdd(cat : T_Categorie) is --Edite une base de données pour modification ou suppression
choix : character ;
n : natural := 1 ;
Oeuvre : T_Oeuvre(cat) ;
F : T_Fichier ;
begin
ouvrir(F,In_File,cat) ;
while not end_of_file(F) loop
read(F,Oeuvre) ;
Affichage_oeuvre(oeuvre) ;
put_line("Que voulez-vous faire : Supprimer(S), Modifier(M), Quitter(Q) ou Continuer ?") ;
Get_Immediate(choix) ; choix := to_upper(choix) ;
if choix = 'M'
then close(F) ;
oeuvre := saisie(cat) ;
sauvegarde(oeuvre,n) ;
exit ;
elsif choix = 'S'
then close(F) ;
Supprimer(cat,n) ;
exit ;
elsif choix = 'Q'
then close(F) ;
exit ;
end if ;
n := n + 1 ;
end loop ;
if Is_Open(F)
then close(F) ;
end if ;
end Edit_bdd ;
------------------------------------------------------
-- EDITION DE LA BASE DE DONNEES --
------------------------------------------------------
procedure affichage_manuel is
F : Ada.text_IO.File_Type ;
begin
open(F,In_File,"./manual/manual.txt") ;
while not end_of_file(F) loop
put_line(get_line(F)) ;
end loop ;
close(F) ;
end affichage_manuel ;
end Maktaba_Functions ;
Manual.txt :
Commandes :
Quitter : Quit / Exit
Nouveau : New
Manuel : Manual
Réinitialiser une base : Init / Erase
Afficher une base : Print
Modifier une base : Edit
Chose promise, chose due ! Voici quelques idées d'amélioration de notre programme :
Fournir une interface graphique plutôt que cette vilaine console. Pour l'instant, vous ne pouvez pas encore le faire, mais cela viendra.
Proposer de gérer d'autres types de supports : disque durs, clés USB ...
Proposer l'enregistrement de nouvelles informations : le genre de l’œuvre (film d'horreur ou d'aventure, album rock ou rap...), une description, les acteurs du film, les membres du groupe de musique, l'éditeur du jeu vidéo, la durée des morceaux ...
Proposer l'exportation de vos bases de données sous formes de fichiers textes consultables plus aisément ou l'importation d'une œuvre à partir d'un fichier texte.
Permettre de compléter les instructions en ligne de commande par des options : modify -f modifierait un film par exemple.
Implémenter un service de recherche d’œuvre par titre, par auteur ou même par mots-clés !
Encore une fois, ce ne sont pas les idées qui manquent pour développer un tel logiciel. J'espère toutefois que ce TP vous aura permis de faire un point sur les notions abordées depuis le début de la partie III car nous allons maintenant nous atteler à un type de données plus complexe : les pointeurs. Et, de la même manière que nous avons parlé, reparlé et rereparlé des tableaux, nous allons parler, reparler et rereparler des pointeurs dans les prochains chapitres.
Voici très certainement LE chapitre de la troisième partie du cours. Pourquoi ? Eh bien parce que c'est, à n'en pas douter LE plus dur de tous. Les pointeurs constituent une véritable épine dans le pied de tout jeune programmeur. Non pas qu'ils soient compliqués à manipuler, non bien au contraire ! Vous connaissez déjà les opérations qui leur sont applicables. Non. Le souci, c'est qu'ils sont difficiles à conceptualiser, à comprendre.
Comment ça marche ? Je pointe sur quoi en ce moment ? A quoi ça sert ? C'est un pointeur ou un objet pointé ? Je mets un pointeur ou pas ? Au secours ! :colere: Voilà résumé en quelques questions tout le désarroi qui vous submergera sûrement en manipulant les pointeurs. C'est en tous cas celui qui m'a submergé lorsque j'ai commencé à les utiliser et ce, jusqu'à obtenir le déclic. Et, rassurez-vous, je compte bien prendre le temps de vous expliquer pour que vous aussi vous ayez le déclic à votre tour.
Ce chapitre étant long et compliqué il a donc été divisé en deux. La première moitié (celle que vous lisez actuellement) se chargera de vous expliquer les bases : qu'est-ce qu'un pointeur ? Comment cela marche-t-il ? A quoi cela ressemble-t-il en Ada ? La seconde moitié aura pour but de couvrir toutes les possibilités offertes par le langage Ada en la matière. Aussi compliqués soient-ils (et même si le langage Ada fait moins appel à eux que d'autres comme le C/C++), les pointeurs nous seront très utiles par la suite notamment pour le chapitre 10. N'hésitez pas à relire ce double chapitre, si besoin est, pour vous assurer que vous avez assimilé toutes les notions.
Notre premier objectif sera donc de comprendre ce qu'est un pointeur. Et pour cela, il faut avant tout se rappeler ce qu'est une variable !
On va pas tout reprendre à zéro quand même ? o_O
Et si ! Ou presque. Reprenons calmement et posons-nous la question suivante : que se passe-t-il lorsque l'on écrit dans la partie déclarative la ligne ci-dessous et quoi cela sert-il ?
MaVariablePerso : integer ;
En écrivant cela, nous indiquons à l'ordinateur que nous aurons besoin d'un espace en mémoire suffisamment grand pour accueillir un nombre de type integer, c'est à dire compris entre - 2 147 483 648 et + 2 147 483 647. Mon ordinateur va devoir réquisitionner une zone mémoire pour ma variable MaVariablePerso. Et pour la retrouver, cette zone mémoire disposera d'un adresse, par exemple le n°6025. Ainsi, à cette adresse, je suis sûr de trouver MaVariablePerso et rien d'autre ! Il ne peut y avoir qu'une seule variable par adresse.
Ainsi, si par la suite je venais à écrire :
MaVariablePerso := 5 ;
Alors l'emplacement mémoire n°6025 qui était encore vide (ou qui contenait d'anciennes données sans aucun rapport avec notre programme actuel) va recevoir la valeur 5 qu'il conservera jusqu'à la fin du programme.
En revanche, nous ne pourrons pas écrire :
MaVariablePerso := 5.37 ;
Car 5.37 est un float, et un float n'est pas codé de la même manière par l'ordinateur qu'un integer ou un character. Donc l'ordinateur sait qu'à l'adresse n°6025, il ne pourra enregistrer que des données de type integer sous peine de plantage. L'avantage des langages dits de haut niveau (tels Ada), c'est qu'ils s'occupent de gérer la réquisition de mémoire, d'éviter en amont de mauvaises affectations et surtout, ces langages nous permettent de ne pas avoir à nous tracasser de l'adresse mémoire utilisée (le n°6025). Il nous suffit d'indiquer le nom de cet emplacement (MaVariablePerso) pour pouvoir y accéder en écriture ou/et en lecture.
Or il est parfois utile de passer non plus par le nom de cet emplacement, mais par son adresse, et c'est là qu'interviennent les pointeurs ! Au lieu de dire "je veux modifier/lire la variable qui s'appelle MaVariablePerso" nous devrons dire "je veux modifier/lire ce qui est écrit à l'adresse n°6025".
Pour comprendre ce qu'est un pointeur, mettons-nous dans la peau de l'inspecteur Derrick (la classe ! :soleil: Non ?). Il sait que le meurtrier qu'il recherche vit à l'adresse 15 rue Mozart, bâtiment C, 5ème étage appartement 34. Mais il ne connaît pas son nom. Que fait-il ? Soit il imprime quelque part dans son cerveau l'adresse du criminel (vue l'adresse, ça sera pas facile, mais ... c'est Derrick ! :soleil: ) soit il utilise un bon vieux post-it pour la noter (moins glamour mais plus sérieux vu son âge). Bon ensuite, il se rend à l'adresse indiquée, fait ce qu'il a à faire (interrogatoire, arrestation ...) termine l'enquête et youpi, il peut jeter son post-it car il a résolu une nouvelle enquête.
Et c'est quoi le pointeur dans cette histoire ? o_O
Eh bien mon pointeur c'est : le post-it ! Ou le coin du cerveau de Derrick qui a enregistré cette adresse si compliquée ! Traduit en langage informatique, cela signifie qu'une adresse mémoire est trop compliquée pour être retenue ou utilisée par l'utilisateur, mieux vaut l'enregistrer quelque part, et le plus sérieux, c'est d'enregistrer cette adresse dans une bonne vieille variable tout ce qu'il y a de plus classique (ou presque). Et c'est cette variable, contenant une adresse mémoire intéressante qui est notre pointeur.
Sur mon schéma, le pointeur est donc la case n°1025 ! Cette case contient l'adresse (le n°3073) d'un autre emplacement mémoire. Un pointeur n'est donc rien de plus qu'une variable au contenu inutilisable en tant que tel puisque ce contenu n'est rien d'autre que l'adresse mémoire d'informations plus importantes. Le pointeur n'est donc pas tant intéressant par ce qu'il contient que par ce qu'il pointe.
Le terme Ada pour pointeur est access ! Malheureusement, comme pour les tableaux, il n'est pas possible d'écrire :
Toujours pour éviter des problèmes de typage, il nous faut définir auparavant un type T_Pointeur indiquant sur quel type de données nous souhaitons pointer. Pour changer, choisissons que le type T_Pointeur pointera sur ... des integer ! Oui je sais, c'est toujours des integer. :) Nous allons donc déclarer notre type de la manière suivante :
type T_Pointeur is access Integer ;
Puis nous pourrons déclarer des variable Ptr1, Ptr2 et Ptr3 de type T_pointeur :
Ptr1, Ptr2, Ptr3 : T_Pointeur ;
Que contient mon pointeur ?
En faisant cette déclaration, le langage Ada initialise automatiquement vos pointeurs (tous les langages ne le font pas, il est alors important de l'initialiser soi-même). Mais attention ! Ils ne pointent sur rien pour l'instant (il ne faudrait pas qu'ils pointent au hasard sur des données de type float, character ou autre). Ces pointeurs sont donc initialisés avec une valeur nulle : null. C'est comme si nous avions écrit :
Ptr1, Ptr2, Ptr3 : T_Pointeur := Null ;
Autrement dit, ils sont vides !
Bon alors maintenant, comment on leur donne une valeur utile ?
Ooh ! Malheureux ! Vous oubliez quelque chose ! La valeur du pointeur n'est pas utile en tant que telle car elle doit correspondre à un adresse mémoire qui, elle, nous intéresse ! Or le souci, c'est que cet emplacement mémoire n'est pas encore créé ! A quoi bon affecter une adresse à notre pointeur s'il n'y a rien à l'adresse indiquée ! La première chose à faire est de créer cet emplacement mémoire (et bien entendu, de le lier par la même occasion à notre pointeur). Pour cela nous écrirons :
Ptr1 := new integer ;
Ainsi, Ptr1 "pointera" sur une adresse qui elle, comportera un integer !
Où dois-je écrire cette ligne ? Dans la partie déclaration ?
Non ! Surtout pas ! Je sais que c'est normalement dans la partie déclarative que se font les réquisitions de mémoire, mais nous n'y déclarerons que le type T_Pointeur et nos trois pointeurs Ptr1, Ptr2 et Ptr3. La ligne de code précédente doit s'écrire après le begin, dans le corps de votre procédure ou fonction. C'est ce que l'on appelle l'allocation dynamique. Ce procédé permet, pour simplifier, de "créer et supprimer des variables n'importe quand durant le programme". Nous entrerons dans les détails durant l'avant-dernière sous-partie, rassurez-vous. Retenez simplement qu'à la déclaration, nos pointeurs ne pointent sur rien et que pour leur affecter une valeur, il faut créer un nouvel emplacement mémoire.
Une dernière chose, pas la peine d'écrire des Put(Ptr1) ou Get(Ptr1), car je vous ai un petit peu menti au début de ce chapitre, le contenu de Ptr1 n'est pas un simple integer (ce serait trop simple), l'adresse contenue dans notre pointeur est un peu plus compliquée et d'ailleurs, vous n'avez pas besoin de la connaître, la seule chose qui compte c'est qu'elle pointe bien sur une adresse valide.
Comment accéder aux données ?
Et mon pointeur, il pointe sur quoi ? :-°
Ben... pour l'instant sur pas grand chose à vrai dire puisque l'emplacement mémoire est vide. :( Bah oui, un pointeur ça pointe et puis c'est tout... ou presque ! L'emplacement mémoire pointé n'a pas de nom (ce n'est pas une variable) il n'est donc pas possible pour l'heure de le modifier ou de lire sa valeur. Alors comment faire ? Une première méthode serait de revoir l'affectation de notre pointeur ainsi :
Ptr1 := new integer'(124) ;
Ainsi, Ptr1 pointera sur un emplacement mémoire contenant 124. Le souci, c'est qu'on ne va pas réquisitionner un nouvel emplacement mémoire à chaque fois alors que l'on pourrait réutiliser celui existant ! Voici donc une autre façon :
Ptr2 := new integer ;
Ptr2.all := 421 ;
Eh oui, je vous avais bien dit que les pointeurs étaient un poil plus compliqué. Ils comportent une "sorte" de composante comme les types structurés ! Sauf que all a beau ressemblé à une composante, ce n'est pas une composante du pointeur, mais la valeur contenue dans l'emplacement mémoire pointé !
Il existe une troisième façon de procéder, si l'on souhaite avoir un pointeur sur une variable ou une constante déjà connue. Mais nous verrons cette méthode plus loin, à la fin de ce chapitre.
Opérations sur les pointeurs
Quelles opérations peut-on donc faire avec des pointeurs ? Eh bien je vous l'ai déjà dit : pas grand chose de plus que ce que vous savez déjà faire ! Voire même moins de choses. Je m'explique : vous pouvez tester l'égalité (ou la non égalité) de deux pointeurs, effectuer des affectations ... et c'est tout. Oh, certes vous pouvez effectuer toutes les opérations que vous souhaitez sur Ptr1.all puisque ce n'est pas un pointeur mais un integer ! Mais sur Ptr1, (et je ne me répète pas pour le plaisir) vous n'avez le droit qu'au test d'égalité (et non-égalité) et à l'affectation ! Vous pouvez ainsi écrire :
if Ptr1 = Ptr2
then ...
Ou :
if Ptr1 /= Ptr2
then ...
Mais surtout pas :
Ca n'aurait aucun sens ! En revanche vous pouvez écrire :
Ptr1 := Ptr2 ;
Cela signifiera que Ptr1 pointera sur le même emplacement mémoire que Ptr2 ! Cela signifie aussi que l'emplacement qu'il pointait auparavant est perdu : il reste en mémoire, sauf qu'on a perdu son adresse ! Cet emplacement sera automatiquement supprimé à la fin de notre programme.
Ptr2.all := 5 ; --Ptr2 pointe sur "5"
Ptr1 := Ptr2 ; --On modifie l'adresse contenue dans Ptr1 ! ! !
Ptr1.all := 9 ; --Ouais ! Ptr1 pointe sur "9" maintenant !
--Sauf que du coup, Ptr2 aussi puisqu'ils
--pointent sur le même emplacement ! ! !
Donc, évitez ce genre d'opération autant que possible. Préférez plutôt :
Ptr2.all := 5 ; --Ptr2 pointe sur "5"
Ptr1.all := Ptr2.all ; --Ptr1 pointe toujours sur la même adresse
--On a simplement modifié le contenu de cette adresse
Ptr1.all := 9 ; --Maintenant Ptr1 pointe sur "9" !
--Mais comme Ptr1 et Ptr2 pointent sur
--deux adresses distinctes, il n'y a pas de problème.
Une erreur à éviter
Eh bien parce que si ptr ne pointe sur rien (s'il vaut Null), lorsque vous effectuerez ce test, le programme testera également si Ptr.all est positif (supérieur à 0). Or si Ptr ne pointe sur rien du tout alors Ptr.all n'existe pas ! ! ! Nous devrons donc prendre la précaution suivante (comme nous l'avions vu avec les tableaux) :
Avant de commencer cette partie, je vais vous demander de copier et de compiler le code ci-dessous :
with ada.text_io ; use ada.Text_IO ;
procedure aaa is
type T_Pointeur is access Integer ;
P : T_Pointeur ;
c : character ;
begin
for i in 1..8 loop
for j in 1..10**i loop
P := new integer'(i*j) ;
end loop ;
get(c) ; skip_line;
end loop ;
end aaa ;
Comme vous pouvez le voir, ce code ne fait rien de bien compliqué : il crée un pointeur auquel il affecte 10 valeurs successives, puis 100 (), puis 1 000 (), puis 10 000 () ... et ainsi de suite. Mais l'intérêt de ce programme n'est pas là. Nous allons regarder sa consommation mémoire. Pour cela, ouvrez un gestionnaire de tâche :
si vous êtes sous Windows : appuyez sur les touches Alt+Ctrl+Suppr puis cliquez sur l'onglet Processus. Le programme apparaîtra en tête de liste.
si vous êtes sous Linux ou Mac : un gestionnaire (appelé Moniteur d'activité sous Mac) est généralement disponible dans votre liste de programmes, mais vous pouvez également ouvrir une console et taper la commande top.
Lancez votre programme aaa.exe et admirez la quantité de mémoire utilisée : environ 780 Ko au démarrage mais après chaque saisie du caractère C, la mémoire utilisée augmente de manière exponentielle (quadratique en fait :D ). Ci-dessous, une capture d'écran avec 200 Mo de mémoire utilisée par ce "petit" programme (mais on peut faire bien mieux).
Mais comment se fait-il qu'un si petit programme puisse utiliser autant de mémoire ?
C'est ce que nous allons expliquer maintenant avant de fournir une solution à ce problème qui ne nous est jamais arrivé avec nos bonnes vieilles variables.
Un problème de mémoire
Reprenons nos schémas précédents car ils étaient un peu trop simplistes. Lorsque vous lancez votre programme, l'ordinateur va réserver des emplacements mémoire. Pour le code du programme tout d'abord, puis pour les variables que vous aurez déclaré entre is et begin. Ainsi, avant même d'effectuer le moindre calcul ou affichage, votre programme va réquisitionner la mémoire dont il va avoir besoin : c'est à cela que sert cette fameuse partie déclarative et le typage des variables. On dit que les variables sont stockées en mémoire statique, car la taille de cette mémoire ne va pas varier.
A cela, il faut ajouter un autre type de mémoire : la mémoire automatique. Au démarrage, l'ordinateur ne peut connaître les choix que l'utilisateur effectuera. Certains choix ne nécessiteront pas d'avantage de mémoire, d'autres entraîneront l'exécution de sous-programmes disposant de leurs propres variables ! Le même procédé de réservation aura alors lieu dans ce que l'on appelle la pile d'exécution : à noter que cette pile a cette fois une taille variable dépendant du déroulement du programme et des choix de l'utilisateur.
Mais ce procédé a un défaut : il gaspille la mémoire ! Toute variable déclarée ne disparaît qu'à la fin de l'exécution du programme ou sous-programme qui l'a généré. Ni votre système d'exploitation ni votre compilateur ne peuvent deviner si une variable est devenue inutile. Elle continue donc d'exister malgré tout. A l'inverse, ce procédé ne permet pas de déclarer des tableaux de longueur indéterminée : il faut connaître la taille avant même l'exécution du code source ! Contraignant. :colere2:
C'est pourquoi existe un dernier type de mémoire appelé Pool ou Tas. Ce pool, comme la pile d'exécution, n'a pas de taille prédéfinie. Ainsi, lorsque vous déclarez un pointeur P dans votre programme principal, l'ordinateur réserve suffisamment d'emplacements en mémoire statique pour pouvoir enregistrer une adresse. Puis, lorsque votre programme lit :
P := new integer ; --suivie éventuellement d'une valeur
Celui-ci va automatiquement allouer, dans le Pool, suffisamment d'emplacements mémoires pour enregistrer un Integer. On parle alors d'allocation dynamique. Donc si nous répétons cette instruction (un peu comme nous l'avons fait dans le programme donné en début de sous-partie), l'ordinateur réservera plusieurs emplacements mémoire dans le Pool.
Résolution du problème
Unchecked_Deallocation
Il est donc important lorsque vous manipuler des pointeurs de penser aux opérations effectuées en mémoire par l'ordinateur. Allouer dynamiquement de la mémoire est certes intéressant mais peut conduire à de gros gaspillages si l'on ne réfléchit pas à la portée de notre pointeur : tant que notre pointeur existe en mémoire statique, les emplacements alloués en mémoire dynamique demeurent et s'accumulent.
La mémoire dynamique n'était pas sensée régler ce problème de gaspillage justement ?
Bien sûr que oui. Nous disposons d'une instruction d'allocation de mémoire (new), il nous faut donc utiliser une instruction de désallocation. Malheureusement celle-ci n'est pas aisée à mettre en œuvre et est risquée. Nous allons devoir faire appel à une procédure : Ada.Unchecked_Deallocation ! Mais attention, il s'agit d'une procédure générique (faite pour tout type de pointeur) qui est donc inutilisable en tant que telle. Il va falloir lui créer une sœur jumelle, que nous appellerons Free, prévue pour notre type T_Pointeur. Voici le code corrigé :
with ada.text_io ; use ada.Text_IO ;
with Ada.Unchecked_Deallocation ;
procedure aaa is
type T_Pointeur is access Integer ;
P : T_Pointeur ;
c : character ;
procedure free is new Ada.Unchecked_Deallocation(Integer,T_Pointeur) ;
begin
for i in 1..8 loop
for j in 1..10**i loop
P := new integer'(i*j) ;
free(P) ;
end loop ;
get(c) ; skip_line;
end loop ;
end aaa ;
Vous remarquerez tout d'abord qu'à la ligne 2, j'indique avec with que mon programme va utiliser la procédure Ada.Unchecked_Deallocation (pas de use, cela n'aurait aucun sens puisque ma procédure est générique). Puis, à la ligne 8, je crée une procédure Free à partir de Ada.Unchecked_Deallocation : on dit que l'on instancie (mais nous verrons tout cela plus en détail dans la partie IV). Pour cela, il faut préciser tout d'abord le type de donnée qui est pointé puis le type de Pointeur utilisé.
Enfin, à la ligne 13, j'utilise ma procédure Free pour libérer la mémoire du Pool. Mon pointeur P ne pointe alors plus sur rien du tout et il est réinitialisé à Null. Vous pouvez compiler ce code et le tester : notre problème de "fuite de mémoire" a disparu !
Risques inhérents à la désallocation
Il est toutefois risqué d'utiliser Ada.Unchecked_Deallocation et la plupart du temps, je ne l'utiliserai pas. Imaginez que vous ayez deux pointeurs P1 et P2 pointant sur un même espace mémoire :
Le compilateur considèrera ce code comme correct mais que se passera-t-il ? Lorsque P1 est désalloué à la ligne 4, il est remis à Null mais cela signifie aussi que l'emplacement vers lequel il pointait disparaît. Et P2 ? Il pointe donc désormais vers un emplacement mémoire qui a disparu et il ne vaut pas Null ! Voilà donc pourquoi on évitera la désallocation lorsque cela est possible.
Une autre méthode
Je veux bien, mais tu nous exposes un problème, tu nous donne la solution et ensuite tu nous dis de ne surtout pas l'employer ! Je fais moi ? o_O
Une autre solution consiste à réfléchir (oui, je sais c'est dur :p ) à la portée de notre type T_pointeur. En effet, lorsque le bloc dans lequel ce type est déclaré (la procédure ou la fonction le plus souvent) se termine, le type T_pointeur disparaît et le pool de mémoire qu'il avait engendré disparaît lui aussi. Ainsi, pour éviter tout problème avec Ada.Unchecked_Deallocation, il peut être judicieux d'utiliser un bloc de déclaration avec l'instruction declare.
with ada.text_io ; use ada.Text_IO ;
procedure aaa is
c : character ;
begin
for i in 1..8 loop
for j in 1..10**i loop
declare
type T_Ptr is access Integer ;
P : T_Ptr ;
begin
P := new integer'(i*j) ;
end ;
end loop ;
get(c) ; skip_line;
end loop ;
end aaa ;
Crée trois pointeurs Ptr1, Ptr2 et Ptr3 sur des integer
Demande à l'utilisateur de saisir les valeurs pointées par Ptr1 et Ptr2
Enregistre dans l'emplacement mémoire pointé par Ptr3, la somme des deux valeurs saisies précédemment.
Je sais, c'est bidon comme exercice et vous pourriez le faire les yeux fermés avec des variables. Sauf qu'ici, je vous demande de manipuler non plus des variables, mais des objets appelés pointeurs ! :p
Solution
WITH Ada.Text_IO ; USE Ada.Text_IO ;
WITH Ada.Integer_Text_IO ; USE Ada.Integer_Text_IO ;
WITH Ada.Unchecked_Deallocation ;
procedure Test_Pointeur is
type T_Pointeur is access Integer ;
procedure Free is new Ada.Unchecked_Deallocation(Integer, T_Pointeur) ;
Ptr1, Ptr2, Ptr3 : T_Pointeur ;
begin
Ptr1 := new Integer ;
Put("Quelle est la premiere valeur pointee ? ") ;
get(Ptr1.all) ; skip_line ;
Ptr2 := new Integer ;
Put("Quelle est la seconde valeur pointee ? ") ;
get(Ptr2.all) ; skip_line ;
Ptr3 := new Integer'(Ptr1.all + Ptr2.all) ;
Free(Ptr1) ; --on libère nos deux premiers pointeurs
Free(Ptr2) ;
Put("Leur somme est de ") ;
Put(Ptr3.all) ;
Free(Ptr3) ; --on libère le troisième, mais est-ce vraiment utile ? ^^
end Test_Pointeur ;
Exercice 2
Énoncé
Deuxième exercice, vous allez devoir créer un programme Inverse_pointeur qui saisit une première valeur pointée par Ptr1, puis une seconde pointée par Ptr2 et qui inversera les pointeurs. Ainsi, à la fin du programme, Ptr1 devra pointer sur la seconde valeur et Ptr2 sur la première. Attention, les valeurs devront être saisies une et une seule fois, elle seront ensuite fixée !
Une indication : vous aurez sûrement besoin d'un troisième pointeur pour effectuer cet échange.
Solution
WITH Ada.Text_IO ; USE Ada.Text_IO ;
WITH Ada.Integer_Text_IO ; USE Ada.Integer_Text_IO ;
WITH Ada.Unchecked_Deallocation ;
procedure Inverse_Pointeur is
type T_Pointeur is access Integer ;
procedure Free is new Ada.Unchecked_Deallocation(Integer,T_Pointeur) ;
Ptr1, Ptr2, Ptr3 : T_Pointeur ;
begin
Ptr1 := new Integer ;
Put("Quelle est la premiere valeur pointee ? ") ;
get(Ptr1.all) ; skip_line ;
Ptr2 := new Integer ;
Put("Quelle est la seconde valeur pointee ? ") ;
get(Ptr2.all) ; skip_line ;
Ptr3 := Ptr1 ;
Ptr1 := Ptr2 ;
Ptr2 := Ptr3 ; Free(Ptr3) ; --Attention à ne pas libérer Ptr1 ou Ptr2 !
Put("Le premier pointeur pointe sur : ") ;
Put(Ptr1.all) ; Free(Ptr1) ;
Put(" et le second sur : ") ;
Put(Ptr2.all) ; Free(Ptr2) ;
end Inverse_Pointeur ;
Vous êtes parvenus à la fin de la première moitié de ce double-chapitre. Comme je vous l'avais dit en introduction, si des doutes subsistent, n'hésitez pas à relire ce chapitre ou à poster vos questions avant que les difficultés ne s'accumulent. La seconde moitié du chapitre sera en effet plus complexe. Elle vous apprendra à créer des pointeurs sur des variables, des constantes, des programmes... ou à créer des fonctions ou procédures manipulant des pointeurs. Le programme est encore chargé ^^
Après un premier chapitre présentant la théorie sur les pointeurs (ou accesseurs) et l'allocation dynamique, nous allons dans cette seconde partie nous intéresser aux différentes possibilités offertes par le langage Ada : comment pointer sur une variable ou une constante déjà créée ? Comment créer des pointeurs constants ? Comment passer un pointeur en argument dans une fonction ou une procédure ? Comment créer puis manipuler des pointeurs sur des programmes ? C'est ce à quoi nous allons tenter de répondre dans ce chapitre avant d'effectuer quelques exercices d'application.
Pour l'instant, nous avons été obligés de pointer sur des valeurs définies par vos propres soins. Nous voudrions désormais pouvoir pointer sur une valeur générée par l'utilisateur ou par le programme, sans que le programmeur en ait eu préalablement connaissance. Une difficulté se pose : lorsque vous créez un "pointeur sur 7", vous demandez à l'ordinateur de créer dans une zone non utilisée de la mémoire un emplacement contenant la valeur 7. Or pour pointer sur une variable, il ne faudra rien créer ! La variable est créée dès le démarrage de votre programme dans une zone de la mémoire qui a été préalablement réquisitionnée et dont la taille ne varie pas (c'est à cela que servent les déclarations). Il faut donc revoir notre type T_Pointeur pour spécifier qu'il peut pointer sur tout !
Type T_Pointeur is access all integer ;
L'instruction all permet d'indiquer que l'on peut pointer sur un emplacement mémoire créé en cours de programme (on parle de mémoire dynamique, comme pour l'allocation dynamique), mais aussi sur un emplacement mémoire déjà existant (on parle de mémoire statique) comme une variable.
La déclaration des pointeurs se fera normalement, en revanche, les variables que vous autoriserez à être pointées devront être clairement spécifiées pour éviter d'éventuels problèmes grâce à l'instruction aliased.
Ptr : T_Pointeur ;
N : aliased integer ;
Et maintenant comment je récupère l'adresse de ma variable ?
C'est simple, grâce à un attribut : access !
...
begin
N := 374 ; --N prend une valeur, ici 374
Ptr := N'access ; --Ptr prend comme valeur l'adresse de N
Ainsi, Ptr.all correspondra à la variable N ! Retenez donc ces trois choses :
le type T_Pointeur doit être généralisé avec all ;
les variables doivent être spécifiées avec aliased ;
l'adresse (ou plus exactement, la référence) peut être récupérée avec l'attribut access.
Pointeur sur une constante et pointeur constant
Pointeur sur une constante
De la même manière, il est possible de créer des pointeurs pointant sur des constantes. Pour cela, notre type T_Pointeur doit être défini ainsi grâce à l'instruction constant :
type T_Pointeur is access constant Integer ;
Notre pointeur et notre constante seront donc déclarées ainsi :
Ptr est déclaré de la même manière que d'habitude. Quant à notre constante N, elle doit être spécifiée comme pouvant être pointée grâce à l'instruction aliased ; elle doit être indiquée comme constante avec l'instruction constant et elle doit être indiquée comme de type Integer (bien sûr) valant 35 (par exemple). Puis, nous pourrons affecter l'adresse mémoire de N à notre pointeur Ptr :
Ptr := N'access ;
Il est donc possible par la suite de modifier la valeur de notre pointeur, par exemple en écrivant :
Ptr := N'access ;
Ptr := M'access ; --M doit bien-sûr être défini comme aliased constant integer
En revanche il n'est pas possible de modifier la valeur pointée car c'est elle qui doit être constante. Vous ne pourrez donc pas écrire :
Pointeur constant
Il est toutefois possible de créer des pointeurs constants. Redéfinissons de nouveau notre type T_Pointeur et nos objets et variables :
type T_Pointeur is access all integer ;
N : integer ;
Ptr : constant T_Pointeur := N'access ;
Dans ce cas-ci, c'est le pointeur qui est contant : il pointera sur l'emplacement mémoire de la variable N et ne bougera plus. Maintenant, rien n'empêche N (et donc son emplacement mémoire) de prendre différentes valeurs (d'ailleurs, pour l'heure, Ptr pointe sur N mais N n'a aucune valeur). Exemple d'opérations possibles :
N := 5 ;
Ptr.all := 9 ;
Exemple d'opérations interdites dès lors que notre pointeur est constant :
N'oubliez pas : ici c'est le pointeur qui est constant et donc l'adresse ne doit pas changer (par contre ce qui se trouve à cette adresse peut changer, ou pas).
Pointeur sur pointeur
L'idée semble saugrenue et pourtant elle fera l'objet de notre avant dernier chapitre : créer un pointeur sur un pointeur sur un integer ! Nous devrons donc créer deux types de pointeurs distincts : un type "pointeur sur integer" et un type "pointeur sur pointeur sur integer" !
type T_Pointeur_Integer is access Integer ;
type T_Pointeur_Pointeur is access T_Pointeur_Integer ;
PtrI : T_Pointeur_Integer ; --PtrI pour Pointeur-Integer
PtrP : T_Pointeur_Pointeur ; --PtrP pour Pointeur-Pointeur
Cela devrait nous permettre de créer une sorte de liste de pointeurs qui se pointent les uns les autres (mais nous verrons cela plus en détail dans l'avant dernier chapitre) !
Attention, cela apporte quelques subtilités :
PtrI := new Integer ;
PtrI.all := 78 ;
PtrP := new T_Pointeur_Integer ;
PtrP.all := PtrI ;
PtrP est un pointeur sur un pointeur, donc PtrP.all est lui aussi un pointeur, mais un pointeur sur un entier cette fois ! Si je souhaite modifier cet entier, deux solutions s'offrent à moi : soit utiliser PtrI.all, soit utiliser PtrP de la manière suivante :
PtrP.all.all := 79 ;
Il serait même judicieux de reprendre notre code et de ne pas créer de pointeur PtrI. Tout devrait pouvoir être fait avec PtrP. Voyons cela en exemple :
...
type T_Pointeur_Integer is access Integer ;
type T_Pointeur_Pointeur is access T_Pointeur_Integer ;
PtrP : T_Pointeur_Pointeur ; --PtrP pour Pointeur-Pointeur
begin
PtrP := new T_Pointeur_Integer ;
PtrP.all := new Integer ;
PtrP.all.all := 78 ;
...
Avec une seule variable PtrP, nous pouvons manipuler 3 emplacements mémoire :
L'emplacement mémoire du pointeur sur pointeur PtrP
L'emplacement mémoire du pointeur sur integer PtrP.all
L'emplacement mémoire de l'integer PtrP.all.all qui vaut ici 78 !
Et avec un pointeur sur pointeur sur pointeur sur pointeur sur pointeur ... nous pourrions peut-être parvenir à créer, avec une seule variable, une liste d'informations liées les unes aux autres et de longueur infinie (ou tout du moins non contrainte, il suffirait d'utiliser l'instruction new à chaque fois que l'on souhaiterait allonger cette liste. Ces "listes" sont la principale application des pointeurs que nous verrons dans ce cours et fera l'objet d'un prochain chapitre ! Alors encore un peu de patience. ^^
Avant de passer aux exercices finaux, il nous reste un dernier point à traiter : comment transmettre un pointeur comme paramètre à une fonction ou une procédure ? Supposons que nous ayons deux procédures Lire() et Ecrire() et une fonction Calcul()nécessitant un pointeur sur Integer en paramètre. Voyons tout d'abord comment déclarer nos procédures et fonctions sur des prototypes :
Avec cette seconde façon de procéder, il suffira de fournir en paramètre n'importe quel type de pointeur sur Integer, qu'il soit de type T_Pointeur ou autre. Par la suite, nous pourrons appeler nos sous-programmes de différentes façons :
...
Ptr : T_Pointeur ;
N : aliased Integer := 10 ;
BEGIN
Ptr := new Integer ;
Lire(Ptr) ;
Ecrire(N'access) ;
N := Calcul(new integer'(25)) ;
...
Chacun de ces appels est correct. Mais il faut prendre une précaution : le pointeur que vous transmettez à vos fonctions/procédures doit absolument être initialisé et ne pas valoir null ! Faute de quoi, vous aurez le droit à un joli plantage de votre programme.
Seconde remarque d'importance : les pointeurs transmis en paramètres sont de mode in. Autrement dit, la valeur du pointeur (l'adresse sur laquelle il pointe) ne peut pas être modifiée. Cependant, rien n'empêche de modifier la valeur pointée. Ptr n'est accessible qu'en lecture ; Ptr.all est accessible en lecture ET en écriture ! C'est donc comme si nous transmettions Ptr.all comme paramètre en mode in out. Continuons la réflexion : pour les fonctions, il est normalement interdit de fournir des paramètres en mode out ou in out, mais en fournissant un pointeur comme paramètre, cela permet donc d'avoir, dans une fonction, un paramètre Ptr.all en mode in out !
Cette dernière partie théorique s'avère plus compliquée que les autres. Si vous pensez ne pas être encore suffisamment au point sur les pointeurs (joli jeu de mot :-° ), je vous en déconseille la lecture pour l'instant et vous invite à vous exercer davantage. Si vous êtes suffisamment aguerris, alors nous allons passer aux chose très, TRES sérieuses ! :pirate:
Un exemple simple
Commençons par prendre un exemple simple (simpliste même, mais rassurez-vous, l'exemple suivant sera bien plus ardu). Nous disposons de trois fonctions appelées Double( ), Triple( ) et Quadruple( ) dont voici les prototypes :
function Double(n : integer) return integer ;
function Triple(n : integer) return integer ;
function Quadruple(n : integer) return integer ;
Peu nous importe de savoir comment elles ont été implémentées, ce que l'on sait c'est qu'elles nécessitent un paramètre de type integer et renvoient toutes un integer qui est, au choix, le double, le triple ou le quadruple du paramètre fournit. Seulement nous voudrions maintenant créer une procédure Table( ) qui affiche le double, le triple ou le quadruple de tous les nombres entre a et b (a et b étant deux nombres choisis par l'utilisateur, la fonction choisie l'étant elle aussi par l'utilisateur). Nous aurions besoin que les fonctions double( ), triple( ) ou quadruple( ) puissent être transmise à la procédure Table( ) comme de simples paramètres, ce qui éviterait que notre sous-procédure ait à se soucier du choix effectué par l'utilisateur. Nous voudrions ce genre de prototype :
procedure Table(MaFonction : function ;
a,b : integer) ;
Malheureusement, cela n'est pas possible en tant que tel. Pour arriver à cela, nous allons devoir transmettre en paramètre, non pas une fonction, mais un pointeur sur une fonction. Donc première chose : comment déclarer un pointeur sur une fonction ? C'est un peu compliqué car qu'est-ce qu'une fonction ? C'est avant tout des paramètres d'un certain type qui vont être modifiés afin d'obtenir un résultat d'un certain type. Ainsi, si un pointeur pointe sur une fonction à un paramètre, il ne pourra pas pointer sur une fonction à deux paramètres. Si un pointeur pointe sur une fonction renvoyant un integer, il ne pourra pas pointer sur une fonction renvoyant un float. Donc nous devons définir un type T_Ptr_Fonction qui prenne en compte tout cela : nombre et type des paramètres, type de résultat. Ce qui nous amène à la déclaration suivante :
type T_Ptr_Fonction is access function(n : integer) return integer ;
f : T_Ptr_Fonction ;
--f est la notation mathématique usuelle pour fonction
--mais n'oubliez pas qu'il s'agit uniquement d'un pointeur !
Définissons maintenant notre procédure Table :
procedure Table(MaFonction : T_Ptr_Fonction ;
a,b : integer) is
begin
for i in a..b loop
put(i) ;
put(" : ") ;
put(MaFonction.all(i)) ;
new_line ;
end loop ;
end Table ;
Heureusement, le langage Ada nous permet de remplacer la ligne 7 par la ligne ci-dessous pour plus de commodité et de clareté :
put(MaFonction(i)) ;
Toutefois, n'oubliez pas que MaFonction n'est pas une fonction ! C'est un pointeur sur une fonction ! Ada nous fait grâce du .all pour les fonctions pointées à la condition que les paramètres soient écrits. Enfin, il ne reste plus qu'à appeler notre procédure Table( ) dans la procédure principale :
--Choix de la fonction à traiter
put("Souhaitez-vous afficher les doubles(2), les triples(3) ou les quadruples(4) ?") ;
get(choix) ; skip_line ;
case choix is
when 2 => f := double'access ;
when 3 => f := triple'access ;
when others => f := quadruple'access ;
end case ;
--Choix des bornes de l'intervalle
put("A partir de ") ; get(a) ; skip_line ;
put("jusqu'à ") ; get(b) ; skip_line ;
--Affichage de la table de a à b de la fonction f choisie
Table(f,a,b) ;
En procédant ainsi, l'ajout de fonctions Quintuple( ), Decuple( ), Centuple( ) ... fonctionnant sur le même principe que les précédentes se fera très facilement sans modifier le code de la fonction Table( ), mais uniquement la portion de code où l'utilisateur doit faire un choix entre les fonctions. Cela peut paraître anodin à notre niveau, mais ce petit gain de clarté et d'efficacité devient très important lors de projets plus complexes faisant intervenir plusieurs programmeurs. Celui rédigeant le programme Table( ) n'a pas besoin d'attendre que celui rédigeant les fonctions Double( ), Triple( ) ... ait terminé, il peut dors et déjà coder sa procédure en utilisant une fonction f théorique.
Un exemple de la vie courante
Je ne vois toujours pas l'intérêt de créer des pointeurs sur des fonctions ?
Ah bon ? Pourtant vous utilisez en ce moment même ce genre de procédé. ^^ Alors même que vous lisez ces lignes, votre ordinateur doit gérer une liste de programmes divers et variés. Il vous suffit d'appuyer sur Alt+Ctrl+Suppr sous Windows puis de cliquer sur l'onglet Processus pour voir la liste des processus en cours. Sous Linux, ouvrez la console et tapez la commande ps (pour process status).
Comment votre système d'exploitation fait-il pour gérer plusieurs processus ? Entre Explorer, votre navigateur internet, votre antivirus, l'horloge ... sans compter les programmes que vous pourriez encore ouvrir ou fermer, il faut bien que votre système d'exploitation (que ce soit Windows, Linux, MacOS ...) puisse gérer une liste changeante de programmes ! C'est, très schématiquement, ce que nous permettent les pointeurs : gérer des listes de longueurs indéfinies (voir le prochain chapitre) de pointeurs vers des programmes alternativement placés en mémoire vive ou traités par le processeur. Rassurez-vous, je ne compte pas vous faire développer un système d'exploitation dans votre prochain TP, je vous propose là simplement une illustration de notre travail.
Un exemple très ... mathématique
Ce troisième et dernier exemple s'adresse à ceux qui ont des connaissances mathématiques un peu plus poussées (disons, niveau terminale scientifique). En effet, les fonctions sont un outil mathématique très puissant et très courant. Et deux opérations essentielles peuvent-être appliquées aux fonctions : la dérivation et l'intégration. Je souhaiterais traiter ici l'intégration. Ou plutôt, une approximation de l'intégrale d'une fonction par la méthode des trapèzes.
Pour rappel, et sans refaire un cours de Maths, l'intégrale entre a et b d'une fonction f correspond à l'aire comprise entre la courbe représentative de la fonction (entre a et b) et l'axe des abscisses. Pour approximer cette aire, plusieurs méthodes furent inventées, notamment la méthode des rectangles qui consiste à approcher l'aire de cette surface par une série de rectangles. La méthode des trapèzes consiste quant à elle à l'approximer par une série de trapèzes rectangles.
Dans l'exemple ci-dessus, on a cherché l'aire sous la courbe entre 1 et 4. L'intervalle [ 1 ; 4 ] a été partagé en 3 sous-intervalles de longueur 1. La longueur de ces sous-intervalles est appelée le pas. Comment calculer l'aire du trapèze ABB'A' ? De la manière suivante : . Et on remarquera que , , ...
Nous allons donc définir quelques fonctions dont voici les prototypes :
function carre(x : float) return float ;
function cube(x : float) return float ;
function inverse(x : float) return float ;
Nous allons également définir un type T_Pointeur :
type T_Pointeur is access function(x : float) return float ;
Nous aurons besoin d'une fonction Aire_Trapeze et d'une fonction Integrale dont voici les prototypes :
--aire_trapeze() ne calcule l'aire que d'un seul trapèze
--f est la fonction étudiée
--x le "point de départ" du trapèze
--pas correspond au pas, du coup, x+pas est le "point d'arrivée" du trapèze
function aire_trapeze(f : T_Pointeur ; x : float ; pas : float) return float ;
--integrale() effectue la somme des aires de tous les trapèzes ainsi que le calcul du pas
--f est la fonction étudiée
--min et max sont les bornes
--nb_inter est le nombre de sous-intervalles et donc de trapèzes,
--ce qui correspond également à la précision de la mesure
function integrale(f: T_pointeur ;
min,max: float ;
nb_inter : integer) return float is
Je vous laisse le soin de rédiger seuls ces deux fonctions. Cela constituera un excellent exercice sur les pointeurs mais aussi sur les intervalles et le pas. Il ne reste donc plus qu'à appeler notre fonction integrale( ) :
--a,b sont des float saisis par l'utilisateur représentant les bornes de l'intervalle d'intégration
--i est un integer saisi par l'utilisateur représentant le nombre de trapèzes souhaités
integrale(carre'access,a,b,i) ;
integrale(cube'access,a,b,i) ;
integrale(inverse'access,a,b,i) ;
Bon allez ! Je suis bon joueur, :p je vous transmets tout de même un code source possible. Attention, ce code est très rudimentaire, il ne teste pas si la borne inférieure est bel et bien inférieure à la borne supérieure, rien n'est vérifié quant à la continuité ou au signe de la fonction étudiée ... bref, il est éminemment perfectible pour un usage mathématique régulier. Mais là, pas la peine d'insister, vous le ferez vraiment tous seuls. ;)
with ada.Text_IO, ada.Integer_Text_IO, ada.Float_Text_IO ;
use ada.Text_IO, ada.Integer_Text_IO, ada.Float_Text_IO ;
procedure integration is
---------------------------
-- Fonctions de x --
---------------------------
function carre(x : float) return float is
begin
return x**2 ;
end carre ;
function inverse(x:float) return float is
begin
return 1.0/x ;
end inverse ;
function cube(x:float) return float is
begin
return x**3 ;
end cube ;
------------------
-- Types --
------------------
type T_Pointeur is access function (x : float) return float ;
-------------------------
-- Fonctions de f --
-------------------------
function aire_trapeze(f : T_Pointeur ; x : float ; pas : float) return float is
begin
return ((f.all(x)+f(x+pas))/2.0)*pas ;
end aire_trapeze ;
function integrale(f: T_pointeur ; min,max: float ; nb_inter : integer) return float is
res : float := 0.0 ;
pas : float ;
begin
pas := (max-min)/float(nb_inter) ;
for i in 0..nb_inter-1 loop
res := res + aire_trapeze(f,min+float(i)*pas,pas) ;
end loop ;
return res ;
end integrale ;
-------------------------------
-- Procédure principale --
-------------------------------
a,b : float ;
i : integer ;
begin
put("Entre quelles valeurs souhaitez-vous integrer les fonctions ?") ;
get(a) ; get(b) ; skip_line ;
put("Combien de trapezes souhaitez-vous construire ?") ;
get(i) ; skip_line ;
put("L'integrale de la fonction carre est : ") ;
put(integrale(carre'access,a,b,i),Exp=>0) ; new_line ;
put("L'integrale de la fonction inverse est : ") ;
put(integrale(inverse'access,a,b,i),Exp=>0) ; new_line ;
put("L'integrale de la fonction cube est : ") ;
put(integrale(cube'access,a,b,i),Exp=>0) ; new_line ;
end integration ;
Voici un programme tout ce qu'il y a de plus simple :
with ada.Text_IO, ada.Integer_Text_IO ;
use ada.Text_IO, ada.Integer_Text_IO ;
procedure programme is
n,m : integer ;
begin
Put("Choisissez un nombre n :") ; get(n) ; skip_line ;
Put("Choisissez un nombre m :") ; get(m) ; skip_line ;
Put("La somme des nombres choisis est ") ;
Put(n+m) ;
end programme ;
Vous devez modifier ce code de façon à changer le contenu des variables n et m, sans jamais modifier les variables elles-mêmes. Ainsi, le résultat affiché sera faux.
Solution
with ada.Text_IO, ada.Integer_Text_IO ;
use ada.Text_IO, ada.Integer_Text_IO ;
procedure programme is
n,m : aliased integer ;
type T_Pointeur is access all integer ;
P : T_Pointeur ;
begin
Put("Choisissez un nombre n :") ; get(n) ; skip_line ;
P := n'access ;
P.all := P.all + 1 ;
Put("Choisissez un nombre m :") ; get(m) ; skip_line ;
P := m'access ;
P.all := P.all * 3 ;
Put("La somme des nombres choisis est ") ;
Put(n+m) ;
end programme ;
Exercice 2
Énoncé
Reprendre l'exercice précédent, en remplaçant les deux variables n et m par un tableau T de deux entiers puis en modifiant ses valeurs uniquement à l'aide d'un pointeur.
Solution
with ada.Text_IO, ada.Integer_Text_IO ;
use ada.Text_IO, ada.Integer_Text_IO ;
procedure programme is
type T_Tableau is array(1..2) of integer ;
type T_Pointeur is access all T_Tableau ;
T : aliased T_Tableau ;
P : T_Pointeur ;
begin
Put("Choisissez un nombre n :") ; get(T(1)) ; skip_line ;
Put("Choisissez un nombre m :") ; get(T(2)) ; skip_line ;
P := T'access ;
P.all(1):= P.all(1)*18 ;
P.all(2):= P.all(2)/2 ;
Put("La somme des nombres choisis est ") ;
Put(T(1)+T(2)) ;
end programme ;
Exercice 3
Énoncé
Reprendre le premier exercice, en remplaçant les deux variables n et m par un objet de type structuré comportant deux composantes entières puis en modifiant ses composantes uniquement à l'aide d'un pointeur.
Solution
with ada.Text_IO, ada.Integer_Text_IO ;
use ada.Text_IO, ada.Integer_Text_IO ;
procedure programme is
type T_couple is
record
n,m : integer ;
end record ;
type T_Pointeur is access all T_couple ;
Couple : aliased T_couple ;
P : T_Pointeur ;
begin
Put("Choisissez un nombre n :") ; get(couple.n) ; skip_line ;
Put("Choisissez un nombre m :") ; get(couple.m) ; skip_line ;
P := Couple'access ;
P.all.n:= P.all.n**2 ;
P.all.m:= P.all.m mod 3 ;
Put("La somme des nombres choisis est ") ;
Put(Couple.n + Couple.m) ;
end programme ;
Exercice 4
Énoncé
Reprendre le premier exercice. La modification des deux variables n et m se fera cette fois à l'aide d'une procédure dont le(s) paramètres seront en mode in.
Solution
with ada.Text_IO, ada.Integer_Text_IO ;
use ada.Text_IO, ada.Integer_Text_IO ;
procedure programme is
procedure modif(P : access integer) is
begin
P.all := P.all*5 + 8 ;
end modif ;
n,m : aliased integer ;
begin
Put("Choisissez un nombre n :") ; get(n) ; skip_line ;
modif(n'access) ;
Put("Choisissez un nombre m :") ; get(m) ; skip_line ;
modif(m'access) ;
Put("La somme des nombres choisis est ") ;
Put(n+m) ;
end programme ;
Exercice 5 (Niveau Scientifique)
Énoncé
Rédiger un programme calculant le coefficient directeur de la sécante à la courbe représentative d'une fonction f en deux points A et B. A partir de là, il sera possible de réaliser une seconde fonction qui donnera une valeur approchée de la dérivée en un point de la fonction f.
Par exemple, si , alors la fonction Secante(f,2,7) renverra . La fonction Derivee(f,5) renverra quant à elle où h devra être suffisamment petit afin d'améliorer la précision du calcul.
Solution
with ada.Text_IO, ada.Float_Text_IO, ada.Integer_Text_IO ;
use ada.Text_IO, ada.Float_Text_IO, ada.Integer_Text_IO ;
procedure derivation is
type T_Ptr_Fonction is access function(x : float) return float ;
function carre (x : float) return float is begin
return x**2 ;
end carre ;
function cube(x : float) return float is begin
return x**3 ;
end cube;
function inverse(x : float) return float is begin
return 1.0/x ;
end inverse;
function secante(f : T_Ptr_Fonction ;
a : float ;
b : float ) return float is
begin
return (f(b)-f(a))/(b-a) ;
end secante ;
function derivee(f : T_Ptr_Fonction ;
x : float ;
precision : float := 0.000001) return float is
begin
return secante(f,x,x+precision) ;
end derivee ;
choix : integer := 1 ;
f : T_Ptr_Fonction ;
x: float ;
begin
loop
put("Quelle fonction souhaitez-vous deriver ? Inverse(1), Carre(2) ou Cube(3) .") ;
get(choix) ; skip_line ;
case choix is
when 1 => f := inverse'access ;
when 2 => f := carre'access ;
when 3 => f := cube'access ;
when others => exit ;
end case ;
put("Pour quelle valeur de x souhaitez-vous connaitre la derivee ?") ;
get(x) ; skip_line ;
put("La derivee vaut environ") ; put(derivee(f,x),Exp=>0,Aft=>3) ; put(" pour x =") ; put(x,Exp=>0,Aft=>2) ;
new_line ; new_line ;
end loop ;
end derivation ;
Il est possible de demander à l'utilisateur de régler la "précision" lui-même, mais j'ai retiré cette option car elle alourdissait l'utilisation du programme sans apporter de substantiels avantages.
Bien, si vous lisez ces lignes c'est que vous devriez être venus à bout de ces deux chapitres éprouvants. Il est fort possible que vous soyez encore assaillis de nombreuses questions. C'est pourquoi je vous conseille de pratiquer. Ce cours vous a proposé de nombreux exercices, il n'est peut-être pas inutile de reprendre des exercices déjà faits (affichage de tableau, de rectangles ...) et de les retravailler à l'aide des pointeurs car cette notion est réellement compliquée. N'hésitez pas non plus à relire le cours à tête reposée.
Si d'aventure vous pensez maîtriser les pointeurs, alors un véritable test vous attend maintenant. Nous allons mettre en pratique les pointeurs, la récursivité et les packages en créant avec nos petites mains un nouveau type de donnée et les outils pour le manipuler : les types abstraits de donnée ! Là encore, ce sera un chapitre complexe, mêlant théorie et pratique. Mais une fois maîtrisé, il ne vous restera plus que le TP ultime de la partie 3 ! Alors, courage !
Le chapitre que vous vous apprêtez à lire est lui aussi compliqué, mais je vous rassure, vous n'aurez pas de nouveaux objets compliqués à manipuler, non. Vous n'allez même rien apprendre de nouveau concernant la programmation orientée objet.
Mais alors quel intérêt de faire ce chapitre ? o_O
Nous allons aborder une notion d'algorithmique importante et qui nous servira pour le prochain chapitre : la récursivité. Ceux qui mènent (ou ont mené) des études scientifiques devraient me dire : "Ce serait pas plutôt récurrence que récursivité ? " Eh bien non ! Il n'y a pas d'erreur, mais cette notion est très proche du raisonnement par récurrence vu en 1ère et terminale scientifique. Pour ceux qui n'ont pas mené ce genre d'étude, n'ayez aucune crainte, nous allons tout prendre à la base, comme toujours. :D
On dit qu'un programme est récursif si pour parvenir au résultat voulu il se réemploie lui-même. Cela peut s'illustrer par les images suivantes :
Triangle de Sierpinski
Pour réaliser le triangle de sierpinski (premier exemple), on relie les milieux des 3 côtés du grand triangle de manière à former trois triangles "noirs" et un triangle "blanc" à l'envers par rapport aux autres. Puis on reproduit cette opération sur les triangles noirs, et encore, et encore ... jusqu'au nombre désiré (Cette figure fait partie de la grande famille des fractales qui ont pour principe de répéter à l'infini sur elles-mêmes la même opération).
Nautile
Idem pour le nautile, on comprend que pour développer une coquille à 30 alvéoles, le nautile doit avoir développé 29 alvéoles puis en créer seulement une supplémentaire. Le nautile répète ainsi sur lui-même à l'infini ou un grand nombre de fois, la même opération : "ajouter une alvéole". Un dernier exemple : l'éponge de Menger, une autre fractale inspirée du carré de Sierpinski. On a ici détaillé les 4 premières étapes :
Bon, c'est gentil les illustrations, mais à part les coquillages et la géométrie, ça donne quoi en programmation ?
Imaginons que vous deviez créer un programme affichant un petit bonhomme devant monter N marches d'un escalier et que vous disposez pour cela d'une procédure appelée MonterUneMarche. Il y aura deux façons de procéder. Tout d'abord la manière itérative :
PROCÉDURE MonterALaMarche(n) :
POUR i ALLANT de 1 à N
| MonterUneMarche ;
FIN DE BOUCLE
FIN DE PROCÉDURE
Ou alors on emploie une méthode récursive :
PROCÉDURE MonterALaMarche(n) :
SI n > 0
| MonterALaMarche(n-1) ;
| MonterUneMarche ;
FIN DE SI
FIN DE PROCÉDURE
La méthode récursive est un peu bizarre non ? Une explication ? Si on veut monter 0 marche, c'est facile, il n'y a rien à faire. On a gagné ! En revanche, dans le cas contraire, il faut déjà avoir monté n-1 marches puis en gravir une autre. La procédure MonterMarche fait donc appel à elle-même pour une marche de moins. Prenons un exemple, si l'on souhaite monter 4 marches :
4 marches > 0 ! Donc on doit monter déjà 3 marches :
3 marches > 0 ! Donc on doit monter déjà 2 marches :
2 marches > 0 ! Donc on doit monter déjà 1 marche :
1 marche > 0 ! Donc on doit monter déjà 0 marche :
0 marche ! ! ! c'est gagné !
Là on sait faire : le résultat renvoyé est que marche = 0.
On incrémente marche : le résultat renvoyé est que marche = 1.
On incrémente marche : le résultat renvoyé est que marche = 2.
On incrémente marche : le résultat renvoyé est que marche = 3.
On incrémente marche : le résultat renvoyé est que marche = 4.
Ce procédé est un peu plus compliqué à comprendre que la façon itérative (avec les boucles loop). Attention ! Comme pour les boucles itératives, il est possible d'engendrer une "boucle récursive infinie" ! Il est donc très important de réfléchir à la condition de terminaison. En récursivité, cette condition est en général le cas trivial, le cas le plus simple qu'il soit, la condition initiale : l'âge 0, la marche n°0, la lettre 'a' ou la case n°1 d'un tableau. Comme pour les boucles itératives, il est parfois utile de dérouler un exemple simple à la main pour être sûr qu'il n'y a pas d'erreur (souvent l'erreur se fait sur le cas initial).
Nous allons créer une fonction Produit(a,b) qui effectuera le produit (la multiplication) de deux nombres entiers naturels (c'est à dire positifs) a et b. Facile me direz-vous. Sauf que j'ajoute une difficulté : il sera interdit d'utiliser de symbole *. Nous devrons donc implémenter cette fonction uniquement avec des additions et de manière récursive. Cet exemple peut paraître complètement idiot. Toutefois, il vous permettra de réaliser votre premier algorithme récursif et vous verrez que déjà, ce n'est pas de la tarte.
Si vous souhaitez vous lancez seuls, allez-y, je vous y invite. C'est d'ailleurs la meilleure façon de comprendre les difficultés. Sinon, je vous donne quelques indications tout de suite, avant de vous révéler une solution possible.
Indications
Le cas trivial
Tout d'abord quel est le cas trivial, évident ? Autrement dit, quelle sera la condition de terminaison de notre boucle récursive ?
Le cas le plus simple est le cas Produit(a,0) ou Produit(0,b) puisqu'ils renvoient invariablement 0.
Il y a donc deux cas à traiter : si a = 0 ET/OU si b = 0.
Commutativité
o_O Erh ... c'est quoi encore ça ? Je comptais pas faire Bac +10 ! ! !
Pas d'inquiétude. La propriété de commutativité signifie juste que les nombres d'une multiplication peuvent être "commutés", c'est à dire échangés. Autrement dit . En effet, que vous écriviez ou , cela reviendra au même : le résultat vaudra 6 ! C'est une propriété évidente dont ne bénéficie pas la soustraction ou la division par exemple.
Si c'est si évident, pourquoi en parler ?
Eh bien pour régler un problème simple : pour effectuer Produit(2,3), c'est à dire , va-t-on faire (c'est à dire "3 fois" 2) ou (c'est à dire "2 fois" 3) ? Le deuxième choix semble plus rapide car il nécessitera moins d'additions et donc moins de récursions (boucles récursives). Il serait donc judicieux de traiter ce cas avant de commencer. Selon que a sera inférieur ou pas à b, on effectuera Produit(a,b) ou Produit(b,a).
Mise en œuvre
Supposons que a soit plus petit que b. Que doit faire Produit(a,b) (hormis le test de terminaison et d'inversion de a et b) ? Prenons un exemple : Produit(3,5). Nous partons d'un résultat temporaire égal à 0 (res = 0).
3 > 0. Donc notre résultat temporaire est augmenté de 5 (res = 5) et on fait le produit de 2 par 5 : Produit(2,5).
2 > 0. Donc notre résultat temporaire est augmenté de 5 (res = 10) et on fait le produit de 1 par 5 : Produit(1,5).
1 > 0. Donc notre résultat temporaire est augmenté de 5 (res = 15) et on fait le produit de 0 par 5 : Produit(0,5).
0 ! ! ! Facile. On renvoie le résultat temporaire.
Se pose alors un souci : comment transmettre la valeur temporaire de Res, notre résultat ? La fonction Produit n'a que deux paramètres a et b ! L'idée, est de ne pas surcharger la fonction Produit inutilement avec des paramètres inutiles pour l'utilisateur final. Deux solutions s'offrent à vous : soit vous créez un paramètre Res initialisé à 0 (l'utilisateur n'aura ainsi pas besoin de le renseigner) ; soit vous créez une sous-fonction (Pdt, Mult, Multiplication, appelez-la comme vous voudrez) qui, elle, aura trois paramètres.
Tests et temps processeur
Il est temps de faire un bilan : Produit(a,b) doit tester si a est plus petit que b ou égal car sinon il doit lancer Produit(b,a). Puis il doit tester si a vaut 0, auquel cas il renvoie le résultat, sinon il doit lancer Produit(a-1,b).
Nouveau problème, car en exécutant Produit(a-1,b), notre programme va à nouveau tester si a-1 < b ! Or si a était plus petit que b, a - 1 ne risque pas de devenir plus grand. On effectue donc un test inutile. Ce pourrait être anodin, sauf qu'un test prend du temps au processeur et de la mémoire, et ce temps-processeur et cette mémoire seraient plus utiles pour autre chose. Si nous demandons le résultat de Produit(7418,10965), notre programme devra effectuer 7418 tests inutiles ! Quel gâchis.
Deuxième et dernier bilan :
Notre fonction Produit(a,b) se contentera de vérifier si a est plus petit ou égal à b. Et c'est tout. Elle passera ensuite le relais à une sous-fonction (que j'appellerais Pdt).
Notre sous-fonction Pdt sera la vraie fonction récursive. Elle admettra trois paramètres : a, b et res. Le paramètre a devra être impérativement plus petit que b (c'est le travail de la fonction-mère) et res permettra de transmettre la valeur du résultat d'une récursion à l'autre.
Une solution possible
Le code ci-dessous ne constitue en aucun cas la seule et unique solution, mais seulement une solution possible :
function Produit(a,b : natural) return natural is
--------------------------
-- Insérer ici --
-- le code source de --
-- la fonction Pdt --
--------------------------
begin
if a <= b
then return Pdt(a,b,0) ;
else return Pdt(b,a,0) ;
end if ;
end Produit ;
Pour plus de clarté, j'ai écrit une fonction Produit non récursive, mais faisant appel à une sous-fonction Pdt dont le code source n'est pas écrit. Cela permet à la fois d'effectuer la disjonction de cas et surtout de fournir une fonction Produit avec seulement deux paramètres. Rassurez-vous, je vous donne tout de même le code de la sous-fonction récursive :
function Pdt(a,b,res : natural) return natural is
begin
if a = 0
then return res ;
else return Pdt(a-1, b, res + b) ;
end if ;
end Pdt ;
Voici désormais un nouveau programme à réaliser au cours duquel la récursivité va prendre tout son sens. Le principe est d'implémenter un programme Dichotomie() qui recherche un nombre entier dans un tableau préalablement classé par ordre croissant (et sans doublons).
Principe
Par exemple, nous souhaiterions savoir où se trouve le nombre 9 dans le tableau ci-dessous :
1
2
3
4
5
6
7
8
9
0
2
3
5
7
9
15
20
23
Une méthode de bourrin consiste à passer tous les nombres du tableau en revue, de gauche à droite. Dans cet exemple, il faudra donc tester les 6 premiers nombres pour savoir que le 6ème nombre est un 9 ! Comme je vous l'ai dit, 6 tests, c'est une méthode de bourrin. Je vous propose de le faire en 3 étapes seulement avec la méthode par dichotomie (prononcez "dikotomie").
Ca veut dire quoi dichotomie ?
Ce mot vient du grec ancien et signifie "couper en deux". On retrouve le suffixe "tomie" présent dans les mots appendicectomie (opération consistant à couper l'appendice), mammectomie (opération consistant à couper un sein pour lutter contre le cancer du même nom), lobotomie (opération consistant à couper et retirer une partie du cerveau) ... Bref, on va couper notre tableau en deux parties (pas nécessairement égales). Pour mieux comprendre, nous allons dérouler un algorithme par dichotomie avec l'exemple ci-dessus.
Tout d'abord, on regarde le nombre du "milieu", c'est à dire le numéro 5 (opération : ) 1 2 3 4 5 6 7 8 9 0 2 3 5 7 9 15 20 23
Comme il est plus petit que 9, on recommence mais seulement avec la partie supérieure du tableau car comme le tableau est ordonné, il ne peut y avoir de 9 avant ! 6 7 8 9 9 15 20 23
On prend à nouveau le nombre du "milieu". L'opération donne 7,5 ! Donc nous allons considérer que le nombre du "milieu" est le n°7 (je sais, ce n'est pas mathématiquement rigoureux, mais c'est bien pour cela que j'utilise des guillemets depuis le début). 6 7 8 9 9 15 20 23
Le nombre obtenu est plus grand que 9, on recommence donc avec la partie inférieure du tableau.
69
Le nombre du "milieu" est le n°6 (logique) et il vaut 9. C'est gagné ! Notre résultat est que "le 9 est à la 6ème case". 69
1
2
3
4
5
6
7
8
9
0
2
3
5
7
9
15
20
23
6
7
8
9
9
15
20
23
6
7
8
9
9
15
20
23
6
9
6
9
Avec cet algorithme, je n'ai testé que la 5ème, la 7ème et la 6ème valeur du tableau, soit seulement 3 tests au lieu de 6 pour la méthode "bourrin". Et cet écart peut très vite s'accroître notamment pour rechercher de grandes valeurs dans un grand tableau. Nous verrons dans le chapitre sur la complexité des algorithmes que le premier algorithme a une complexité en , tandis que le second a une complexité en . Oui, je sais, pour vous c'est du Chinois. Nous expliquerons cela plus tard, retenez seulement que cela signifie que pour un petit tableau, l'intérêt de la dichotomie est discutable ; en revanche pour un grand ou très grand tableau, il n'y a pas photo sur la plus grande efficacité de la dichotomie.
Mise en œuvre
Nous allons désormais implémenter notre programme Dichotomie(). Toutefois, vous aurez remarqué qu'il utilise des tableaux de tailles différentes. Nous avons donc un souci car nous ne savons déclarer que des tableaux de taille fixe. Deux solutions sont possibles :
Regarder le chapitre de la partie 4 sur la généricité pour pouvoir faire des tableaux dont on ne connaît pas préalablement la taille. Le problème, c'est que l'on risque de vite se mélanger les pinceaux, d'autant plus que ce chapitre est dans une partie encore plus dure.
Faire en sorte que notre programme manipule un tableau T de taille fixe mais aussi deux variables Min et Max qui indiqueront la "plage" du tableau qui nous intéresse ("cherche dans le tableau T entre l'indice Min et l'indice Max"). Nous retiendrons pour l'instant, vous vous en doutez, cette seconde solution. Toutefois, il sera judicieux de reprendre ce programme après avoir vu la généricité.
Autre question : que donne la division 15/2 en Ada ? Réponse :
Reponse : 7_
Puisque nous divisons deux integer, Ada nous renvoie également un integer. Or vous savez bien que cette division ne "tombe pas juste" et qu'elle devrait donner 7,5 ! Mais Ada doit faire un choix : soit la valeur approchée à l'unité près par excès (8) soit la valeur approchée à l'unité près par défaut (7). Le choix a été fait de renvoyer la valeur par défaut car elle correspond à la partie entière du nombre décimal. Toutefois, si vous vouliez savoir durant la programmation de cet algorithme, si un nombre est pair ou impair, je vous rappelle qu'il existe l'opération mod !
Exemple : 15 mod 2 = 1 (Donc 15 est impair) ; 18 mod 2 = 0 (Donc 18 est pair).
Dernier problème à régler : que faire s'il n'y a pas de 9 ? Renvoyer une valeur particulière ? Ce n'est pas la meilleure idée. L'utilisateur final n'est pas sensé le savoir. Renvoyé l'indice de la valeur la plus proche ? Pourquoi pas mais si l'utilisateur ne connaît pas cette nuance, cela peut poser problème. Le mieux serait de renvoyer deux résultats : un booléen Existe indiquant si la valeur existe ou non dans le tableau et une variable Indice indiquant la valeur trouvée (seulement si Existe vaut true).
Dès lors, plusieurs solutions s'offrent à vous : vous pouvez créer un type structuré (avec record) pour renvoyer deux résultats en même temps. Vous pouvez créer une procédure avec deux paramètres en mode out ou bien utiliser un pointeur sur booléen comme paramètre à votre fonction pour savoir savoir si le résultat existe. A vous de choisir.
Solution
Voici une solution possible pour le programme Dichotomie() :
Procedure Dichotomie is
type T_Tableau is array(1..50) of integer ; --à vous de choisir la taille du tableau
type T_Ptr_Bool is access boolean ;
----------------------------------
-- Insérer ici le code source --
-- de la fonction récursive --
----------------------------------
T : T_Tableau ;
Existe : T_Ptr_Bool ;
Indice : integer ;
begin
Init(T) ; --à vous d'initialiser ce tableau
Existe := new boolean ; --création et initialisation du pointeur
Existe.all := false ;
Indice := Dicho(T, 13, Existe, T'first, T'last) ; --on cherche le nombre 13 dans le tableau T
if Existe.all
then put("Le nombre 13 est à l'indice numero") ;
put(Indice) ;
else put("Le nombre 13 n'est pas présent dans le tableau") ;
end if ;
end Dichotomie ;
Dans le programme ci-dessus, on recherche le nombre 13 dans un tableau de 50 cases. La procédure d'initialisation n'est pas écrite, je vous laisse le faire (pensez que le tableau doit être ordonné !). Voici maintenant le code de la fonction Dicho() :
function Dicho(T : T_Tableau ;
N : integer ;
Existe : T_Ptr_Bool ;
Min, Max : integer) return integer is
Milieu : integer ;
begin
Milieu := (Min+Max) / 2 ;
if T(Milieu) = N --Cas où on trouve le nombre N cherché
then Existe.all := true ;
return Milieu ;
elsif Min = Max --Cas où l'on n'a pas trouvé N et où on ne peut plus continuer
then Existe.all := false ; --On indique que N n'existe pas et on renvoie 0.
return 0 ;
elsif T(Milieu) > N --Cas où on peut continuer avec un sous-tableau
then return Dicho(T,N,Existe,Min,Milieu-1) ;
else return Dicho(T,N,Existe,Milieu+1,Max) ;
end if ;
end Dicho ;
Nous avons cette fois réalisé un programme où l'utilisation de la récursivité est vraiment pertinente. À quoi reconnaît-on qu'un programme pourrait être traité de manière récursive ? Tout d'abord il faut avoir besoin de répéter certaines actions. La question est plutôt : pourquoi choisir un algorithme récursif plutôt que itératif ? La réponse est en grande partie dans la définition même de la récursivité. Il faut se trouver face à un problème qui ne se résolve qu'en réemployant les mêmes procédés sur un même objet. Les algorithmes récursifs nécessitent généralement de disjoindre deux cas : le cas simple, trivial et le cas complexe. Ce dernier peut être lui-même subdivisé en plusieurs autres cas (a<b et a>b ; n pair et n impair ...).
Rédiger une fonction récursive Factorielle( ) qui calcule ... la factorielle du nombre donné en argument. Pour exemple, la factorielle de 7 est donnée ainsi : . Ainsi, votre fonction Factorielle(7) renverra 5040.
Solution
function factorielle(n : integer) return integer is
begin
if n>0
then return n*factorielle(n-1) ;
else return 1 ;
end if ;
end factorielle ;
Alors pourquoi ces résultats ? C'est ce que l'on appelle l'overflow. Je vous ai souvent mis en garde : l'infini en informatique n'existe pas, les machines ont beau être ultra-puissantes, elles ont toujours une limite physique. Par exemple, les integer sont codés par le langage Ada sur 32 bits, c'est à dire que l'ordinateur ne peut retenir que des nombres formés de maximum 32 chiffres (ces chiffres n'étant que des 0 ou des 1, c'est ce que l'on appelle le code binaire, seul langage compréhensible par un ordinateur). Pour être plus précis même, le 1er chiffre (on dit le premier bit) correspond au signe : 0 pour positif et 1 pour négatif. Il ne reste donc plus que 31 bits pour coder le nombre. Le plus grand integer enregistrable est donc . Si jamais nous enregistrions un nombre plus grand encore, il nécessiterait plus de bits que l'ordinateur ne peut en fournir, c'est ce que l'on appelle un dépassement de capacité ou overflow. Du coup, le seul bit supplémentaire possible est celui du signe + ou -, ce qui explique les erreurs obtenues à partir de 17.
Exercice 2
Énoncé
Rédiger une fonction récursive Puissance(a,n) qui calcule la puissance n du nombre a (c'est à dire ), mais seulement en utilisant des multiplications.
Solution
function puissance(a,n : integer) return integer is
begin
if n > 0
then return a*puissance(a,n-1) ;
else return 1 ;
end if ;
end puissance ;
Exercice 3
Énoncé
Rédiger des fonction récursives Affichage( ) et Minimum( ). Chacune devra parcourir un tableau, soit pour l'afficher soit pour indiquer l'indice du plus petit élément du tableau.
Solution
type T_Tableau is array(1..10) of integer ;
Procedure Affichage(T : T_Tableau) is
procedure Afg(T : T_Tableau ; dbt : integer) is
begin
put(T(dbt),1) ; put(" ; ") ;
if dbt < T'last
then Afg(T,dbt+1) ;
end if ;
end Afg ;
begin
Afg(T,T'first) ;
end Affichage ;
function Minimum(T:T_Tableau) return integer is
function minimum(T:T_Tableau ; rang, res, min : integer) return integer is
--rang est l'indice que l'on va tester
--res est le résultat temporaire, l'emplacement du minimum trouvé jusque là
--min est le minimum trouvé jusque là
min2 : integer ;
res2 : integer ;
begin
if T(rang) < min
then min2 := T(rang) ;
res2 := rang ;
else min2 := min ;
res2 := res ;
end if ;
if rang = T'last
then return res2 ;
else return minimum(T,rang+1,res2,min2) ;
end if ;
end minimum ;
begin
return minimum(T,T'first+1,T'first,T(T'first)) ;
end Minimum ;
Exercice 4
Énoncé
Rédiger une fonction récursive Effectif(T,x) qui parcourt un tableau T à la recherche du nombre d'apparition de l'élément x. Ce nombre d'apparition est appelé effectif. En le divisant par le nombre total d'élément dans le tableau, on obtient la fréquence (exprimée en pourcentages si vous la multipliez par 100). Cela vous permettra ainsi de rédiger une seconde fonction appelée Fréquence(T,x). Le tableau T pourra contenir ce que vous souhaitez, il peut même s'agir d'un string.
Solution
function effectif(T: T_Tableau ; x : integer) return integer is
function effectif(T:T_Tableau ; x : integer ; rang, eff : integer) return integer is
eff2 : integer ;
begin
if T(rang) = x
then eff2 := eff +1 ;
else eff2 := eff ;
end if ;
if rang=T'last
then return eff2 ;
else return effectif(T,x,rang+1,eff2) ;
end if ;
end effectif ;
begin
return effectif(T,x,T'first,0) ;
end effectif ;
function frequence(T : T_Tableau ; x : integer) return float is
begin
return float(effectif(T,x))/float(T'length)*100.0 ;
end frequence ;
Bien, nous avons désormais terminé ce chapitre sur la récursivité. Mais comme je vous le disais en introduction, cette notion va nous être utile au prochain chapitre puisque nous allons aborder un nouveau type d'objet : les types abstraits de données. Ce chapitre fera appel aux pointeurs, aux types structurés et à la récursivité. Ce sera le dernier chapitre de cette partie et probablement le plus compliqué, donc si vous avez encore des difficultés avec l'une de ces trois notions, je vous invite à relire les chapitres précédents et à vous entraîner car les listes sont des objets un peu plus compliqués à manipuler.
J'espère que ce chapitre vous aura permis d'avoir une idée assez précise de ce qu'est la récursivité et de l'intérêt qu'elle peut représenter en algorithmique. Pour disposer d'un second point de vue, je vous conseille également la lecture du tutoriel de bluestorm disponible sur le site du zéro en cliquant ici. Toutefois, s'il est plus complet concernant la notion de récursivité, ce tutoriel n'est pas rédigé en Ada, vous devrez donc vous contenter de ses explications.
Dans ce chapitre, nous allons aborder un nouveau type d'objet : les Types Abstraits de Données, aussi appelés TAD. De quoi s'agit-il ? Eh bien pour le comprendre, il faut partir du problème qui amène à leur création. Nous avons vu au début de la partie III le type array. Les tableaux sont très pratiques mais ont un énorme inconvénient : il sont contraints. Leur taille est fixée au début du programme et ne peut plus bouger. Imaginons que nous réalisions un jeu d'aventure. Notre personnage découvre des trésors au fil de sa quête, qu'il ajoute à son coffre à trésor. Ce serait idiot de créer un objet coffre de type Tableau. S'il est prévu pour contenir 100 items et que l'on en découvre 101, il sera impossible d'enregistrer notre 101ème item dans le coffre ! Il serait judicieux que le coffre puisse contenir autant de trésors qu'on le souhaite.
Mais il existe bien des unbounded_strings ?!? Alors il y a peut-être des unbounded_array ?
Eh bien non, pas tout à fait. Nous allons donc devoir en créer nous mêmes, avec nos petits doigts : des "listes" d'éléments possiblement infinies. C'est ce que l'on appelle les TAD. Nous ferons un petit tour d'horizon théorique de ce que sont les Types Abstraits de Données. Puis nous créerons dans les parties suivantes quelques types abstraits avant de voir ce que le language Ada nous propose. Nous créerons également les outils minimums nécessaires à leur manipulation avant de voir un exemple d'utilisation.
Comme je viens de vous le dire, les Types Abstraits de Données peuvent s'imaginer comme des "listes" d'éléments. Les tableaux constituent un type possible de TAD. Mais ce qui nous intéresserait davantage, ce serait des "listes infinies". Commençons par faire un point sur le vocabulaire employé. Lorsque je parle de "liste", je commets un abus de langage. En effet, il existe plusieurs types abstraits, et les listes (je devrais parler plus exactement de "listes chaînées" par distinction avec les tableaux) ne constituent qu'un type abstrait parmi tant d'autres. Mais pour mieux comprendre ce que peut être un TAD, nous allons pour l'instant nous accommoder de cet abus (je mettrai donc le mot liste entre guillemets). Voici une représentation possible d'un Type Abstrait de Donnée :
"Liste" vide : un emplacement mémoire a été réquisitionné pour la liste, mais il ne contient rien.
"Liste" contenant un élément : le premier emplacement mémoire contient un nombre (ici 125) et pointe sur un second emplacement mémoire, encore vide pour l'instant.
"Liste" contenant 3 éléments : trois emplacements mémoires ont été réquisitionnés pour contenir des nombres qui se sont ajoutés les uns à la suite des autres. Chaque emplacement pointe ainsi sur le suivant. Le troisième pointe quant à lui sur un quatrième emplacement mémoire vide.
Autres cas
L'exemple ci-dessus est particulier, à plusieurs égards. Il n'existe pas qu'un seul type de "liste" (et je ne compte pas les traiter toutes). La "liste" vue précédemment dispose de certaines propriétés qu'il nous est possible de modifier pour en élaborer d'autres types.
Contraintes de longueur
La "liste" vue ci-dessus n'a pas de contrainte de longueur. On peut y ajouter autant d'éléments que la mémoire de l'ordinateur peut en contenir mais il est impossible d'obtenir le 25ème élément directement, il faut pour cela la parcourir à partir du début. Les tableaux sont quant à eux des listes contraintes et indexées de manière à accéder directement à tout élément, mais la taille est donc définie dès le départ et ne peut plus être modifiée par la suite. Mais vous aurez compris que dans ce chapitre, les tableaux et leurs contraintes de longueur ne nous intéressent guère.
Chaînage
Chaque élément pointe sur son successeur. On dit que la "liste" est simplement chaînée. Une variante serait que chaque élément pointe également sur son prédécesseur. On dit alors que la "liste" est doublement chaînée.
Linéarité
Chaque élément ne pointe que sur un seul autre élément. Il est possible de diversifier cela en permettant à chaque élément de pointer sur plusieurs autres (que ce soit un nombre fixe ou illimité d'éléments). On parlera alors d'arbre et non plus de "liste".
Méthode d'ajout
Chaque élément ajouté l'a été en fin de "liste". Cette méthode est dite FIFO pour First In/First Out, c'est à dire "premier arrivé, premier servi". Le second élément ajouté sera donc en deuxième position, le troisième élément en troisième position ... notre "liste" est ce que l'on appelle une file (en Français dans le texte). C'est ce qui se passe avec les imprimantes reliées à plusieurs PC : le premier à appuyer sur "Impression" aura la priorité sur tous les autres. Logique, me direz-vous.
Mais ce n'est pas obligatoirement le cas. La méthode "inverse" est dite LIFO pour "Last In/First Out", c'est à dire "dernier arrivé, premier servi". Le premier élément ajouté sera évidemment le premier de la "liste". Lorsque l'on ajoute un second élément, c'est lui qui devient le premier de la "liste" et l'ex-premier devient le second. Si on ajoute un troisième élément, il sera le premier de la "liste", l'ex-premier devient le second, l'ex-second (l'ex-ex-premier) devient le troisième ... on dira alors que notre "liste" est une pile. On peut se représenter la situation comme une pile d'assiette : la dernière que vous ajoutez devient la première de la pile. L'historique de navigation de votre navigateur internet agit tel une pile : lorsque vous cliquez sur précédent, la première page qui s'affichera sera la dernière à laquelle vous aviez accédé. La "liste" des modifications apportées à un document est également gérée telle une pile : cliquez sur Annuler et vous annulerez la dernière modification.
Cyclicité
Le dernier élément de notre liste ne pointe sur rien du tout ! Or nous pourrions faire en sorte qu'il pointe sur le premier élément. Il n'y a alors ni début, ni fin : notre liste est ce que l'on appelle un cycle.
Il est bien sûr possible de combiner différentes propriétés : arbres partiellement cycliques, cycles doublement chaînés ... pour élaborer de nouvelles structures.
Primitives
Mais un type abstrait de données se définit également par ses primitives. De quoi s'agit-il ? Les primitives sont simplement les fonctions essentielles s'appliquant à notre structure. Ainsi, pour une file, la fonction Ajouter_a_la_fin( ) constitue une primitive. Pour une pile, ce pourrait être une fonction Ajouter_sur_la_pile( ).
En revanche, une fonction Ranger_a_l_envers(p : pile ) ou Mettre_le_chantier(f : file) ou Reduire_le_nombre_de_branche(a:arbre) ne sont pas des primitives : ce ne sont pas des fonctions essentielles au fonctionnement et à l'utilisation de ces structures (même si ces fonctions ont tout à fait le droit d'exister).
Donc créer un TAD tel une pile, une file ... ce n'est pas seulement créer un nouveau type d'objet, c'est également fournir les primitives qui permettront au programmeur final de le créer, de le détruire, de le manipuler ... sans avoir besoin de connaître sa structure. C'est cet ensemble TAD-Primitives qui constitue ce que l'on appelle une Structure de données.
Mais alors, qu'est-ce que c'est exactement qu'une liste (sans les guillemets) ? :colere2: Tu nous a même parlé de liste chaînée : c'est quoi ?
Une liste chaînée est une structure de données (c'est à dire un type abstrait de données fourni avec des primitives) linéaire et non contrainte. Elle peut être cyclique ou non, simplement ou doublement chaînée. L'accès aux données doit pouvoir se faire librement (ni en FIFO, ni en LIFO) : il doit être possible d'ajouter/modifier/retirer n'importe quel élément sans avoir préalablement retiré ceux qui le précédaient ou le suivaient. Toutefois, il faudra très souvent parcourir la liste chaînée depuis le début avant de pouvoir effectuer un ajout, une modification ou une suppression.
Pour mieux comprendre, je vous propose de créer quelques types abstraits de données (que je nommerai désormais TAD, je sais je suis un peu fainéant :D ). Je vous propose de construire successivement une pile puis une file avant de nous pencher sur les listes chaînées. Cela ne couvrira sûrement pas tout le champ des TAD (ce cours n'y suffirait pas) mais devrait vous en donner une bonne idée et vous livrer des outils parmi les plus utiles à tout bon programmeur.
Nous allons tout d'abord créer un type T_Pile ainsi que les primitives associées. Pour faciliter la réutilisation de ce type d'objet, nous écrirons tout cela dans un package que nous appellerons P_Piles. Vous remarquerez les quelques subtilités d'écriture : P_Pile pour le package ; T_Pile pour le type ; Pile pour la variable. Ce package comportera donc le type T_Pile et les primitives. Nous ajouterons ensuite quelques procédures et fonctions utiles (mais qui ne sont pas des primitives).
Création du type T_Pile
Tout d'abord, rappelons succinctement ce que l'on entend par "pile". Une pile est un TAD linéaire, non cyclique, simplement chaîné et non contraint. Tout ajout/suppression se fait par la méthode LIFO : Last In, First Out ; c'est à dire que le programmeur final ne peut accéder qu'à l'élément placé sur le dessus de la pile. Alors, comment créer une liste infinie de valeurs liées les unes aux autres ? Nous avions dors et déjà approché cette idée lors du précédent chapitre sur les pointeurs. Il suffirait d'un pointeur pointant sur un pointeur pointant sur un pointeur pointant sur un pointeur ... Mais, premier souci, où et comment enregistre-t-on nos données s'il n'y a que des pointeurs ? Une idée ? Avec un type structuré bien sûr ! Schématiquement, nous aurions ceci :
DECLARATION DE MonType :
Valeur : integer, float ou que sais-je ;
Pointeur_vers_le_prochain : pointeur vers MonType ;
FIN DE DECLARATION
Nous pourrions également ajouter une troisième composante (appelée Index ou Indice) pour numéroter nos valeurs. Nous devrons également déclarer notre type de pointeur ainsi :
TYPE T_Pointeur IS ACCESS MonType ;
Sauf que, deuxième souci, si nous le déclarons après MonType, le compilateur va se demander à quoi correspond la composante Pointeur_vers_le_prochain. Et si nous déclarons T_Pointeur avant MonType, le compilateur ne comprendra pas vers quoi il est sensé pointé. :(
Comment résoudre ce dilemme ? C'est le problème de l’œuf et de la poule : qui doit apparaître en premier ? Réfléchissez. Là encore, vous connaissez la solution. Nous l'avons employée pour les packages : il suffit d'employer les prototypes ! Il suffit que nous déclarions MonType avec un prototype (pour rassurer le compilo :) ), puis le type T_Pointeur et enfin que nous déclarions vraiment MonType. Compris ? Alors voilà le code correspondant :
TYPE T_Cellule; --T_Cellule correspond à un élément de la pile
TYPE T_Pile IS ACCESS T_Cellule; --T_Pile correspond au pointeur sur un élément
TYPE T_Cellule IS
RECORD
Valeur : Integer; --Ici on va créer une pile d'entiers
Index : Integer; --Le dernier élément aura l'index N°1
Suivant : T_Pile ; --Le suivant correspond à une "sous-pile"
END RECORD;
Création des primitives
L'idée, en créant ce package, est de concevoir un type T_Pile et toutes les primitives nécessaires à son utilisation de sorte que tout programmeur utilisant ce package n'ait plus besoin de connaître la structure du type T_Pile : il doit tout pouvoir faire avec les primitives fournies sans avoir à mettre les mains dans le cambouis (Nous verrons plus tard comment lui interdire tout accès à ce "cambouis" avec la privatisation de nos packages). De quelles primitives a-t-on alors besoin ? En voici une liste avec le terme Anglais généralement utilisé et une petite explication :
Empiler (Push) : ajoute un élément sur le dessus de la pile. Cet élément devient alors le premier et son indice (composante Index) est supérieur d'une unité à "l'ex-premier" élément.
Dépiler (Pop) : retire le premier élément de la pile, la première cellule. Cette fonction renvoie en résultat la valeur de cette cellule.
Pile_Vide (Empty) : renvoie true si la pile est vide (c'est à dire si pile = null). Primitive importante car il est impossible de dépiler une pile vide.
Longueur (Length) : renvoie la longueur de la pile, c'est à dire le nombre de cellules qu'elle contient.
Premier (First) : renvoie la valeur de la première cellule de la pile sans la dépiler.
Bien, il ne nous reste plus qu'à créer ces primitives. Commençons par la procédure Push(P,n). Elle va recevoir une pile P, qui n'est rien d'autre qu'un pointeur vers la cellule située sur le dessus de la pile. P sera en mode in out. Elle recevra également un Integer n (puisque nous avons choisi les Integer, mais nous pourrions tout aussi bien le faire avec des float ou autre chose). Elle va devoir créer une cellule (et donc un index), la faire pointer sur la cellule située sur le dessus de la pile avant d'être elle-même pointée par P. Compris ? Alors allez-y !
PROCEDURE Push (P : IN OUT T_Pile; N : IN Integer) IS
Cell : T_Cellule;
BEGIN
Cell.Valeur := N ;
IF P /= NULL
THEN Cell.Index := P.All.Index + 1 ;
Cell.Suivant := P.All'ACCESS ;
ELSE Cell.Index := 1 ;
END IF ;
P := NEW T_Cellule'(Cell) ;
END Push ;
Votre procédure Push() est créée ? Enregistrez votre package et créez un programme afin de le tester. Exemple :
with ada.Text_IO, Ada.Integer_Text_IO, P_Pile ;
use ada.Text_IO, Ada.Integer_Text_IO, P_Pile ;
Procedure test is
P : T_Pile ;
BEGIN
Push(P,3) ; Push(P,5) ; Push(P,1) ; Push(P,13) ;
Put(P.all.Index) ; Put(P.all.Valeur) ; new_line ;
Put(P.Suivant.Index) ; Put(P.Suivant.Valeur) ; new_line ;
Put(P.Suivant.suivant.Index) ; Put(P.Suivant.suivant.Valeur) ; new_line ;
Put(P.suivant.suivant.suivant.Index) ; Put(P.Suivant.Suivant.Suivant.Valeur) ;
end Test ;
Maintenant, la procédure Pop(P,N). Je ne reviens pas sur les paramètres ou sur le sens de cette fonction, j'en ai déjà parlé. Je vous rappelle toutefois que cette procédure doit retourner, non pas un objet de type T_Cellule, mais une variable de type Integer, et "rétrécir" la pile. Les paramètres devront donc être en mode OUT (voire IN OUT). Dernier point, si la pile est vide, le programmeur final ne devrait pas la dépiler, mais il lui revient de le vérifier à l'aide de la primitive Empty : ce n'est pas le rôle de nos primitives de gérer les éventuelles bêtises du programmeur final. En revanche, c'est à vous de gérer le cas où la pile ne contiendrait qu'une seule valeur et deviendrait vide dans le code de votre primitive.
PROCEDURE pop(P : IN OUT T_Pile ; N : OUT Integer) IS
BEGIN
N := P.all.valeur ; --ou P.valeur
--P.all est censé exister, ce sera au programmeur final de le vérifier
IF P.all.suivant /= NULL
THEN P := P.suivant ;
ELSE P := null ;
END IF ;
END Pop ;
Maintenant que vos deux procédures principales sont créées (je vous laisse le soin de les tester) nous n'avons plus que trois primitives (assez simples) à coder : Empty( ), First( ) et Length( ). Toutes trois sont des fonctions ne prenant qu'un seul paramètre : une pile P. Elles retourneront respectivement un booléen pour la première et un integer pour les deux suivantes. Je vous écris ci-dessous le code source de P_Pile.adb et P_Pile.ads. Merci qui ?
P_Pile.adb :
PACKAGE BODY P_Pile IS
PROCEDURE Push (
P : IN OUT T_Pile;
N : IN Integer) IS
Cell : T_Cellule;
BEGIN
Cell.Valeur := N ;
IF P /= NULL
THEN
Cell.Index := P.All.Index + 1 ;
Cell.Suivant := P.All'ACCESS ;
ELSE
Cell.Index := 1 ;
END IF ;
P := NEW T_Cellule'(Cell) ;
END Push ;
PROCEDURE Pop (
P : IN OUT T_Pile;
N : OUT Integer) IS
BEGIN
N := P.All.Valeur ; --ou P.valeur
--P.all est censé exister, ce sera au programmeur final de le vérifier
IF P.All.Suivant /= NULL
THEN
P := P.Suivant ;
ELSE
P := NULL ;
END IF ;
END Pop ;
FUNCTION Empty (
P : IN T_Pile)
RETURN Boolean IS
BEGIN
IF P=NULL
THEN
RETURN True ;
ELSE
RETURN False ;
END IF ;
END Empty ;
FUNCTION Length(P : T_Pile) RETURN Integer IS
BEGIN
IF P = NULL
THEN RETURN 0 ;
ELSE RETURN P.Index ;
END IF ;
END Length ;
FUNCTION First(P : T_Pile) RETURN Integer IS
BEGIN
RETURN P.Valeur ;
END First ;
END P_Pile;
P_Pile.ads :
PACKAGE P_Pile IS
TYPE T_Cellule; --T_Cellule correspondant à un élément de la pile
TYPE T_Pile IS ACCESS ALL T_Cellule;--T_Pile correspondant au pointeur sur un élément
TYPE T_Cellule IS
RECORD
Valeur : Integer; --On crée une pile d'entiers
Index : Integer;
Suivant : T_Pile; --Le suivant correspond à une "sous-pile"
END RECORD;
PROCEDURE Push (P : IN OUT T_Pile; N : IN Integer) ;
PROCEDURE Pop (P : IN OUT T_Pile ; N : OUT Integer) ;
FUNCTION Empty (P : IN T_Pile) RETURN Boolean ;
FUNCTION Length(P : T_Pile) RETURN Integer ;
FUNCTION First(P : T_Pile) RETURN Integer ;
END P_Pile;
Jouons avec le package P_Pile
Notre package est enfin fini. Notre TAD est prêt à l'emploi et j'impose maintenant une règle : interdiction de manipuler nos piles autrement qu'à l'aide de nos 5 primitives ! Donc, plus de P.valeur, seulement des First(P) ! Plus de P.suivant, il faudra faire avec Pop(P) ! Cela va quelque peu compliquer les choses mais nous permettra de comprendre comment se manipulent les TAD sans pour autant partir dans des programmes de 300 lignes. L'objectif avec notre type T_Pile, sera de créer une procédure Put(p : T_Pile) qui se charge d'afficher une pile sous forme de colonne. Attention, le but de ce cours n'est pas de créer toutes les fonctions ou procédures utiles à tous les TAD. Il serait par exemple intéressant de créer une procédure ou une fonction get(P). Mais nous n'allons nous concentrer que sur une seule procédure à chaque fois. Libre à vous de combler les manques.
Concernant notre procédure Put(P), deux possibilités s'offrent à nous : soit nous employons une boucle itérative (loop, for, while), soit nous employons une boucle récursive. Vous allez vous rendre compte que la récursivité sied parfaitement aux TAD (ce sera donc ma première solution), mais je vous proposerai également deux autres façons de procéder (avec une boucle for et une boucle while). Voici le premier code, avec la méthode récursive :
procedure Put(P : T_Pile) is
Pile : T_Pile := P ;
N : integer ;
begin
if not Empty(Pile)
then pop(Pile, N) ;
Put(N) ;
new_line ;
Put(Pile) ;
end if ;
end Put ;
Regardons un peu ce code. Tout d'abord, c'est un code que j'aurais tout à fait pu vous proposer avant le chapitre sur les pointeurs : qui peut deviner en voyant ces lignes comment est constitué le type T_Pile ? Personne, car nous avons fourni tous les moyens pour ne pas avoir besoin de le savoir (c'est ce que l'on appelle l'encapsulation, encore une notion que nous verrons dans la partie IV). Que fait donc ce code ? Tout d'abord il teste si la pile est vide ou non. Ce sera toujours le cas. Si elle est vide, c'est fini ; sinon, on dépile la pile afin de pouvoir afficher son premier élément puis on demande d'afficher la nouvelle pile, privée de sa première cellule. J'aurais pu également écrire Put(First(Pile)) avant de dépiler, mais cela m'aurait contraint à manipuler deux fois la pile sans pour autant économiser de variable.
D'ailleurs, tu aurais aussi pu économiser un objet ! Ton objet Pile n'a aucun intérêt, il suffit de dépiler P et d'afficher P !
Non ! Surtout pas ! Tout d'abord, je vous rappelle que P est obligatoirement en mode IN puisqu'il est transmis à une fonction (Empty). Or, la procédure pop( ) a besoin d'un paramètre en mode OUT pour pouvoir dépiler. Il y aurait un conflit. Ensuite, en supposant que le compilateur ne bronche pas, que deviendrait P après son affichage ? Eh bien P serait vide, on aurait perdu toutes les valeurs qui la composait, simplement pour un affichage. C'est pourquoi j'ai créé un objet Pile qui sert ainsi de "roue de secours". Voici maintenant une solution itérative :
while not Empty(Pile) loop
put(First(P)) ;
pop(Pile, N) ;
new_line ;
end loop ;
On répète ainsi les opérations tant que la liste n'est pas vide : afficher le premier élément, dépiler. Enfin, voici une seconde solution itérative (dernière solution proposée) :
for i in 1..Length(P) loop
put(first(Pile)) ;
pop(Pile,N) ;
new_line ;
end loop ;
Ce qui est utilisé ici, ce n'est pas le fait que la liste soit vide, mais le fait que sa longueur soit nulle. Les opérations sont toutefois toujours les mêmes.
Deuxième exemple, les files. Nous allons donc créer un nouveau package P_File. La différence avec la pile ne se fait pas au niveau de l'implémentation. Les files restent linéaires, non cycliques, simplement chaînées et non contraintes.
TYPE T_Cellule;
TYPE T_File IS ACCESS ALL T_Cellule;
TYPE T_Cellule IS
RECORD
Valeur : Integer;
Index : Integer;
Suivant : T_File;
END RECORD;
La différence se fait donc au niveau des primitives puisque c'est la "méthode d'ajout" qui diffère. Les files sont gérées en FIFO : first in, first out. Imaginez pour cela une file d'attente à une caisse : tout nouveau client (une cellule) doit se placer à la fin de la file, la caissière (le programmeur final ou le programme) ne peut traiter que le client en début de file, les autres devant attendre leur tour. Alors de quelles primitives a-t-on besoin ?
Enfiler (Enqueue) : ajoute un élément à la fin de la file. Son indice est donc supérieur d'une unité à l'ancien dernier élément.
Défiler (Dequeue) : renvoie le premier élément de la file et le retire. Cela implique de renuméroter toute la file.
File_Vide (Empty) ; Longueur (Length) ; Premier (First) : même sens et même signification que pour les piles.
Notre travail consistera donc à modifier notre package P_Pile en conséquence. Attention à ne pas aller trop vite ! Les changements, même s'ils semblent a priori mineurs, ne portent pas seulement sur les noms des primitives. L'ajout d'une cellule notamment, n'est plus aussi simple qu'auparavant. Ce travail étant relativement simple (pour peu que vous le preniez au sérieux), il est impératif que vous le fassiez par vous-même ! Cela constituera un excellent exercice sur les pointeurs et la récursivité. Ne consultez mon code qu'à titre de correction. C'est important avant d'attaquer des TAD plus complexes.
PACKAGE BODY P_File IS
PROCEDURE Enqueue (F : IN OUT T_File ; N : IN Integer) IS
Cell : T_Cellule;
BEGIN
Cell.Valeur := N ;
Cell.Suivant := NULL ;
IF F = NULL --Cas où la liste est vide
THEN Cell.Index := 1 ;
F := NEW T_Cellule'(Cell) ;
ELSIF F.Suivant = NULL --Cas où l'on se "situe" sur le dernier élément
THEN Cell.Index := F.Index + 1 ;
F.Suivant := NEW T_Cellule'(Cell) ;
ELSE Enqueue(F.Suivant, N) ; --Cas où l'on n'est toujours pas à la fin de la file
END IF ;
END Enqueue;
PROCEDURE Dequeue (F : IN OUT T_File ; N : OUT Integer) IS
procedure Decrement(F : IN T_File) is
begin
if F /= null
then F.index := F.index - 1 ;
Decrement(F.suivant) ;
end if ;
end Decrement ;
BEGIN
N := F.Valeur ; --F.all est censé exister, ce sera au Programmeur final de le vérifier
IF F.Suivant /= NULL
THEN decrement(F) ; -- !!! Il faut décrémenter les indices !!!
F := F.Suivant ;
ELSE F := NULL ;
END IF ;
END Dequeue;
FUNCTION Empty (F : IN T_File) RETURN Boolean IS
BEGIN
IF F=NULL
THEN RETURN True ;
ELSE RETURN False ;
END IF ;
END Empty ;
FUNCTION Length (F : T_File) RETURN Integer IS
BEGIN
IF F = NULL
THEN RETURN 0 ;
ELSIF F.Suivant = NULL
THEN RETURN F.Index ;
ELSE RETURN Length(F.Suivant) ;
END IF ;
END Length ;
FUNCTION First ( F : T_File) RETURN Integer IS
BEGIN
RETURN F.Valeur ;
END First ;
END P_File;
PACKAGE P_Pile IS
TYPE T_Cellule; --T_Cellule correspondant à un élément de la pile
TYPE T_Pile IS ACCESS ALL T_Cellule;--T_Pile correspondant au pointeur sur un élément
TYPE T_Cellule IS
RECORD
Valeur : Integer; --On crée une pile d'entiers
Index : Integer;
Suivant : T_Pile; --Le suivant correspond à une "sous-pile"
END RECORD;
PROCEDURE Push (P : IN OUT T_Pile; N : IN Integer) ;
PROCEDURE Pop (P : IN OUT T_Pile ; N : OUT Integer) ;
FUNCTION Empty (P : IN T_Pile) RETURN Boolean ;
FUNCTION Length(P : T_Pile) RETURN Integer ;
FUNCTION First(P : T_Pile) RETURN Integer ;
END P_Pile;
Amusons-nous encore
Comme promis, nous allons désormais tester notre structure de données. Mais hors de question de se limiter à refaire une procédure Put( ) ! Ce serait trop simple. Cette fois nous allons également créer une fonction de concaténation !
Rooh ! Encore de la théorie ! Il a pas fini avec ses termes compliqués ? :waw:
Pas d'emballement ! La concaténation est une chose toute simple ! Cela consiste juste à mettre bout à bout deux listes pour en faire une plus grande ! Le symbole régulièrement utilisé en Ada (et dans de nombreux langages) est le symbole & (le ET commercial, aussi appelé esperluette). Donc à vous de créer cette fonction de sorte que l'on puisse écrire : File1 := File2 & File 3 ! N'oubliez pas auparavant de créer une procédure put( ) pour contrôler vos résultats et prenez garde que l'affichage d'une file ne la défile pas définitivement !
procedure Put(F : in out T_File) is
N : integer ;
begin
for i in 1..length(F) loop
dequeue(F,N) ;
put(N) ;
enqueue(F,N) ; --on n'oublie pas de réenfiler l'élement N pour ne pas vider notre file !
end loop ;
end Put ;
function"&"(left,right : in T_File) return T_File is
N : integer ;
L : T_File := Left ;
R : T_File := Right ;
res : T_File ;
begin
for i in 1..length(left) loop --on place les éléments de la file de gauche dans la file résultat
dequeue(L,N) ;
enqueue(res,N) ;
enqueue(L,N) ;
end loop ;
for i in 1..length(right) loop --puis on place ceux de la file de droite dans la file résultat
dequeue(R,N) ;
enqueue(res,N) ;
enqueue(R,N) ;
end loop ;
return res ;
end ;
Explication : si vous avez une liste (3;6;9) et que vous employez un algorithme récursif vous allez d'abord défiler le 3 pour l'afficher et avant de le renfiler, vous allez relancer votre algorithme, gardant le 3 en mémoire. Donc vous défiler le 6 pour l'afficher et avant de le renfiler, vous allez relancer votre algorithme, gardant le 6 en mémoire. Enfin, vous défiler le 9 pour l'afficher, la liste étant vide désormais vous réenfiler le 9, puis le 6, puis le 3. Au final, un simple affichage fait que vous vous retrouvez non plus avec une liste (3;6;9) mais (9;6;3). o_O Ce problème peut être résolu en employant un sous-programme qui inversera la file, mais cette façon de procéder vous semble-t-elle naturelle ? Pas à moi toujours. ;)
Comme vous vous en êtes sûrement rendu compte en testant vos fonctions et procédures, l'utilisation des files, si elle semble similaire à celle des piles, est en réalité fort différente. Chacun de ces TAD a ses avantages et inconvénients. Mais le principal défaut de ces TAD est d'être obligé de défiler/dépiler les éléments les uns après les autres pour pouvoir les traiter, ce qui oblige à les rempiler/renfiler par la suite avec tous les risques que cela implique quant à l'ordre des éléments. Notre troisième TAD va donc régler ce souci puisque nous allons traiter des listes chaînées (et ce sera le dernier TAD linéaire que nous traiterons).
Comme dit précédemment, les listes chaînées sont linéaires, doublement chaînées, non cycliques et non contraintes. Qui plus est, elles pourront être traitées en LIFO (comme une pile) ou en FIFO (comme une file) mais il sera également possible d'insérer un élément au beau "milieu" de la liste. Pour cela, il devra être possible de parcourir la liste sans la "démonter" comme nous le faisions avec les piles ou les files.
Encore un nouveau package ? Je commence à me lasser, moi :o
Heureusement pour vous, le langage Ada intègre, depuis la norme 2005, de nouveaux packages appelés Ada.Containers et qui nous fournissent quelques TAD comme les tables de hachage (que nous verrons bien plus tard) mais surtout les Doubly_Linked_List (listes doublement chaînées) et les Vectors (vecteurs). Ces deux derniers types sont relativement similaires et correspondent aux listes chaînées. Leur différence ? Les Vectors se comportent un peu à la manière des tableaux, chaque vector étant indexé (en général, indexé avec des entiers naturels commençant à 0 ou 1) de sorte qu'il suffit de disposer du numéro d'indice pour accéder à l'élément voulu, alors que les Doubly_Linked_Lists n'utilisent pas d'indices mais un curseur qui pointe sur un élément de la liste et que l'on peut déplacer vers le début ou la fin de la liste.
Le package Ada.Containers.Doubly_Linked_Lists
Mise en place
Commençons par évoquer le type List. Il est accesible via le package Ada.Containers.Doubly_Linked_Lists. Pour lire les spécifications de ce package, il vous suffit d'ouvrir le fichier appelé a-cdlili.ads situé dans le répertoire d'installation de GNAT. Vous trouverez normalement ce répertoire à l'adresse C:\GNAT sous Windows. Il faudra ensuite ouvrir les dossiers 2011\lib\gcc\i686-pc-mingw32\4.5.3\adainclude (ou quelque chose de ce style, les dénominations pouvant varier d'une version à l'autre).
Comme le package Ada.Numerics.Discrete_Random qui nous servait à générer des nombres aléatoires, le package Ada.Containers.Doubly_Linked_Lists est un package générique (nous verrons bientôt la généricité, patience), fait pour n'importe quel type de donnée et nous ne pouvons donc pas l'utiliser en l'état. Nous devons tout d'abord l'instancier, c'est à dire créer un sous-package prévu pour le type de données désiré. Exemple en image :
with Ada.Containers.Doubly_Linked_Lists ;
...
type T_Score is record
name : string(1..3) := " ";
value : natural := 0 ;
end record ;
package P_Lists is new Ada.Containers.Doubly_Linked_Lists(T_Score) ;
use P_Lists ;
L : List ;
C : Cursor ;
Primitives
Nous avons ainsi créé un package P_Lists nous permettant d'utiliser des listes chaînées contenant des éléments de type T_Score. Une liste chaînée est de type List (sans S à la fin !). Nous disposons des primitives suivantes pour comparer deux listes, connaître la longueur d'une liste, savoir si elle est vide, la vider, ajouter un élément au début (Prepend) ou l'ajouter à la fin (Append) :
function "=" (Left, Right : List) return Boolean; --comparaison de deux listes
function Length (Container : List) return Count_Type; --longueur de la liste
function Is_Empty (Container : List) return Boolean; --la liste est-elle vide ?
procedure Clear (Container : in out List); --vide la liste
procedure Prepend --ajoute un élément en début de liste
(Container : in out List;
New_Item : Element_Type;
Count : Count_Type := 1);
procedure Append --ajoute un élément en fin de liste
(Container : in out List;
New_Item : Element_Type;
Count : Count_Type := 1);
De même, il est possible de connaître le premier ou le dernier élément (sans le "délister"), de le supprimer, de savoir si la liste contient un certain élément ou pas ou encore d'inverser la liste à l'aide des primitives suivante :
function First_Element (Container : List) return Element_Type; --renvoie le premier élément
function Last_Element (Container : List) return Element_Type; --renvoie le dernier élément
procedure Delete_First --supprime le premier élément
(Container : in out List;
Count : Count_Type := 1);
procedure Delete_Last --supprime le dernier élément
(Container : in out List;
Count : Count_Type := 1);
function Contains --indique si la liste contient cet élément
(Container : List;
Item : Element_Type) return Boolean;
procedure Reverse_Elements (Container : in out List); --renverse la liste
Bon d'accord, L est une liste chaînée, mais que vient faire C ici ? C'est quoi ce cursor ? o_O
Ce curseur est là pour nous situer sur la liste, pour pointer un élément. Nous ne pouvons travailler seulement avec le premier et le dernier élément. Supposons que nous ayons la liste suivante :
Doubly_Linked_List de scores
Le curseur indique le second élément de la liste. Dès lors, nous pouvons lire cet élément, le modifier, insérer un nouvel élément juste avant lui, le supprimer ou bien l'échanger avec un élément pointé par un second curseur avec les primitives suivantes :
function Element (Position : Cursor) return Element_Type; --renvoie l'élément pointé
procedure Replace_Element --modifie l'élément pointé
(Container : in out List;
Position : Cursor;
New_Item : Element_Type);
procedure Insert --insère un élément devant l'élément pointé
(Container : in out List;
Before : Cursor;
New_Item : Element_Type;
Count : Count_Type := 1);
procedure Delete --supprime l'élément pointé
(Container : in out List;
Position : in out Cursor;
Count : Count_Type := 1);
procedure Swap --échange deux éléments pointés
(Container : in out List;
I, J : Cursor);
Ce curseur peut être placé au début, à la fin de la liste ou être déplacé élément après élément.
function First (Container : List) return Cursor; --place le curseur au début
function Last (Container : List) return Cursor; --place le curseur à la fin
function Next (Position : Cursor) return Cursor; --déplace le curseur sur l'élément suivant
procedure Next (Position : in out Cursor);
function Previous (Position : Cursor) return Cursor; --déplace le curseur sur l'élément précédent
procedure Previous (Position : in out Cursor);
Enfin, il est possible d'appliquer une procédure à tous les éléments d'une liste en utilisant un pointeur sur procédure avec procedure Iterate(Container : List; Process : not null access procedure (Position : Cursor));
Une application
Nous allons créer un programme créant une liste de 5 scores et les affichant. Je vais vous proposer deux procédures d'affichage distinctes. Mais tout d'abord, créons notre liste :
Vous avez remarqué, j'ai créé la même liste que tout à l'heure, avec la procédure Append. Une autre façon de procéder, mais avec la procédure Prepend donnerait
Enfin, voici une première façon, laborieuse d'afficher les éléments de la liste :
procedure put(score : T_SCore) is
begin
Score := Element(C) ;
put_line(Score.name & " a obtenu " & integer'image(Score.value) & " points.") ;
end put ;
...
begin
C := first(L) ;
for i in 1..length(L)-1 loop
put(Element(c)) ;
next(c) ;
end loop ;
put(Element(c)) ;
end ;
Cette première façon utilise le curseur et passe en revue chacun des éléments les uns après les autres. Attention toutefois au cas du dernier élément qui n'a pas de successeur ! A noter également qu'une procédure récursive aurait aussi bien pu faire l'affaire. Enfin, voici une seconde façon de procéder utilisant les pointeurs sur procédure cette fois :
procedure put(C : Cursor) is
score : T_SCore;
begin
Score := Element(C) ;
put_line(Score.name & " a obtenu " & integer'image(Score.value) & " points.") ;
end put ;
...
begin
iterate(L,Put'access) ;
end ;
En utilisant la procédure iterate, nous nous épargnons ici un temps considérable. Cela justifie amplement les efforts que vous avez fourni pour comprendre ce qu'étaient les pointeurs sur procédure.
Le package Ada.Containers.Vectors
Mise en place
Évoquons maintenant le type vector. Il est accesible via le package Ada.Containers.Vectors. Pour lire les spécifications de ce package, il vous suffit d'ouvrir le fichier appelé a-convec.ads. Encore une fois, ce package doit être instancié de la manière suivante :
with Ada.Containers.Vectors ;
...
package P_Vectors is new Ada.Containers.Vectors(Positive,T_Score) ;
use P_Vectors ;
V : Vector ;
Nous créons ainsi un package P_Vectors indexé à l'aide du type Positive (nombre entiers strictement positifs) et contenant des éléments de type T_Score. Nous aurions pu utiliser le type Natural pour l'indexation, mais le type Positive nous garantit que le premier élément du Vector V sera le numéro 1 et non le numéro 0.
Primitives
Les primitives disponibles avec les Doubly_Linked_Lists sont également disponibles pour les Vectors :
overriding function "=" (Left, Right : Vector) return Boolean; --test d'égalité entre deux vectors
function Length (Container : Vector) return Count_Type; --renvoie la longueur du vector
function Is_Empty (Container : Vector) return Boolean; --renvoie true si le vector est vide
procedure Clear (Container : in out Vector); --vide le vector
procedure Prepend --ajoute un élément au début du vector
(Container : in out Vector;
New_Item : Vector);
procedure Append --ajoute un élément à la fin du vector
(Container : in out Vector;
New_Item : Vector);
function First_Element (Container : Vector) return Element_Type; --renvoie la valeur du premier élément du vector
function Last_Element (Container : Vector) return Element_Type; --renvoie la valeur du premier élément du vector
procedure Delete_First --supprimer le premier élément du vector
(Container : in out Vector;
Count : Count_Type := 1);
procedure Delete_Last --supprime le dernier élément du vector
(Container : in out Vector;
Count : Count_Type := 1);
function Contains --indique si un élément est présent dans le vector
(Container : Vector;
Item : Element_Type) return Boolean;
procedure Reverse_Elements (Container : in out Vector); --renverse l'ordre des éléments du vector
D'autres primitives font appel à un curseur, mais je n'y ferai pas référence (vous pouvez les découvrir par vous même). Mais elles ont en général leur équivalent, sans emploi du curseur mais avec un indice.
function Element --renvoie la valeur de l'élément situé à l'indice spécifié
(Container : Vector;
Index : Index_Type) return Element_Type;
procedure Replace_Element --supprime l'élément situé à l'indice spécifié
(Container : in out Vector;
Index : Index_Type;
New_Item : Element_Type);
procedure Insert --insère un nouvel élément avant l'indice spécifié
(Container : in out Vector;
Before : Extended_Index;
New_Item : Element_Type;
Count : Count_Type := 1);
procedure Delete --supprime l'élément situé à l'indice spécifié
(Container : in out Vector;
Index : Extended_Index;
Count : Count_Type := 1);
procedure Swap (Container : in out Vector; I, J : Index_Type); --échange deux éléments
function First_Index (Container : Vector) return Index_Type; --renvoie l'indice du premier élément
function Last_Index (Container : Vector) return Extended_Index; --renvoie l'indice du dernier élément
procedure Iterate --applique la procédure Process à tous les éléments du Vector
(Container : Vector;
Process : not null access procedure (Position : Cursor));
A ces primitives similaires à celles des listes doublement chaînées, il faut encore en ajouter quelques autres :
--Fonctions de concaténation
function "&" (Left, Right : Vector) return Vector;
function "&" (Left : Vector; Right : Element_Type) return Vector;
function "&" (Left : Element_Type; Right : Vector) return Vector;
function "&" (Left, Right : Element_Type) return Vector;
procedure Set_Length --crée un vecteur de longueur donnée
(Container : in out Vector;
Length : Count_Type);
procedure Insert_Space --insère un élément vide avant l'indice spécifié
(Container : in out Vector;
Before : Extended_Index;
Count : Count_Type := 1);
function Find_Index --trouve l'indice d'un élément dans un tableau
(Container : Vector;
Item : Element_Type;
Index : Index_Type := Index_Type'First) return Extended_Index;
Bien sûr, je ne vous ai pas dressé la liste de toutes les fonctions et procédures disponibles, mais vous avez ainsi les principales. A savoir : le type Element_type correspond au type avec lequel vous aurez instancié votre package. De plus, le type Count est une sorte de type integer.
Nous en avons fini avec ce cours semi-théorique, semi-pratique. Nous n'avons bien sûr pas fait le tour de tous les TAD, mais il ne vous est pas interdit (bien au contraire) de développer vos propres types comme des arbres ou des cycles. Cela constitue un excellent exercice d'entraînement à l'algorithmique et à la programmation, vous pousse à manipuler les pointeurs et à user de programmes récursifs.
Nous allons dans le prochain chapitre utiliser ces TAD au travers d'un TP.
La troisième partie se termine ("Enfin !" diront certains) et nous allons donc la conclure comme il se doit par un troisième TP ! Après avoir hésité entre la conception de divers programmes, tel un éditeur de carte ou un éditeur de texte, je me suis dit qu'après le difficile TP n°2 et cette longue partie III, vous aviez bien mérité un TP moins décourageant et plus ludique. C'est pourquoi, après de longues réflexions, j'ai opté pour un jeu : le jeu du Serpent. Vous savez ce vieux jeu que l'on avait sur les vieux portables où un serpent devait manger sans cesse de gros pixels afin de grandir en prenant garde de ne jamais dévorer sa propre queue ou de sortir de l'écran.
Comme d'habitude, je vais vous guider dans sa mise en œuvre, et comme d'habitude tout se fera en console mais ... avec des couleurs ! Prêts ? Voici une image pour vous mettre en bouche :
Comme toujours, avant de nous lancer à l'aveuglette, nous devons définir les fonctionnalités de notre programme, les limites du projet. Il n'est pas question de créer un jeu en 3D ou avec des boutons, des images, une base de données ... nous allons faire plus sobre. Notre programme devra :
s'exécuter en console, je vous l'ai dit. Toutefois, nous ferons en sorte d'afficher quelques couleurs pour égayer tout ça et surtout rendre notre programme facilement jouable. Rassurez-vous, je vous fournirais un package pour cela.
se jouer en temps réel, pas au tour par tour ! Si le joueur ne touche pas au clavier alors son serpent ira droit dans le mur.
gérer et donc éviter les bogues : serpent faisant demi-tour sur lui-même, sortant de la carte ou dont le corps ne suivrait pas la tête dans certaines configurations (je ne rigole pas, vous commettrez sûrement ce genre d'erreur).
permettre au joueur de diriger le serpent au clavier à l'aide des touches fléchées.
Organisation des types et variables
Nous ne savons pas quand le joueur perdra, notre serpent devra donc pouvoir s'allonger indéfiniment (en théorie). Il serait donc judicieux d'utiliser les TAD vus précédemment pour enregitrer les différents anneaux de notre reptile : il sera plus aisé d'agrandir notre serpent à l'aide des primitives append ou prepend qu'en déclarant des tableaux ou je ne sais quoi d'autre. De même, déplacer le serpent reviendra simplement à retirer le dernier anneau de son corps pour le placer en premier dans une nouvelle position. Vous avez le choix entre tous les TAD que vous voulez, mais les Doubly_Linked_Lists ou les Vectors sont les mieux adaptés et comme j'ai une préférence pour le type Vector, la solution que je vous fournirai utilise donc ... les Doubly_Linked_Lists (cherchez la cohérence :p ).
Mais que contiendra notre liste ? Elle contiendra toute une suite de coordonnées : les coordonnées des différentes parties du corps du serpent. Mais ce n'est pas tout ! Le serpent ne peut se limiter à une liste de coordonnées, il faudra également que notre type T_Serpent contienne la direction de la tête du serpent.
Enfin, la taille de l'aire de jeu, la vitesse de déplacement du serpent ou les couleurs utilisées devraient être enregistrées dans des variables (ou des constantes si besoin) toutes inventoriées dans un package. En faisant cela, ces variables deviendront des variables globales, ce qui est généralement risqué mais clarifiera notre code et simplifiera toute modification des paramètres du jeu. Nous reviendrons sur les variables globales dans la prochaine partie.
Depuis le début je vous dis que notre programme sera en couleur, donc il est temps de vous fournir le package nécessaire pour utiliser des couleurs dans la console. Il ne s'agit ni d'un package officiel, ni d'un package de mon crû (mea maxima culpa :( ) mais d'un vieux package mis à notre disposition par Jerry van Dijk et libre de diffusion, appelé NT_Console :
-----------------------------------------------------------------------
--
-- File: nt_console.adb
-- Description: Win95/NT console support
-- Rev: 0.3
-- Date: 08-june-1999
-- Author: Jerry van Dijk
-- Mail: [email protected]
--
-- Copyright (c) Jerry van Dijk, 1997, 1998, 1999
-- Billie Holidaystraat 28
-- 2324 LK LEIDEN
-- THE NETHERLANDS
-- tel int + 31 71 531 43 65
--
-- Permission granted to use for any purpose, provided this copyright
-- remains attached and unmodified.
--
-- THIS SOFTWARE IS PROVIDED ``AS IS'' AND WITHOUT ANY EXPRESS OR
-- IMPLIED WARRANTIES, INCLUDING, WITHOUT LIMITATION, THE IMPLIED
-- WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE.
--
-----------------------------------------------------------------------
pragma C_Pass_By_Copy (128);
with Interfaces; use Interfaces;
package body NT_Console is
pragma Linker_Options ("-luser32");
---------------------
-- WIN32 INTERFACE --
---------------------
Beep_Error : exception;
Fill_Char_Error : exception;
Cursor_Get_Error : exception;
Cursor_Set_Error : exception;
Cursor_Pos_Error : exception;
Buffer_Info_Error : exception;
Set_Attribute_Error : exception;
Invalid_Handle_Error : exception;
Fill_Attribute_Error : exception;
Cursor_Position_Error : exception;
subtype DWORD is Unsigned_32;
subtype HANDLE is Unsigned_32;
subtype WORD is Unsigned_16;
subtype SHORT is Short_Integer;
subtype WINBOOL is Integer;
type LPDWORD is access all DWORD;
pragma Convention (C, LPDWORD);
type Nibble is mod 2 ** 4;
for Nibble'Size use 4;
type Attribute is
record
Foreground : Nibble;
Background : Nibble;
Reserved : Unsigned_8 := 0;
end record;
for Attribute use
record
Foreground at 0 range 0 .. 3;
Background at 0 range 4 .. 7;
Reserved at 1 range 0 .. 7;
end record;
for Attribute'Size use 16;
pragma Convention (C, Attribute);
type COORD is
record
X : SHORT;
Y : SHORT;
end record;
pragma Convention (C, COORD);
type SMALL_RECT is
record
Left : SHORT;
Top : SHORT;
Right : SHORT;
Bottom : SHORT;
end record;
pragma Convention (C, SMALL_RECT);
type CONSOLE_SCREEN_BUFFER_INFO is
record
Size : COORD;
Cursor_Pos : COORD;
Attrib : Attribute;
Window : SMALL_RECT;
Max_Size : COORD;
end record;
pragma Convention (C, CONSOLE_SCREEN_BUFFER_INFO);
type PCONSOLE_SCREEN_BUFFER_INFO is access all CONSOLE_SCREEN_BUFFER_INFO;
pragma Convention (C, PCONSOLE_SCREEN_BUFFER_INFO);
type CONSOLE_CURSOR_INFO is
record
Size : DWORD;
Visible : WINBOOL;
end record;
pragma Convention (C, CONSOLE_CURSOR_INFO);
type PCONSOLE_CURSOR_INFO is access all CONSOLE_CURSOR_INFO;
pragma Convention (C, PCONSOLE_CURSOR_INFO);
function GetCh return Integer;
pragma Import (C, GetCh, "_getch");
function KbHit return Integer;
pragma Import (C, KbHit, "_kbhit");
function MessageBeep (Kind : DWORD) return DWORD;
pragma Import (StdCall, MessageBeep, "MessageBeep");
function GetStdHandle (Value : DWORD) return HANDLE;
pragma Import (StdCall, GetStdHandle, "GetStdHandle");
function GetConsoleCursorInfo (Buffer : HANDLE; Cursor : PCONSOLE_CURSOR_INFO) return WINBOOL;
pragma Import (StdCall, GetConsoleCursorInfo, "GetConsoleCursorInfo");
function SetConsoleCursorInfo (Buffer : HANDLE; Cursor : PCONSOLE_CURSOR_INFO) return WINBOOL;
pragma Import (StdCall, SetConsoleCursorInfo, "SetConsoleCursorInfo");
function SetConsoleCursorPosition (Buffer : HANDLE; Pos : COORD) return DWORD;
pragma Import (StdCall, SetConsoleCursorPosition, "SetConsoleCursorPosition");
function SetConsoleTextAttribute (Buffer : HANDLE; Attr : Attribute) return DWORD;
pragma Import (StdCall, SetConsoleTextAttribute, "SetConsoleTextAttribute");
function GetConsoleScreenBufferInfo (Buffer : HANDLE; Info : PCONSOLE_SCREEN_BUFFER_INFO) return DWORD;
pragma Import (StdCall, GetConsoleScreenBufferInfo, "GetConsoleScreenBufferInfo");
function FillConsoleOutputCharacter (Console : HANDLE; Char : Character; Length : DWORD; Start : COORD; Written : LPDWORD) return DWORD;
pragma Import (Stdcall, FillConsoleOutputCharacter, "FillConsoleOutputCharacterA");
function FillConsoleOutputAttribute (Console : Handle; Attr : Attribute; Length : DWORD; Start : COORD; Written : LPDWORD) return DWORD;
pragma Import (Stdcall, FillConsoleOutputAttribute, "FillConsoleOutputAttribute");
WIN32_ERROR : constant DWORD := 0;
INVALID_HANDLE_VALUE : constant HANDLE := -1;
STD_OUTPUT_HANDLE : constant DWORD := -11;
Color_Value : constant array (Color_Type) of Nibble := (0, 1, 2, 3, 4, 5, 6, 7, 9, 10, 11, 12, 13, 14, 15);
Color_Type_Value : constant array (Nibble) of Color_Type :=
(Black, Blue, Green, Cyan, Red, Magenta, Brown, Gray,
Black, Light_Blue, Light_Green, Light_Cyan, Light_Red,
Light_Magenta, Yellow, White);
-----------------------
-- PACKAGE VARIABLES --
-----------------------
Output_Buffer : HANDLE;
Num_Bytes : aliased DWORD;
Num_Bytes_Access : LPDWORD := Num_Bytes'Access;
Buffer_Info_Rec : aliased CONSOLE_SCREEN_BUFFER_INFO;
Buffer_Info : PCONSOLE_SCREEN_BUFFER_INFO := Buffer_Info_Rec'Access;
-------------------------
-- SUPPORTING SERVICES --
-------------------------
procedure Get_Buffer_Info is
begin
if GetConsoleScreenBufferInfo (Output_Buffer, Buffer_Info) = WIN32_ERROR then
raise Buffer_Info_Error;
end if;
end Get_Buffer_Info;
--------------------
-- CURSOR CONTROL --
--------------------
function Cursor_Visible return Boolean is
Cursor : aliased CONSOLE_CURSOR_INFO;
begin
if GetConsoleCursorInfo (Output_Buffer, Cursor'Unchecked_Access) = 0 then
raise Cursor_Get_Error;
end if;
return Cursor.Visible = 1;
end Cursor_Visible;
procedure Set_Cursor (Visible : in Boolean) is
Cursor : aliased CONSOLE_CURSOR_INFO;
begin
if GetConsoleCursorInfo (Output_Buffer, Cursor'Unchecked_Access) = 0 then
raise Cursor_Get_Error;
end if;
if Visible = True then
Cursor.Visible := 1;
else
Cursor.Visible := 0;
end if;
if SetConsoleCursorInfo (Output_Buffer, Cursor'Unchecked_Access) = 0 then
raise Cursor_Set_Error;
end if;
end Set_Cursor;
function Where_X return X_Pos is
begin
Get_Buffer_Info;
return X_Pos (Buffer_Info_Rec.Cursor_Pos.X);
end Where_X;
function Where_Y return Y_Pos is
begin
Get_Buffer_Info;
return Y_Pos (Buffer_Info_Rec.Cursor_Pos.Y);
end Where_Y;
procedure Goto_XY
(X : in X_Pos := X_Pos'First;
Y : in Y_Pos := Y_Pos'First) is
New_Pos : COORD := (SHORT (X), SHORT (Y));
begin
Get_Buffer_Info;
if New_Pos.X > Buffer_Info_Rec.Size.X then
New_Pos.X := Buffer_Info_Rec.Size.X;
end if;
if New_Pos.Y > Buffer_Info_Rec.Size.Y then
New_Pos.Y := Buffer_Info_Rec.Size.Y;
end if;
if SetConsoleCursorPosition (Output_Buffer, New_Pos) = WIN32_ERROR then
raise Cursor_Pos_Error;
end if;
end Goto_XY;
-------------------
-- COLOR CONTROL --
-------------------
function Get_Foreground return Color_Type is
begin
Get_Buffer_Info;
return Color_Type_Value (Buffer_Info_Rec.Attrib.Foreground);
end Get_Foreground;
function Get_Background return Color_Type is
begin
Get_Buffer_Info;
return Color_Type_Value (Buffer_Info_Rec.Attrib.Background);
end Get_Background;
procedure Set_Foreground (Color : in Color_Type := Gray) is
Attr : Attribute;
begin
Get_Buffer_Info;
Attr.Foreground := Color_Value (Color);
Attr.Background := Buffer_Info_Rec.Attrib.Background;
if SetConsoleTextAttribute (Output_Buffer, Attr) = WIN32_ERROR then
raise Set_Attribute_Error;
end if;
end Set_Foreground;
procedure Set_Background (Color : in Color_Type := Black) is
Attr : Attribute;
begin
Get_Buffer_Info;
Attr.Foreground := Buffer_Info_Rec.Attrib.Foreground;
Attr.Background := Color_Value (Color);
if SetConsoleTextAttribute (Output_Buffer, Attr) = WIN32_ERROR then
raise Set_Attribute_Error;
end if;
end Set_Background;
--------------------
-- SCREEN CONTROL --
--------------------
procedure Clear_Screen (Color : in Color_Type := Black) is
Length : DWORD;
Attr : Attribute;
Home : COORD := (0, 0);
begin
Get_Buffer_Info;
Length := DWORD (Buffer_Info_Rec.Size.X) * DWORD (Buffer_Info_Rec.Size.Y);
Attr.Background := Color_Value (Color);
Attr.Foreground := Buffer_Info_Rec.Attrib.Foreground;
if SetConsoleTextAttribute (Output_Buffer, Attr) = WIN32_ERROR then
raise Set_Attribute_Error;
end if;
if FillConsoleOutputAttribute (Output_Buffer, Attr, Length, Home, Num_Bytes_Access) = WIN32_ERROR then
raise Fill_Attribute_Error;
end if;
if FillConsoleOutputCharacter (Output_Buffer, ' ', Length, Home, Num_Bytes_Access) = WIN32_ERROR then
raise Fill_Char_Error;
end if;
if SetConsoleCursorPosition (Output_Buffer, Home) = WIN32_ERROR then
raise Cursor_Position_Error;
end if;
end Clear_Screen;
-------------------
-- SOUND CONTROL --
-------------------
procedure Bleep is
begin
if MessageBeep (16#FFFFFFFF#) = WIN32_ERROR then
raise Beep_Error;
end if;
end Bleep;
-------------------
-- INPUT CONTROL --
-------------------
function Get_Key return Character is
Temp : Integer;
begin
Temp := GetCh;
if Temp = 16#00E0# then
Temp := 0;
end if;
return Character'Val (Temp);
end Get_Key;
function Key_Available return Boolean is
begin
if KbHit = 0 then
return False;
else
return True;
end if;
end Key_Available;
begin
--------------------------
-- WIN32 INITIALIZATION --
--------------------------
Output_Buffer := GetStdHandle (STD_OUTPUT_HANDLE);
if Output_Buffer = INVALID_HANDLE_VALUE then
raise Invalid_Handle_Error;
end if;
end NT_Console;
-----------------------------------------------------------------------
--
-- File: nt_console.ads
-- Description: Win95/NT console support
-- Rev: 0.2
-- Date: 08-june-1999
-- Author: Jerry van Dijk
-- Mail: [email protected]
--
-- Copyright (c) Jerry van Dijk, 1997, 1998, 1999
-- Billie Holidaystraat 28
-- 2324 LK LEIDEN
-- THE NETHERLANDS
-- tel int + 31 71 531 43 65
--
-- Permission granted to use for any purpose, provided this copyright
-- remains attached and unmodified.
--
-- THIS SOFTWARE IS PROVIDED ``AS IS'' AND WITHOUT ANY EXPRESS OR
-- IMPLIED WARRANTIES, INCLUDING, WITHOUT LIMITATION, THE IMPLIED
-- WARRANTIES OF MERCHANTABILITY AND FITNESS FOR A PARTICULAR PURPOSE.
--
-----------------------------------------------------------------------
package NT_Console is
----------------------
-- TYPE DEFINITIONS --
----------------------
subtype X_Pos is Natural range 0 .. 79;
subtype Y_Pos is Natural range 0 .. 24;
type Color_Type is
(Black, Blue, Green, Cyan, Red, Magenta, Brown, Gray,
Light_Blue, Light_Green, Light_Cyan, Light_Red,
Light_Magenta, Yellow, White);
----------------------
-- EXTENDED PC KEYS --
----------------------
Key_Alt_Escape : constant Character := Character'Val (16#01#);
Key_Control_At : constant Character := Character'Val (16#03#);
Key_Alt_Backspace : constant Character := Character'Val (16#0E#);
Key_BackTab : constant Character := Character'Val (16#0F#);
Key_Alt_Q : constant Character := Character'Val (16#10#);
Key_Alt_W : constant Character := Character'Val (16#11#);
Key_Alt_E : constant Character := Character'Val (16#12#);
Key_Alt_R : constant Character := Character'Val (16#13#);
Key_Alt_T : constant Character := Character'Val (16#14#);
Key_Alt_Y : constant Character := Character'Val (16#15#);
Key_Alt_U : constant Character := Character'Val (16#16#);
Key_Alt_I : constant Character := Character'Val (16#17#);
Key_Alt_O : constant Character := Character'Val (16#18#);
Key_Alt_P : constant Character := Character'Val (16#19#);
Key_Alt_LBracket : constant Character := Character'Val (16#1A#);
Key_Alt_RBracket : constant Character := Character'Val (16#1B#);
Key_Alt_Return : constant Character := Character'Val (16#1C#);
Key_Alt_A : constant Character := Character'Val (16#1E#);
Key_Alt_S : constant Character := Character'Val (16#1F#);
Key_Alt_D : constant Character := Character'Val (16#20#);
Key_Alt_F : constant Character := Character'Val (16#21#);
Key_Alt_G : constant Character := Character'Val (16#22#);
Key_Alt_H : constant Character := Character'Val (16#23#);
Key_Alt_J : constant Character := Character'Val (16#24#);
Key_Alt_K : constant Character := Character'Val (16#25#);
Key_Alt_L : constant Character := Character'Val (16#26#);
Key_Alt_Semicolon : constant Character := Character'Val (16#27#);
Key_Alt_Quote : constant Character := Character'Val (16#28#);
Key_Alt_Backquote : constant Character := Character'Val (16#29#);
Key_Alt_Backslash : constant Character := Character'Val (16#2B#);
Key_Alt_Z : constant Character := Character'Val (16#2C#);
Key_Alt_X : constant Character := Character'Val (16#2D#);
Key_Alt_C : constant Character := Character'Val (16#2E#);
Key_Alt_V : constant Character := Character'Val (16#2F#);
Key_Alt_B : constant Character := Character'Val (16#30#);
Key_Alt_N : constant Character := Character'Val (16#31#);
Key_Alt_M : constant Character := Character'Val (16#32#);
Key_Alt_Comma : constant Character := Character'Val (16#33#);
Key_Alt_Period : constant Character := Character'Val (16#34#);
Key_Alt_Slash : constant Character := Character'Val (16#35#);
Key_Alt_KPStar : constant Character := Character'Val (16#37#);
Key_F1 : constant Character := Character'Val (16#3B#);
Key_F2 : constant Character := Character'Val (16#3C#);
Key_F3 : constant Character := Character'Val (16#3D#);
Key_F4 : constant Character := Character'Val (16#3E#);
Key_F5 : constant Character := Character'Val (16#3F#);
Key_F6 : constant Character := Character'Val (16#40#);
Key_F7 : constant Character := Character'Val (16#41#);
Key_F8 : constant Character := Character'Val (16#42#);
Key_F9 : constant Character := Character'Val (16#43#);
Key_F10 : constant Character := Character'Val (16#44#);
Key_Home : constant Character := Character'Val (16#47#);
Key_Up : constant Character := Character'Val (16#48#);
Key_PageUp : constant Character := Character'Val (16#49#);
Key_Alt_KPMinus : constant Character := Character'Val (16#4A#);
Key_Left : constant Character := Character'Val (16#4B#);
Key_Center : constant Character := Character'Val (16#4C#);
Key_Right : constant Character := Character'Val (16#4D#);
Key_Alt_KPPlus : constant Character := Character'Val (16#4E#);
Key_End : constant Character := Character'Val (16#4F#);
Key_Down : constant Character := Character'Val (16#50#);
Key_PageDown : constant Character := Character'Val (16#51#);
Key_Insert : constant Character := Character'Val (16#52#);
Key_Delete : constant Character := Character'Val (16#53#);
Key_Shift_F1 : constant Character := Character'Val (16#54#);
Key_Shift_F2 : constant Character := Character'Val (16#55#);
Key_Shift_F3 : constant Character := Character'Val (16#56#);
Key_Shift_F4 : constant Character := Character'Val (16#57#);
Key_Shift_F5 : constant Character := Character'Val (16#58#);
Key_Shift_F6 : constant Character := Character'Val (16#59#);
Key_Shift_F7 : constant Character := Character'Val (16#5A#);
Key_Shift_F8 : constant Character := Character'Val (16#5B#);
Key_Shift_F9 : constant Character := Character'Val (16#5C#);
Key_Shift_F10 : constant Character := Character'Val (16#5D#);
Key_Control_F1 : constant Character := Character'Val (16#5E#);
Key_Control_F2 : constant Character := Character'Val (16#5F#);
Key_Control_F3 : constant Character := Character'Val (16#60#);
Key_Control_F4 : constant Character := Character'Val (16#61#);
Key_Control_F5 : constant Character := Character'Val (16#62#);
Key_Control_F6 : constant Character := Character'Val (16#63#);
Key_Control_F7 : constant Character := Character'Val (16#64#);
Key_Control_F8 : constant Character := Character'Val (16#65#);
Key_Control_F9 : constant Character := Character'Val (16#66#);
Key_Control_F10 : constant Character := Character'Val (16#67#);
Key_Alt_F1 : constant Character := Character'Val (16#68#);
Key_Alt_F2 : constant Character := Character'Val (16#69#);
Key_Alt_F3 : constant Character := Character'Val (16#6A#);
Key_Alt_F4 : constant Character := Character'Val (16#6B#);
Key_Alt_F5 : constant Character := Character'Val (16#6C#);
Key_Alt_F6 : constant Character := Character'Val (16#6D#);
Key_Alt_F7 : constant Character := Character'Val (16#6E#);
Key_Alt_F8 : constant Character := Character'Val (16#6F#);
Key_Alt_F9 : constant Character := Character'Val (16#70#);
Key_Alt_F10 : constant Character := Character'Val (16#71#);
Key_Control_Left : constant Character := Character'Val (16#73#);
Key_Control_Right : constant Character := Character'Val (16#74#);
Key_Control_End : constant Character := Character'Val (16#75#);
Key_Control_PageDown : constant Character := Character'Val (16#76#);
Key_Control_Home : constant Character := Character'Val (16#77#);
Key_Alt_1 : constant Character := Character'Val (16#78#);
Key_Alt_2 : constant Character := Character'Val (16#79#);
Key_Alt_3 : constant Character := Character'Val (16#7A#);
Key_Alt_4 : constant Character := Character'Val (16#7B#);
Key_Alt_5 : constant Character := Character'Val (16#7C#);
Key_Alt_6 : constant Character := Character'Val (16#7D#);
Key_Alt_7 : constant Character := Character'Val (16#7E#);
Key_Alt_8 : constant Character := Character'Val (16#7F#);
Key_Alt_9 : constant Character := Character'Val (16#80#);
Key_Alt_0 : constant Character := Character'Val (16#81#);
Key_Alt_Dash : constant Character := Character'Val (16#82#);
Key_Alt_Equals : constant Character := Character'Val (16#83#);
Key_Control_PageUp : constant Character := Character'Val (16#84#);
Key_F11 : constant Character := Character'Val (16#85#);
Key_F12 : constant Character := Character'Val (16#86#);
Key_Shift_F11 : constant Character := Character'Val (16#87#);
Key_Shift_F12 : constant Character := Character'Val (16#88#);
Key_Control_F11 : constant Character := Character'Val (16#89#);
Key_Control_F12 : constant Character := Character'Val (16#8A#);
Key_Alt_F11 : constant Character := Character'Val (16#8B#);
Key_Alt_F12 : constant Character := Character'Val (16#8C#);
Key_Control_Up : constant Character := Character'Val (16#8D#);
Key_Control_KPDash : constant Character := Character'Val (16#8E#);
Key_Control_Center : constant Character := Character'Val (16#8F#);
Key_Control_KPPlus : constant Character := Character'Val (16#90#);
Key_Control_Down : constant Character := Character'Val (16#91#);
Key_Control_Insert : constant Character := Character'Val (16#92#);
Key_Control_Delete : constant Character := Character'Val (16#93#);
Key_Control_KPSlash : constant Character := Character'Val (16#95#);
Key_Control_KPStar : constant Character := Character'Val (16#96#);
Key_Alt_EHome : constant Character := Character'Val (16#97#);
Key_Alt_EUp : constant Character := Character'Val (16#98#);
Key_Alt_EPageUp : constant Character := Character'Val (16#99#);
Key_Alt_ELeft : constant Character := Character'Val (16#9B#);
Key_Alt_ERight : constant Character := Character'Val (16#9D#);
Key_Alt_EEnd : constant Character := Character'Val (16#9F#);
Key_Alt_EDown : constant Character := Character'Val (16#A0#);
Key_Alt_EPageDown : constant Character := Character'Val (16#A1#);
Key_Alt_EInsert : constant Character := Character'Val (16#A2#);
Key_Alt_EDelete : constant Character := Character'Val (16#A3#);
Key_Alt_KPSlash : constant Character := Character'Val (16#A4#);
Key_Alt_Tab : constant Character := Character'Val (16#A5#);
Key_Alt_Enter : constant Character := Character'Val (16#A6#);
--------------------
-- CURSOR CONTROL --
--------------------
function Cursor_Visible return Boolean;
procedure Set_Cursor (Visible : in Boolean);
function Where_X return X_Pos;
function Where_Y return Y_Pos;
procedure Goto_XY
(X : in X_Pos := X_Pos'First;
Y : in Y_Pos := Y_Pos'First);
-------------------
-- COLOR CONTROL --
-------------------
function Get_Foreground return Color_Type;
function Get_Background return Color_Type;
procedure Set_Foreground (Color : in Color_Type := Gray);
procedure Set_Background (Color : in Color_Type := Black);
--------------------
-- SCREEN CONTROL --
--------------------
procedure Clear_Screen (Color : in Color_Type := Black);
-------------------
-- SOUND CONTROL --
-------------------
procedure Bleep;
-------------------
-- INPUT CONTROL --
-------------------
function Get_Key return Character;
function Key_Available return Boolean;
end NT_Console;
Vous savez désormais comment fonctionnent les packages : copiez chacun de ces textes dans un fichier séparé et enregistrez-les sous les noms NT_Console.adb et NT_Console.ads dans le répertoire de votre projet et n'oubliez pas d'écrire la ligne ci-dessous en en-tête de votre projet :
With NT_Console ; Use NT_Console ;
Le contenu en détail
Voyons maintenant le contenu de ce package. Pour cela, ouvrez le fichier NT_Console.ads (le code source ne nous intéresse pas, nous n'allons observer que les spécifications). Pour les plus craintifs, suivez le guide. Pour ceux qui peuvent s'en sortir seuls (et c'est faisable) lisez ce fichier par vous-mêmes.
C'est l'histoire de trois types ...
Ce package est très bien ficelé, il commence par présenter le package : nom, nom de l'auteur, version, date de création, droits ... Je vous conseille de vous en inspirer pour plus de lisibilité dans vos packages. Mais venons-en à ce qui nous intéresse. NT_Console commence par définir trois types et seulement trois :
X_Pos : c'est un Natural entre 0 et 79. Il correspond à la position de votre curseur sur une ligne de votre console : le premier emplacement est le numéro 0, le dernier est le numéro 79. Autrement dit, vous pouvez afficher 80 caractères par ligne.
Y_Pos : c'est un Natural entre 0 et 24. Il correspond au numéro de la ligne à laquelle se situe votre curseur. La première ligne est la numéro 0, la dernière la numéro 24 d'où un total de 25 lignes affichables dans la console. A elles deux, des variables de type X_Pos et Y_Pos vous indiquent où se situe votre curseur à l'écran. Attention, encore une fois, le premier emplacement est le numéro (0,0)
Color_Type : c'est un type énuméré comptant 15 noms de couleur. C'est ce type qui va nous servir à définir la couleur du texte ou de l'arrière plan. Pour ceux qui auraient du mal avec l'Anglais, c'est comme si vous aviez ceci :
type Color_Type is
(Noir, Bleu, Vert, Cyan, Rouge, Magenta, Marron, Gris,
Bleu_Clair, Vert_Clair, Cyan_clair, Rouge_Clair,
Magenta_Clair, Jaune, Blanc);
Puis vient une longue (très longue) liste de constantes correspondant aux valeurs de certaines touches ou combinaisons de touches du clavier.
Et pour quelques fonctions de plus
Nous en venons donc à l'essentiel : les procédures et fonctions. Elles sont très bien rangées en cinq catégories : contrôle du curseur, contrôle de la couleur, contrôle de l'écran, contrôle du son et contrôle des entrées (entrées-clavier bien sûr).
Contrôle du curseur
Pour savoir si le curseur est visible ou non, utilisez la fonction Cursor_Visible. Pour définir si le curseur sera visible ou non utilisez la procédure Set_Cursor(un_booleen).
Pour connaître la position du curseur, c'est à dire connaître ses coordonnées X_Pos et Y_Pos, vous pourrez les fonctions Where_X et Where_Y (Where = où). Enfin, pour modifier cette position, vous utiliserez la procédure Goto_XY() qui prend en paramètre une variable de type X_Pos et une de type Y_Pos.
Contrôle de la couleur
Il y a deux éléments dont nous pouvons modifier la couleur à l'affichage : la couleur du texte (l'avant-plan ou premier plan) et la couleur du fond, du surlignage (l'arrière-plan). C'est à cela que correspondent Foreground (l'avant-plan) et Background (arrière-plan).
Comme toujours, deux actions sont possibles : lire et écrire. Si vous souhaitez connaître la couleur de l'arrière plan, vous devez la lire, la saisir et vous utiliserez donc la fonction get_Background qui vous retournera la couleur de fond. Si vous souhaitez modifier cette couleur, alors saisir une nouvelle couleur, la redéfinir et vous utiliserez la procédure Set_Background(une_couleur). Même chose pour l'avant-plan bien entendu.
Cette section, comme la suivante, ne comporte qu'une seule procédure : Clear_Screen(). Cette procédure prend en paramètre une couleur (une variable de type Color_Type) et, comme son nom l'indique, nettoie l'écran. Plus rien n'est affiché et en plus vous pouvez changer en même temps la couleur de fond de la console. Attention, la couleur de fond de la console est différente de la couleur d'arrière-plan de votre texte !
Contrôle du son
Une seule procédure sans grand intérêt : Bleep. Cette procédure se contente d'émettre un bip, comme si Windows avait rencontré une erreur.
Contrôle des entées clavier
Lorsque l'utilisateur appuie sur les touches du clavier (même sans que votre programme ne l'y ai invité), celui-ci transmet une information à votre ordinateur qui la stocke en mémoire (on parle de mémoire tampon ou de Buffer, souvenez-vous, nous en avions parlé quand nous avions vu l'instruction Skip_line). Ainsi, la mémoire tampon peut contenir toute une série de caractères avant même que le programme n'en ait besoin ou bien être vide alors que le programme attend une réponse. La fonction key_available vous permet de savoir si une touche a été stockée en mémoire tampon. Les fonctions et procédures get, get_line, get_immediate ... se contentent ainsi de piocher dans la mémoire tampon, au besoin en attendant qu'elle se remplisse.
La fonction get_key quant à elle agit un peu à la manière de la procédure get_immediate : elle pioche immédiatement dans la mémoire tampon sans attendre que l'utilisateur valide la saisie avec entrée. Quel intérêt ? Eh bien il y a une petite différence, notamment dans la gestion des touches "spéciales". Par "touches spéciales", j'entends les touches flèches ou F10 par exemple. Essayez ce code :
with nt_console ; use nt_console ;
with ada.text_io ; use ada.Text_IO ;
with ada.Integer_Text_IO ; use ada.Integer_Text_IO ;
procedure test is
c : character ;
begin
loop
c := get_key ;
put("valeur correspondante :") ;
put(character'pos(c)) ;
new_line ;
end loop ;
end test01 ;
Vous vous rendrez compte que toute touche spéciale envoie en fait deux caractères : le caractère n°0 suivi d'un second. Ainsi, la flèche gauche envoie le caractère n°0 suivi du caractère n°75. A l'aide de ce petit programme, vous pourrez récupérer les numéros des touches fléchées qui serviront au joueur à diriger le serpent.
La fonction key_available quant à elle indique si le buffer est vide ou pas. Si elle renvoie true, c'est qu'il y a au moins un caractère en mémoire tampon et que l'on peut le saisir. Chose importante, elle n'attend pas que l'utilisateur appuie sur un touche ! Ainsi, à l'aide de cette fonction, nous pourrons faire en sorte que le serpent continue à avancer sans attendre que l'utilisateur appuie sur une touche ! Nous n'utiliserons get_key que dans le cas où key_available aura préalablement renvoyé true.
Pour mesurer le temps et définir ainsi la vitesse de jeu, nous aurons besoin d'un second package (officiel celui-là) : Ada.Calendar !
Le package Ada.calendar est fait pour nous permettre de manipuler l'horloge. Si vous cherchez le fichier correspondant, il porte le nom a-calend.ads. Deux types essentiels le composent : le type Duration et le type Time (même si Time est une copie de Duration). Duration mesure les durées, Time correspond aux dates. Ce sont tous deux des nombres décimaux, puisque le temps est mesuré en secondes. Attention toutefois aux problèmes de typage ! Nous allons définir deux variables : temps et duree.
temps : time ;
duree : Duration ;
Pour saisir la date actuelle (jour, mois, année, seconde), il faut utiliser la fonction clock :
temps := clock ;
Il est ensuite possible d'effectuer des opérations, par exemple :
duree := clock - temps ;
En soustrayant le temps enregistré dans la variable temps au temps actuel fourni par la fonction clock, on obtient une durée. Il est également possible de soustraire (ou d'ajouter) une durée à un temps, ce qui donne alors un temps. Il est également possible de comparer des variables de type Time ou Duration. Enfin, pour afficher une variable de type Time ou Duration, pensez à la convertir préalablement en Float. Pour en savoir plus sur le package Ada.Calendar, n'hésitez pas à éplucher les fichiers a-calend.adb et a-calend.ads, ils ne sont pas très longs.
Comment je fais pour jouer en temps réel ? Mon serpent ne peut pas avancer tout seul et en même temps attendre que je lui indique la direction à prendre !
Nous allons devoir combiner les deux packages dont je viens de vous parler pour parvenir à ce petit exploit. Le serpent avance case par case, chaque avancée prend un certain temps (pour ma part, j'ai pris une durée de 0.2 secondes) durant lequel le joueur peut appuyer sur les touches de son clavier pour modifier la direction du serpent. Une fois ce temps écoulé, le serpent avance d'une case. Cela nous amène à l'algorithme suivant :
TANT QUE duree<0.2 REPETER
| attendre_une_réaction_du_joueur ;
FIN REPETER
Avancer_le_serpent ;
Le soucis, c'est que si le joueur n'appuie jamais sur le clavier, le programme reste bloqué sur l'instruction attendre_une_réaction_du_joueur et on ne sort jamais de la boucle ...
C'est là qu'intervient le package NT_Console ! Nous ne devons pas attendre que le joueur ait saisi une touche mais simplement nous demander s'il a appuyé sur une touche. Si oui, on saisit effectivement cette touche, sinon on continue à parcourir notre boucle. Cela nous amène à l'algorithme suivant :
if Key_available
then c:=get_key ;
end if ;
Ainsi, le programme ne reste pas bloqué sur get_key indéfiniment. Cependant, nous attendons que le joueur appuie sur une touche fléchée, pas sur une lettre ! Comme je vous l'ai dit, les touches spéciales envoient deux caractères consécutivement : le numéro 0 puis le véritable caractère. Donc nous devons reprendre le code précédent ainsi :
if Key_available
then if character'pos(get_key)=0
then c:=get_key ;
traitement ;
end if ;
end if ;
Comment afficher un serpent et une zone de jeu en couleur ?
Pour cela, regardons la capture d'écran que je vous ai fournie, elle n'est pas parole d'évangile mais elle va nous guider :
Jeu du serpent
Que remarque-t-on ? Tout d'abord, le fond de la console est gris, contrairement à l'aire de jeu qui elle est blanche et au serpent qui est dessiné en bleu par-dessus l'aire de jeu. Nous avons donc trois niveau de couleur :
La couleur de fond de la console : elle sera obtenue lorsque vous utiliser la procédure clear_screen().
La couleur de la zone de jeu : elle est obtenue en fixant la couleur d'arrière-plan et en affichant de simples espaces. Attention à ne pas afficher de caractères avec un arrière-plan blanc en dehors de cette zone. Notamment si vous affichez du texte comme le score ou un message de défaite.
La couleur des items affichés sur la zone de jeu : ces items comme les morceaux du serpent ou l'objet qu'il doit manger, doivent avoir un arrière-plan blanc et un avant-plan bleu (ou n'importe quelle autre couleur de votre choix).
Pensez également que lorsque votre serpent avancera d'une case, il ne suffira pas d'afficher le nouveau serpent, il faudra également penser à effacer l'ancien de l'écran !
Mais d'où tu sors tes ronds, tes rectangles et tes triangles ?
C'est simple. Il suffit de réaliser un petit programme qui affiche tous les caractères du numéro 0 au numéro 255 (à l'aide des attributs 'pos et 'val). On découvre ainsi plein de caractères bizarroïdes comme le trèfle, le cœur, le pique et le carreau ou des flèches, des carrés, ... Pour les rectangles du corps du serpent, j'ai utilisé character'val(219) et character'val(178), pour les triangles j'ai utilisé character'val(16), character'val(17), character'val(30) ou character'val(31) et quant à l'espèce de soleil, il s'agit de character'val(15). Mais ne vous contentez pas de reprendre mot à mot mes propositions, faites des essais et trouvez les symboles qui vous paraissent les plus appropriés.
Par où commencer ?
Nous en sommes au troisième TP, il serait bon que vous commenciez à établir vous-même votre approche du problème. Je ne vais donc pas détailler énormément cette partie. Voici comment j'aborderais ce TP (en entrecoupant chaque étape de divers tests pour trouver d'éventuels bogues) :
Création des types nécessaires pour faire un serpent.
Réalisation des procédures d'affichage de l'aire de jeu et du serpent.
Réalisation des procédures de déplacement et d'agrandissement du serpent + actualisation éventuelle des procédures d'affichage
Réalisation des procédures permettant au Joueur de piloter le Serpent au clavier
Mise en place des règles : interdiction de sortir de l'espace de jeu, de mordre le corps du serpent, d'effectuer des demi-tours.
Réalisation des procédures générant l'item à avaler (appelé Anneau dans mon code) et actualisation des règles : "si le serpent mange l'anneau alors il grandit", "un anneau ne peut apparaître directement sur le serpent".
Éventuels débogages et ajouts de fonctionnalités.
Voilà pour le plan de bataille. Il est succinct mais devrait vous fournir des objectifs partiels facilement atteignables. Je me répète mais n'hésitez pas à effectuer des tests réguliers et approfondis pour être sûr de ne pas avoir créé de bogues. Par exemple, ce n'est pas parce que votre serpent avance correctement vers le haut, qu'il avancera correctement vers la droite ou après avoir effectué un ou deux virages. Et en cas de difficultés persistantes, n'hésitez pas à poser des questions.
with nt_console ; use nt_console ;
with Snake_Variables ; use Snake_Variables ;
with Snake_Programs ; use Snake_Programs ;
with Snake_Screen ; use Snake_Screen ;
procedure Snake is
Serpent : T_Serpent ;
begin
Set_Cursor(false) ;
print_ecran(snake) ;
print_ecran(ready) ;
print_ecran(start) ;
Clear_screen(Couleur_Ecran) ;
print_plateau ;
Init_Serpent(Serpent) ;
Print_Serpent(Serpent) ;
Game(Serpent) ;
end Snake ;
Le package contenant quelques types et surtout les variables nécessaires au programme :
with nt_console ; use nt_console ;
package Snake_Variables is
type T_Coord is record
x,y : integer := 0 ;
end record ;
Longueur : Natural := 30 ;
Hauteur : Natural := 15 ;
subtype Intervalle_Alea is natural range 1..Longueur*Hauteur ;
HDecalage : Natural := (X_Pos'last-X_Pos'first+1-Longueur)/2 ;
VDecalage : Natural := (Y_Pos'last-Y_Pos'first+1-Hauteur)/2 ;
Couleur_Ecran : Color_Type := gray ;
Couleur_Fond : Color_Type := white ;
Couleur_Texte : Color_Type := light_blue ;
Couleur_Anneau: Color_Type := red ;
Duree : Duration := 0.2 ;
Score : Natural := 0 ;
touche : Character ;
end Snake_Variables ;
Le package contenant la plupart des programmes servant au jeu :
with nt_console ; use nt_console ;
with ada.text_io ; use ada.Text_IO ;
with ada.Integer_Text_IO ; use ada.Integer_Text_IO ;
with ada.Calendar ; use ada.Calendar ;
package body Snake_Programs is
---------------------------------
-- AFFICHAGE PLATEAU --
---------------------------------
procedure print_plateau is
begin
print_score ;
new_line(Count(VDecalage)) ;
for j in 1..Hauteur loop
set_background(Couleur_Ecran) ;
for i in 1..HDecalage loop
put(' ') ;
end loop ;
set_background(Couleur_Fond) ;
for i in 1..longueur loop
put(' ') ;
end loop ;
new_line ;
end loop ;
end print_plateau ;
procedure print_score is
begin
set_foreground(green) ;
set_background(Couleur_Ecran) ;
goto_XY(0,0) ;
put("SCORE = ") ; put(Score,4) ;
set_foreground(Couleur_Texte) ;
set_background(Couleur_Fond) ;
end print_score ;
--------------------------------
-- CREATION SERPENT --
--------------------------------
procedure Init_Serpent(Serpent : in out T_Serpent) is
begin
Append(Serpent.corps,(15,7)) ; --placement des anneaux du serpent
Append(Serpent.corps,(15,8)) ;
Append(Serpent.corps,(15,9)) ;
Append(Serpent.corps,(14,9)) ;
Append(Serpent.corps,(13,9)) ;
Serpent.curseur := First(Serpent.corps) ; --placement du curseur sur la tête du serpent
Serpent.direction := (0,-1) ; --direction vers le haut
end Init_Serpent ;
procedure move(Serpent : in out T_Serpent) is
coord: T_coord ;
begin
efface_queue(Serpent) ; --on efface la queue
coord.x := Element(Serpent.curseur ).x + Serpent.direction.x ;
coord.y := Element(Serpent.curseur ).y + Serpent.direction.y ;
Prepend(Serpent.corps,coord) ; --on ajoute une nouvelle tête
Serpent.curseur := Last(Serpent.corps) ;
Delete(serpent.corps,Serpent.curseur) ; --on supprime la queue
Serpent.curseur := First(Serpent.corps) ;
print_serpent(serpent) ; --on affiche le nouveau corps
end move ;
procedure grow(Serpent : in out T_Serpent) is
coord: T_coord ;
begin
coord.x := First_Element(Serpent.corps).x + Serpent.direction.x ;
coord.y := First_Element(Serpent.corps).y + Serpent.direction.y ;
Prepend(Serpent.corps,coord) ; --on ajoute une nouvelle tête
Serpent.curseur := First(Serpent.corps) ;
print_serpent(serpent) ; --on affiche le nouveau corps
end grow ;
function est_sorti(Serpent : T_Serpent) return boolean is
tete : T_Coord ;
begin
tete := First_Element(Serpent.corps) ;
if tete.x < 1 or tete.x > Longueur or tete.y < 1 or tete.y > hauteur
then return true ;
else return false ;
end if ;
end est_sorti ;
function est_mordu(Serpent : T_Serpent) return boolean is
tete : T_Coord ;
Serpent2 : T_Serpent := Serpent ;
begin
tete := First_Element(Serpent2.corps) ;
Delete_first(Serpent2.corps) ;
if Find(Serpent2.corps,tete) /= No_Element --Is_In(tete,Serpent2.corps)
then return true ;
else return false ;
end if ;
end est_mordu ;
function a_mange(Serpent : T_Serpent ; Anneau : T_Coord) return boolean is
tete : T_Coord ;
begin
tete := First_Element(Serpent.corps) ;
if tete = Anneau
then return true ;
else return false ;
end if ;
end a_mange ;
---------------------------------
-- AFFICHAGE SERPENT --
---------------------------------
procedure print_tete(Serpent : in T_Serpent) is
begin
if serpent.direction.x < 0
then put(character'val(17)) ; --regard vers la gauche
elsif serpent.direction.x > 0
then put(character'val(16)) ; --regard vers la droite
elsif serpent.direction.y <0
then put(character'val(30)) ; --regard vers le haut
else put(character'val(31)) ; --regard vers le bas
end if ;
end print_tete ;
procedure print_corps(nb : natural) is
begin
if nb mod 2 =0
then put(character'val(219)) ;
else put(character'val(178)) ;
end if ;
end print_corps ;
procedure print_serpent(Serpent : in out T_Serpent) is
begin
Set_Foreground(Couleur_Texte) ;
for i in 1..length(Serpent.corps) loop
Goto_XY(Element(serpent.curseur).x + HDecalage-1,
Element(serpent.curseur).y + VDecalage-1) ;
if i = 1
then print_tete(serpent) ;
else print_corps(integer(i)) ;
end if ;
Next(Serpent.curseur) ;
end loop ;
Serpent.curseur := First(Serpent.corps) ;
end print_serpent ;
procedure efface_queue(Serpent : in out T_Serpent) is
begin
Serpent.curseur := Last(Serpent.corps) ;
Goto_XY(Element(serpent.curseur).x + HDecalage-1,
Element(serpent.curseur).y + VDecalage-1) ;
put(' ') ;
Serpent.curseur := First(Serpent.corps) ;
end efface_queue ;
---------------------------------
-- GESTION DES ANNEAUX --
---------------------------------
function generer(germe : generator ; Serpent : T_Serpent) return T_Coord IS
temp1,temp2 : Natural ;
anneau : T_Coord ;
BEGIN
loop
temp1 := random(germe) ; temp2 := random(germe) ;
Anneau := (temp1 mod longueur + 1, temp2 mod hauteur +1) ;
if Find(Serpent.corps,Anneau) = No_Element
then return Anneau ;
end if ;
end loop ;
end generer ;
procedure print_anneau(anneau : T_Coord) is
begin
set_foreground(Couleur_Anneau) ;
Goto_XY(anneau.x+Hdecalage-1,anneau.y+Vdecalage-1) ;
put(character'val(15)) ;
set_foreground(Couleur_Texte) ;
end print_anneau ;
--------------------------------
-- PROGRAMME DE JEU --
--------------------------------
procedure Erreur(Message : in String) is
begin
Goto_XY(HDecalage+5,VDecalage+Hauteur+2) ;
set_background(Couleur_Ecran) ;
set_foreground(light_Red) ;
Put(Message) ; delay 1.0 ;
end Erreur ;
procedure un_tour(Serpent : in out T_Serpent) is
choix_effectue : boolean := false ;
Temps : constant Time := clock ;
New_direction : T_Coord ;
begin
while clock-temps<duree loop
if not choix_effectue and then key_available and then character'pos(get_key) = 0
then touche := get_key ;
case character'pos(touche) is
when 72 => New_direction := (0,-1) ; --haut
when 75 => New_direction := (-1,0) ; --gauche
when 77 => New_direction := (1,0) ; --droite
when 80 => New_direction := (0,1) ; --bas
when others => null ;
end case ;
if New_direction.x /= Serpent.direction.x and New_direction.y /= Serpent.direction.y
then Serpent.direction := New_direction ;
choix_effectue := true ;
end if ;
end if ;
end loop ;
end un_tour ;
procedure game(Serpent : in out T_Serpent) is
germe : generator ;
Anneau : T_Coord ;
begin
reset(germe) ;
Anneau := generer(germe,Serpent) ;
Print_anneau(Anneau) ;
loop
un_tour(Serpent) ;
--test pour savoir si le serpent grandit ou avance
if a_mange(serpent,anneau)
then grow(serpent) ;
Score := Score + 100 ;
Print_score ;
Anneau := generer(germe,serpent) ;
Print_anneau(Anneau) ;
else move(serpent) ;
end if ;
--test pour savoir si le serpent meurt
if est_sorti(serpent)
then Erreur("Vous " & character'val(136) & "tes sortis !") ; exit ;
elsif est_mordu(serpent)
then Erreur("Vous vous " & character'val(136) & "tes mordu !") ; exit ;
end if ;
end loop ;
end game ;
end Snake_Programs ;
with Snake_Variables ; use Snake_Variables ;
with ada.Numerics.Discrete_Random ;
with ada.Containers.Doubly_Linked_Lists ; use ada.Containers ;
package Snake_Programs is
package P_Liste is new Ada.Containers.Doubly_Linked_Lists(T_coord) ;
use P_Liste ;
package P_Aleatoire is new ada.Numerics.Discrete_Random(Intervalle_Alea) ;
use P_Aleatoire ;
Type T_Serpent is record
corps : List ;
Curseur : Cursor ;
direction : T_Coord ;
end record ;
procedure print_plateau ;
procedure print_score ;
procedure Init_Serpent(Serpent : in out T_Serpent) ;
procedure move(Serpent : in out T_Serpent) ;
procedure grow(Serpent : in out T_Serpent) ;
function est_sorti(Serpent : T_Serpent) return boolean ;
function est_mordu(Serpent : T_Serpent) return boolean ;
procedure print_tete(Serpent : in T_Serpent) ;
procedure print_corps(nb : natural) ;
procedure print_serpent(Serpent : in out T_Serpent) ;
procedure efface_queue(Serpent : in out T_Serpent) ;
function generer(germe : generator ; Serpent : T_Serpent) return T_Coord ;
procedure print_anneau(anneau : T_Coord) ;
procedure Erreur(Message : in String) ;
procedure un_tour(Serpent : in out T_Serpent) ;
procedure game(Serpent : in out T_Serpent) ;
end Snake_Programs ;
Enfin, le package servant à l'affichage de mes écrans de titre :
with ada.text_IO ; use ada.Text_IO ;
with NT_Console ; use NT_Console ;
With Snake_Variables ; use Snake_Variables ;
package body Snake_screen is
procedure print_line(line : string) is
begin
for i in line'range loop
case line(i) is
when 'R' => set_background(Red) ;
put(' ') ;
set_background(Couleur_Ecran) ;
when 'G' => set_background(Green) ;
put(' ') ;
set_background(Couleur_Ecran) ;
when 'Y' => set_background(Yellow) ;
put(' ') ;
set_background(Couleur_Ecran) ;
when '#' => set_background(Black) ;
put(' ') ;
set_background(Couleur_Ecran) ;
when others => put(' ') ;
end case ;
end loop ;
new_line ;
end print_line ;
procedure print_fichier(name : string) is
F : file_type ;
begin
open(F,In_File,name) ;
clear_screen(couleur_ecran) ;
set_background(Couleur_Ecran) ;
while not end_of_file(f) and not end_of_page(f) loop
print_line(get_line(f) ) ;
end loop ;
close(f) ;
end print_fichier;
procedure print_ecran(Ecran : T_Ecran) is
begin
case Ecran is
when SNAKE => print_fichier("Snake.pic") ; delay 2.5 ;
when START => print_fichier("Start.pic") ; delay 1.0 ;
when READY => print_fichier("Ready.pic") ; delay 1.5 ;
end case ;
end print_ecran;
end Snake_Screen ;
package Snake_Screen is
type T_Ecran is(START,READY,SNAKE) ;
procedure print_line(line : string) ;
procedure print_fichier(name : string) ;
procedure print_ecran(Ecran : T_Ecran) ;
end Snake_Screen ;
Pour finir, je vous transmets également les fichiers .pic (en fait des fichiers textes) servant de support à ces fameux écrans titres (je suis preneur pour tout écran titre pouvant remplacer celui qui ressemble vaguement à un serpent ^^ ):
.
GGGGGGGG
Y YG
G YG
Y YG
GY
GG
GY
GGY
GGGGGGGGGGGY
YGGYGYGYGYGYG
GGGGY
GGY
GGY
GG
GG
YGG
GGGG
YYGGGGGG
YYGGGGGG
YYGGGGG
YYYG
Cette fois, la partie III est bel et bien terminée. Mais vous pouvez bien entendu perfectionner ce jeu en proposant différent niveaux de difficulté (en faisant varier la vitesse, la taille de l'aire de jeu ... ), en ajoutant des adversaires, en proposant un enregistrement des meilleurs scores ... n'hésitez surtout pas à bidouiller, à faire des essais. C'est ainsi que l'on apprend et que l'on progresse. Sur ce, nous allons pouvoir passer à la partie IV. ^^
Nous avons aborder dans ce chapitre la plupart des notions qu'il nous manquait en découvrant des types plus complexes comme les tableaux, les pointeurs, les types abstraits de données ... Vous avez dors et déjà fait un large tour des possibilités et savez désormais programmer en Ada ! :) Enfin, en Ada83. Mais la science de l'informatique évolue sans cesse et la programmation n'échappe pas à cette règle. La norme Ada95 a fait entré le langage Ada dans la catégorie des langages orientés objets. Découvrir cette fameuse POO (Programmation Orientée Objet) sera l'objectif principal de la partie IV.
Et quand est-ce que l'on fera des programmes en Ada plus jolis que ces vilaines consoles ? :'(
Ce sera le rôle de la cinquième partie que d'aborder ces notions au travers de GTK, une librairie qui nous permettra de créer de jolies fenêtres avec de jolis boutons et tout et tout ! ;) Les plus curieux (ou pressés) pourront s'y rendre directement, car il vous sera dors et déjà possible d'obtenir des résultats. Toutefois, pour des applications plus poussées et pour une meilleure compréhension, il sera nécessaire de lire la partie IV.
Lors du chapitre sur les tableaux (partie III), nous avions abordé l'algorithme de tri par sélection (Exercice 3). Cet algorithme consistait à trier un tableau d'entiers du plus petit au plus grand en comparant progressivement les éléments d'un tableau avec leurs successeurs, quitte à effectuer un échange (n'hésitez pas à relire cet exercice si besoin). Comme je vous l'avais alors dit, cet algorithme de tri est très rudimentaire et sa complexité était forte.
C'est quoi la complexité ? Comment peut-on mieux trier un tableau ?
Ce sont les deux questions auxquelles nous allons tenter de répondre. Nous commencerons par évoquer quelques algorithmes de tri (sans chercher à être exhaustif) : tri par sélection (rappel), tri à bulles, tri par insertion, tri rapide, tri fusion et tri par tas. Je vous expliquerai le principe avant de vous proposer un implémentation possible. Ensuite, nous expliquerons en quoi consiste la complexité d'un algorithme et aborderons les aspects mathématiques nécessaires de ce chapitre. Enfin, nous étudierons la complexité de ces différents algorithmes de manière empirique en effectuant quelques mesures.
Commençons par évoquer les algorithmes les plus lents (cette notion de lenteur sera précisée et nuancée plus tard) : tri par sélection, tri par insertion et tri à bulles. Nous aurons par la suite besoin de quelques programmes essentiels : initialisation et affichage d'un tableau, échange de valeurs. Je vous fournis de nouveau le code nécessaire ci-dessous.
function init return T_Tableau is
T:T_Tableau ;
subtype Intervalle is integer range 1..100 ;
package Aleatoire is new Ada.numerics.discrete_random(Intervalle) ;
use Aleatoire ;
Hasard : generator ;
begin
Reset(Hasard) ;
for i in T'range loop
T(i) := random(Hasard) ;
end loop ;
return T ;
end init ;
--Afficher affiche les valeurs d'un tableau sur une même ligne
procedure Afficher(T : T_Tableau) is
begin
for i in T'range loop
Put(T(i),4) ;
end loop ;
end Afficher ;
--Echanger est une procédure qui échange deux valeurs : a vaudra b et b vaudra a
procedure Echanger(a : in out integer ; b : in out integer) is
c : integer ;
begin
c := a ;
a := b ;
b := c ;
end Echanger ;
Tri par sélection (ou par extraction)
Principe
1
2
3
4
5
7
3
18
13
7
Nous allons trier le tableau ci-dessus par sélection. Le principe est simple : nous allons chercher le minimum du tableau et l'échanger avec le premier élément :
Rang 1
1
2
3
4
5
7
3
18
13
7
1
2
3
4
5
3
7
18
13
7
Puis on réitère l'opération : on recherche le minimum du tableau (privé toutefois du premier élément) et on l'échange avec le second (ici pas d'échange nécessaire).
Rang 2
1
2
3
4
5
3
7
18
13
7
On réitère à nouveau l'opération : on recherche le minimum du tableau (privé cette fois des deux premiers éléments) et on l'échange avec le troisième.
Rang 3
1
2
3
4
5
3
7
18
13
7
1
2
3
4
5
3
7
7
13
18
On réitère ensuite avec le quatrième élément et on obtient ainsi un tableau entièrement ordonné par ordre croissant. C'est l'un des algorithmes les plus simples et intuitifs. Pour aller plus loin ou pour davantage d'explications, vous pouvez consulter le tutoriel de K-Phoen à ce sujet (langage utilisé : C).
Mise en œuvre
Le code source de l'algorithme de tri par sélection quelque peu modifié par rapport à la fois précédente :
function RangMin(T : T_Tableau ; debut : integer ; fin : integer) return integer is
Rang : integer := debut ;
Min : integer := T(debut) ;
begin
for i in debut..fin loop
if T(i)<Min
then Min := T(i) ;
Rang := i ;
end if ;
end loop ;
return Rang ;
end RangMin ;
function Trier(Tab : T_Tableau) return T_Tableau is
T : T_Tableau := Tab ;
begin
for i in T'range loop
Echanger(T(i),T(RangMin(T,i,T'last))) ;
end loop ;
return T ;
end Trier ;
Tri par insertion
Principe
Le principe du tri par insertion est le principe utilisé par tout un chacun pour ranger ses cartes : on les classe au fur et à mesure. Imaginons que dans une main de 5 cartes, nous ayons déjà trié les trois premières, nous arrivons donc à la quatrième carte. Que fait-on ? Eh bien c'est simple, on la sort du paquet de cartes pour l'insérer à la bonne place dans la partie des cartes déjà triées. Exemple :
1
2
3
4
5
5
9
10
6
7
1
2
3
4
5
5
6
9
10
7
Il faudra ensuite s'occuper du cinquième élément mais là n'est pas la difficulté, car vous vous en doutez peut-être, mais il est impossible d'insérer un élément entre deux autres dans un tableau. Il n'y a pas de case n°1,5 ! Donc "réinsérer" le quatrième élément dans le tableau consistera en fait à décaler tous ceux qui lui sont supérieurs d'un cran vers la droite. Pour aller plus loin ou pour davantage d'explications, vous pouvez consulter le tutoriel de bluestorm à ce sujet (langage utilisé : C) et sa suite utilisant les listes (langage utilisé : OCaml).
Mise en œuvre
Je vous invite à rédiger cet algorithme par vous-même avant de consulter la solution que je vous propose, c'est la meilleure façon de savoir si vous avez compris le principe ou non (d'autant plus que cet algorithme est relativement simple).
function tri_insertion(T : T_Tableau) return T_Tableau is
Tab : T_Tableau := T ;
begin
for i in T'first + 1 .. T'last loop
for j in reverse T'first + 1..i loop
exit when Tab(j-1)<=Tab(j) ;
echanger(Tab(j-1),Tab(j)) ;
end loop ;
end loop ;
return Tab ;
end Tri_insertion ;
L'instruction exit située au cœur des deux boucles peut être remplacée par un if :
if Tab(j-1)<=Tab(j)
then exit ;
else echanger(Tab(j-1),Tab(j)) ;
end if ;
Tri à bulles (ou par propagation)
Principe
Voici enfin le plus "mauvais" algorithme. Comme les précédents il est plutôt intuitif mais n'est vraiment pas efficace. L'algorithme de tri par propagation consiste à inverser deux éléments successifs s'ils ne sont pas classés dans le bon ordre et à recommencer jusqu'à ce que l'on parcourt le tableau sans effectuer une seule inversion. Ainsi, un petit élément sera échangé plusieurs fois avec ses prédécesseurs jusqu'à atteindre son emplacement définitif : il va se propager peu à peu, ou "remonter" vers la bonne position lentement, comme une bulle d'air remonte peu à peu à la surface (j'ai l'âme d'un poète aujourd'hui ^^ ).
Je ne pense pas qu'un exemple soit nécessaire. L'idée (simple, voire simpliste) est donc de parcourir plusieurs fois le tableau jusqu'à obtenir la solution. Vous vous en doutez, cette méthode est assez peu évoluée et demandera de nombreux passages pour obtenir un tableau rangé. Pour aller plus loin ou pour davantage d'explications, vous pouvez consulter le tutoriel de shareman à ce sujet (langage utilisé : C++).
Mise en œuvre
Là encore, vous devriez être capable en prenant un peu de temps, de coder cet algorithme par vous-même.
function Tri_Bulles(T : T_Tableau) return T_Tableau is
Tab : T_Tableau := T ;
Echange_effectue : boolean := true ;
begin
while Echange_effectue loop
--possibilité d'afficher le tableau en écrivant ici
--Afficher(Tab) ;
Echange_effectue := false ;
for i in Tab'first .. Tab'last-1 loop
if Tab(i) > Tab(i+1)
then echanger(Tab(i), Tab(i+1)) ;
Echange_effectue := true ;
end if ;
end loop ;
end loop ;
return Tab ;
end Tri_Bulles ;
Si vous faites quelques essais en affichant Tab à chaque itération, vous vous rendrez vite compte qu'avec cet algorithme le plus grand élément du tableau est immédiatement propager à la fin du tableau dès le premier passage. Il serait donc plus judicieux de modifier les bornes de la deuxième boucle en écrvant :
Tab'first .. Tab'last-1 - k
Où k correspondrait au nombre de fois que le tableau a été parcouru. Autre amélioration possible : puisque les déplacements des grands éléments vers la droite se font plus vite que celui des petits vers la gauche (déplacement maximal de 1 vers la gauche), pourquoi ne pas changer de sens une fois sur deux : parcourir le tableau de gauche à droite, puis de droite à gauche, puis de gauche à droite ... c'est ce que l'on appelle le Tri Cocktail (Shaker Sort), un poil plus efficace.
Enfin, une dernière amélioration mérite d'être signalée (mais non traitée), c'est le Combsort. Il s'agit d'un tri à bulles nettement amélioré puisqu'il peut rivaliser avec les meilleurs algorithmes de tri. L'idée, plutôt que de comparer des éléments successifs, est de comparer des éléments plus éloignés afin d'éviter les tortues, c'est à dire ces petits éléments qui ne se déplacent que d'un seul cran vers la gauche avec le tri à bulles classique. Ce cours n'ayant pas vocation à rédiger tous les algorithmes de tri possibles et imaginables, consultez le lien ci-dessus ou wikipedia pour en savoir plus.
L'algorithme de tri rapide (ou Quick Sort) a un fonctionnement fort différent des algorithmes précédents et un peu (beaucoup) plus compliqué. Le principe de base est simple mais bizarre a priori : on choisit une valeur dans le tableau appelée pivot (nous prendrons ici la première valeur du tableau) et on déplace avant elle toutes celles qui lui sont inférieures et après elle toutes celles qui lui sont supérieures. Puis, on réitère le procédé avec la tranche de tableau inférieure et la tranche de tableau supérieure à ce pivot. Un exemple serait bon :
13
18
9
15
7
Nous prenons le premier nombre en pivot : 13 et nous plaçons les nombres 9 et 7 avant le 13, les nombres 15 et 18 après le 13 :
9
7
13
15
18
Il ne reste plus ensuite qu'à réitérer l'algorithme sur les deux sous-tableaux :
9
7
15
18
Le premier aura comme pivot 9 et sera réorganisé, le second aura comme pivot 15 et ne nécessitera aucune modification. Il restera alors deux sous-sous-tableaux :
7
18
Comme ces sous-sous-tableaux se résument à une seule valeur, l'algorithme s'arrêtera. Cet algorithme est donc récursif et l'une des difficultés est de répartir les valeurs de part et d'autre du nombre pivot. Revenons, à notre tableau initial. Nous allons chercher le premier nombre plus petit que 13 de gauche à droite avec une variable i, et le premier nombre plus grand que 13 de droite à gauche avec une variable j, jusqu'à ce que i et j se rencontrent :
13
18
9
15
7
On trouve 18 et 7. On les inverse et on continue :
13
7
9
15
18
Le rangement est presque fini, il ne reste plus qu'à inverser le pivot avec le 9 :
9
7
13
15
18
Pour aller plus loin ou pour davantage d'explication, vous pouvez consulter le tutoriel de GUILOooo à ce sujet (langages utilisés : C et OCaml).
Mise en œuvre
Cet algorithme va être plus compliqué à mettre en œuvre. Je vous conseille d'essayer par vous-même afin de faciliter la compréhension de la solution que je vous fournis :
function tri_rapide (T : vecteur) return vecteur is
procedure tri_rapide(T : in out vecteur ; premier,dernier : integer) is
index_pivot : integer := (premier+dernier)/2 ;
j : integer := premier + 1;
begin
if premier < dernier
then echanger(T(premier),T(index_pivot)) ;
index_pivot := premier ;
for i in premier+1..dernier loop
if T(i) < T(index_pivot)
then echanger(T(i),T(j)) ;
j := j +1 ;
end if ;
end loop ;
echanger(T(index_pivot),T(j-1)) ;
index_pivot := j-1 ;
tri_rapide(T, premier, Index_pivot-1) ;
tri_rapide(T, Index_pivot+1, dernier) ;
end if ;
end tri_rapide ;
Tab : Vecteur := T ;
begin
tri_rapide(Tab,Tab'first,Tab'last) ;
return Tab ;
end tri_rapide ;
Nous verrons un peu plus tard pourquoi j'ai du utiliser une procédure plutôt qu'une fonction pour effectuer ce tri.
Tri fusion (ou Merge Sort)
Principe
Ah ! Mon préféré. ^^ Le principe est simple mais rudement efficace (un peu moins que le tri rapide toutefois). Prenons le tableau ci-dessous :
8
5
13
7
10
L'idée est de "scinder" ce tableau en cinq cases disjointes que l'on va "refusionner ensuite, mais dans le bon ordre. Par exemple, les deux premières cases, une fois refusionnées donneront :
5
8
Les deux suivantes donneront :
7
13
Et la dernière va rester seule pour l'instant. Ensuite, on va "refusionner" nos deux minitableaux (la dernière case restant encore seule) :
5
7
8
13
Et enfin, on fusionne ce dernier tableau avec la dernière case restée seule depuis le début :
5
7
8
10
13
Vous l'aurez compris, le tri se fait au moment de la fusion des sous-tableaux. L'idée n'est pas si compliquée à comprendre, mais un peu plus ardue à mettre en œuvre. En fait, nous allons créer une fonction tri_fusion qui sera récursive et qui s'appliquera à des tranches de tableaux (les deux moitiés de tableaux, puis les quatre moitiés de moitiés de tableaux, puis ...) avant de les refusionner. Pour aller plus loin ou pour davantage d'explication, vous pouvez consulter le tutoriel de renO à ce sujet (langage utilisé : Python).
Mise en œuvre
Nous aurons besoin de deux fonctions pour effectuer le tri fusion : une fonction fusion qui fusionnera deux tableaux triés en un seul tableau trié ; et une fonction tri_fusion qui se chargera de scinder le tableau initial en sous-tableaux triés avant de les refusionner à l'aide de la précédente fonction.
function fusion(T1,T2 : Vecteur) return Vecteur is
T : Vecteur(1..T1'length + T2'length) ;
i : integer := T1'first ;
j : integer := T2'first ;
begin
if T1'length = 0
then return T2 ;
elsif T2'length = 0
then return T1 ;
end if ;
for k in T'range loop
if i > T1'last and j > T2'last
then exit ;
elsif i > T1'last
then T(k..T'last) := T2(j..T2'last) ; exit ;
elsif j > T2'last
then T(k..T'last) := T1(i..T1'last) ; exit ;
end if ;
if T1(i) <= T2(j)
then T(k) := T1(i) ;
i := i + 1 ;
else T(k) := T2(j) ;
j := j + 1 ;
end if ;
end loop ;
return T ;
end fusion ;
FUNCTION Tri_fusion(T: Vecteur) RETURN Vecteur IS
lg : constant Integer := T'length;
BEGIN
if lg <= 1
then return T ;
else declare
T1 : Vecteur(T'first..T'first-1+lg/2) ;
T2 : Vecteur(T'first+lg/2..T'last) ;
begin
T1 := tri_fusion(T(T'first..T'first-1+lg/2)) ;
T2 := tri_fusion(T(T'first+lg/2..T'last)) ;
return fusion(T1,T2) ;
end ;
end if ;
END Tri_Fusion;
Tri par tas
Noms alternatifs
Le tri par tas porte également les noms suivants :
Tri arbre
Tri Maximier
Heapsort
Tri de Williams
Principe
5
7
3
8
12
6
L'idée du tri pas tas est de concevoir votre tableau tel un arbre. Par exemple, le tableau ci-dessus devra être vu ainsi :
Chaque "case" de l'arbre est appelée nœud, le premier nœud porte le nom de racine, les derniers le nom de feuille. Si l'on est rendu au nœud numéro (indice dans le tableau initial), ses deux feuilles les numéros et .
L'arbre n'est pas trié pour autant. Pour cela nous devrons le tamiser, c'est-à-dire prendre un nombre et lui faire descendre l'arbre jusqu'à ce que les nombres en dessous lui soient inférieurs. Pour l'exemple, nous allons tamiser le premier nœud (le 5).
En dessous de lui se trouvent deux nœuds : 7 et 3. On choisit le plus grand des deux : 7. Comme 7 est plus grand que 5, on les inverse.
On recommence : les deux nœuds situés en dessous sont 8 et 12. Le plus grand est 12. Comme 12 est plus grand que 5, on les inverse.
Vous avez compris le principe du tamisage ? Très bien. Pour trier notre arbre par tas, nous allons le tamiser en commençant, non pas par la racine de l'arbre, mais par les derniers nœuds (en commençant par la fin en quelque sorte). Bien sûr, il est inutile de tamiser les feuilles de l'arbre : elles ne descendront pas plus bas ! Pour limiter les tests inutiles, nous commencerons par tamiser le 3, puis le 7 et enfin le 5. Du coup, nous ne tamiserons que la moitié des nœuds de l'arbre. Faites l'essai, cela devrait vous donner ceci :
Hein ?!? Plus on descend dans l'arbre plus les nombres sont petits, mais c'est pas trié pour autant ! o_O
En effet. ^^ Mais rassurez-vous, il reste encore une étape, un peu plus complexe. Nous allons parcourir notre arbre en sens inverse encore une fois. Nous allons échanger le dernier nœud de notre arbre tamisé (le 3) avec le premier (le 12) qui est également le plus grand nombre le l'arbre.
Une fois cet échange effectué, nous allons tamiser notre nouvelle racine, en considérant que la dernière feuille ne fait plus partie de l'arbre (elle est correctement placée désormais). Ce qui devrait nous donner ceci :
Cette manœuvre a ainsi pour but de placer sur la dernière feuille, le nombre le plus grand, tout en gardant un sous-arbre qui soit tamisé. Il faut ensuite répéter cette manœuvre avec l'avant-dernière feuille, puis l'avant-avant-dernière feuille ... Jusqu'à arriver à la deuxième (et oui, inutile d'échanger la racine avec elle-même, soyons logique). Nous devrions ainsi obtenir ceci :
Cette fois, l'arbre est trié dans le bon ordre, l'algorithme est terminé. Il ne vous reste plus qu'à l'implémenter. ^^
Mise en œuvre
Vous l'aurez deviné je l'espère, il nous faut une procédure tamiser, en plus de notre fonction Tri_tas. Commencez par la créer et l'essayer sur le premier élément comme nous l'avons fait dans cette section avant de vous lancer dans votre fonction de tri. Pensez qu'il doit être possible de limiter la portion de tableau à tamiser et que pour passer d'un nœud à celui du dessous, il faut multiplier par 2 (pour accéder au nœud en dessous à gauche) et éventuellement lui ajouter 1 (pour accéder à celui en dessous à droite).
procedure tamiser(T : in out vecteur ;
noeud : integer ;
max : integer) is
racine : integer := noeud ;
feuille : integer := 2 * noeud ;
begin
while feuille <= max loop
if feuille+1 <= max and then T(feuille)<T(feuille+1)
then feuille := feuille + 1 ;
end if ;
if T(racine)<T(feuille)
then echanger(T(racine), T(feuille)) ;
end if ;
racine := feuille ;
feuille := 2 * racine ;
end loop ;
end tamiser ;
function tri_tas(T : vecteur) return vecteur is
Arbre : vecteur(1..T'length) := T ;
begin
for i in reverse 1..Arbre'length/2 loop
tamiser(Arbre,i,Arbre'length) ;
end loop ;
for i in reverse 2..Arbre'last loop
echanger(Arbre(i),Arbre(1)) ;
tamiser(Arbre,1,i-1) ;
end loop ;
return Arbre ;
end tri_tas ;
Si vous avez dors et déjà testé les programmes ci-dessus sur de grands tableaux, vous avez du vous rendre compte que certains étaient plus rapides que d'autres, plus efficaces. C'est ce que l'on appelle l'efficacité d'un algorithme. Pour la mesurer, la quantifier, on s'intéresse davantage à son contraire, la complexité. En effet, pour mesurer la complexité d'un algorithme il "suffit" de mesurer la quantité de ressources qu'il exige (mémoire ou temps-processeur).
En effet, le simple fait de déclarer un tableau exige de réquisitionner des emplacements mémoires qui seront rendus inutilisables par d'autres programmes comme votre système d'exploitation. Tester l'égalité entre deux variables va nécessiter de réquisitionner temporairement le processeur, le rendant très brièvement inutilisable pour toute autre chose. Vous comprenez alors que parcourir un tableau de 10 000 cases en testant chacune des cases exigera donc de réquisitionner au moins 10 000 emplacements mémoires et d'interrompre 10 000 fois le processeur pour faire nos tests. Tout cela ralentit les performances de l'ordinateur et peut même, pour des algorithmes mal ficelés, saturer la mémoire entraînant l'erreur STORAGE_ERROR : EXCEPTION_STACK_OVERFLOW.
D'où l'intérêt de pouvoir comparer la complexité de différents algorithmes pour ne conserver que les plus efficaces, voire même de prédire cette complexité. Prenons par exemple l'algorithme dont nous parlions précédemment (qui lit un tableau et teste chacune de ses cases) : si le tableau a 100 cases, l'algorithme effectuera 100 tests ; si le tableau à 5000 cases, l'algorithme effectuera 5000 tests ; si le tableau a cases, l'algorithme effectuera tests ! On dit que sa complexité est en .
L'écriture O
Ca veut dire quoi ce zéro ?
Ce n'est pas un zéro mais la lettre O ! Et se lit "grand O de n". Cette notation mathématique signifie que la complexité de l'algorithme est proportionnelle à (le nombre d'éléments contenus dans le tableau). Autrement dit, la complexité vaut "grosso-modo" .
C'est pas "grosso modo égal à n" ! C'est exactement égal à n ! :colere2:
Prenons un autre exemple : un algorithme qui parcourt lui aussi un tableau à éléments. Pour chaque case, il effectue deux tests : le nombre est-il positif ? Le nombre est-il pair ? Combien va-t-il effectuer de tests ? La réponse est simple : deux fois plus que le premier algorithme, c'est à dire . Autrement dit, il est deux fois plus lent. Mais pour le mathématicien ou l'informaticien, ce facteur 2 n'a pas une importance aussi grande que cela, l'algorithme a toujours une complexité proportionnelle au premier, et donc en .
Mais alors tous les algorithmes ont une complexité en si c'est comme ça !
Non, bien sûr. Un facteur 2, 3, 20 ... peut être considéré comme négligeable. En fait, tout facteur constant peut être considéré comme négligeable. Reprenons encore notre algorithme : il parcourt toujours un tableau à éléments, mais à chaque case du tableau, il reparcourt tout le tableau depuis le début pour savoir s'il n'y aurait pas une autre case ayant la même valeur. Combien va-t-il faire de tests ? Pour chaque case, il doit faire tests et comme il y a cases, il devra faire en tout tests. Le facteur n'est cette fois pas constant ! On dira que cet algorithme a une complexité en et, vous vous en doutez, ce n'est pas terrible du tout. Et pourtant, c'est la complexité de certains de nos algorithmes de tris ! :-°
Donc, vous devez commencer à comprendre qu'il est préférable d'avoir une complexité en qu'en . Malheureusement pour nous, en règle général, il est impossible d'atteindre une complexité en pour un algorithme de tri (sauf cas particulier comme avec un tableau déjà trié, et encore ça dépend des algorithmes :( ). Un algorithme de tri aura une complexité optimale quand celle-ci sera en .
Quelques fonctions mathématiques
Qu'est-ce que c'est encore que cette notation ?
C'est une fonction mathématique que l'on appelle le logarithme népérien. Les logarithmes sont les fonctions mathématiques qui ont la croissance la plus faible (en fait elles croissent très très vite au début puis ralentissent par la suite). Inversement, les fonctions exponentielles sont celles qui ont la croissance la plus rapide (très très lentes au début puis de plus en plus rapide).
Mon but ici n'est pas de faire de vous des mathématiciens, encore moins d'expliquer en détail les notions de fonction ou de "grand O", mais pour que vous ayez une idée de ces différentes fonctions, de leur croissance et surtout des complexités associées, je vous en propose quelques-unes sur le graphique ci-dessous :
Légende : Complexité en (e : exponentielle) Complexité en Complexité en (log : logarithme) Complexité en Complexité en
Plus l'on va vers la droite, plus le nombre d'éléments à trier, tester, modifier ... augmente. Plus l'on va vers le haut, plus le nombre d'opérations effectuées augmente et donc plus la quantité de mémoire ou le temps processeur nécessaire augmente. On voit ainsi qu'une complexité en ou , c'est peu ou prou pareil, serait parfaite (on parle de complexité logarithmique) : elle augmente beaucoup moins vite que le nombre d'éléments à trier ! Le rêve. Sauf que ça n'existe pas pour nos algorithmes de tri, donc oubliez-la.
Une complexité en serait donc idéale (on parle de complexité linéaire). C'est possible dans des cas très particuliers : par exemple l'algorithme de tri par insertion peut atteindre une complexité en O(n) lorsque le tableau est déjà trié ou "presque" trié, alors que les algorithmes de tri rapide ou fusion n'en sont pas capables. Mais dans la vie courante, il est rare que l'on demande de trier des tableaux déjà triés. :o
On comprend donc qu'atteindre une complexité en est déjà satisfaisant (on parle de complexité linéarithmique), on dit alors que la complexité est asymptotiquement optimale, bref, on ne peut pas vraiment faire mieux dans la majorité des cas.
Une complexité en , dite complexité quadratique, est courante pour des algorithmes de tri simples (voire simplistes), mais très mauvaise. Si au départ elle ne diffère pas beaucoup d'une complexité linéaire (en ), elle finit par augmenter très vite à mesure que le nombre d'éléments à trier augmente. Donc les algorithmes de tri de complexité quadratique seront réservés pour de petits tableaux.
Enfin, la complexité exponentielle (en ) est la pire chose qui puisse vous arriver. La complexité augmente à vite grand V, de façon exponentielle (logique me direz-vous). N'ajoutez qu'un seul élément et vous aurez beaucoup plus d'opérations à effectuer. Pour un algorithme de tri, c'est le signe que vous coder comme un cochon. :p Attention, les jugements émis ici ne concernent que les algorithmes de tri. Pour certains problèmes, vous serez heureux d'avoir une complexité en seulement .
Un algorithme pour mesurer la complexité ... des algorithmes
Après cette section très théorique, retournons à la pratique. Nous allons rédiger un programme qui va mesurer le temps d'exécution des différents algorithmes avec des tableaux de plus en plus grands. Ces temps seront enregistrés dans un fichier texte de manière à pouvoir ensuite transférer les résultats dans un tableur (Calc ou Excel par exemple) et dresser un graphique. Nous en déduirons ainsi, de manière empirique, la complexité des différents algorithmes. Pour ce faire, nous allons de nouveau faire appel au package Ada.Calendar et effectuer toute une batterie de tests à répétition avec nos divers algorithmes. Le principe du programme sera le suivant :
POUR i ALLANT DE 1 A 100 REPETER
| Créer Tableau Aléatoire de taille i*100
| Mesurer Tri_Selection(Tableau)
| Mesurer Tri_Insertion(Tableau)
| Mesurer Tri_Bulles(Tableau)
| Mesurer Tri_Rapide(Tableau)
| Mesurer Tri_Fusion(Tableau)
| Mesurer Tri_Tas(Tableau)
| Afficher "Tests effectués pour taille" i*100
| incrémenter i
FIN BOUCLE
La boucle devrait effectuer 100 tests, ce qui sera largement suffisant pour nos graphiques. Nous ne dépasserons pas des tableaux de taille 10 000 (les algorithmes lents devraient déjà mettre de 1 à 4 secondes pour effectuer leur tri), car au-delà, vous pourriez vous lassez. Par exemple, il m'a fallu 200s pour trier un tableau de taille 100 000 avec le tri par insertion et 743s avec le tri à bulles alors qu'il ne faut même pas une demi-seconde aux algorithmes rapides pour faire ce travail. Si vous le souhaitez, vous pourrez reprendre ce principe avec des tableaux plus importants pour les algorithmes plus rapides (vous pouvez facilement aller jusqu'à des tableaux de taille 1 million).
Mais que vont faire ces procédures Mesurer ?
C'est simple, elles doivent :
ouvrir un fichier texte ;
lire "l'heure" ;
exécuter l'algorithme de tri correspondant ;
lire à nouveau "l'heure" pour en déduire la durée d'exécution ;
enregistrer la durée obtenue dans le fichier ;
fermer le fichier ;
Cela impliquera de créer un type de pointeur sur les fonctions de tri. Voici le code source du programme :
procedure sort is
type T_Ptr_Fonction is access function(T : Vecteur) return Vecteur ;
type T_Tri is (SELECTION, INSERTION, BULLES, FUSION, RAPIDE, TAS) ;
procedure mesurer(tri : T_Ptr_Fonction; T : Vecteur; choix : T_Tri) is
temps : time ;
duree : duration ;
U :Vecteur(T'range) ;
F : File_Type ;
begin
case choix is
when SELECTION => open(F,Append_file,"./mesures/selection.txt") ;
when INSERTION => open(F,Append_file,"./mesures/insertion.txt") ;
when BULLES => open(F,Append_file,"./mesures/bulles.txt") ;
when FUSION => open(F,Append_file,"./mesures/fusion.txt") ;
when RAPIDE => open(F,Append_file,"./mesures/rapide.txt") ;
when TAS => open(F,Append_file,"./mesures/tas.txt") ;
end case ;
temps := clock ;
U := Tri(T) ;
duree := clock - temps ;
put(F,float(duree),Exp=>0) ;
new_line(F) ;
close(F) ;
end mesurer ;
tri : T_Ptr_Fonction ;
F : File_Type ;
begin
create(F,Append_file,"./mesures/selection.txt") ; close(F) ;
create(F,Append_file,"./mesures/insertion.txt") ; close(F) ;
create(F,Append_file,"./mesures/bulles.txt") ; close(F) ;
create(F,Append_file,"./mesures/fusion.txt") ; close(F) ;
create(F,Append_file,"./mesures/rapide.txt") ; close(F) ;
create(F,Append_file,"./mesures/tas.txt") ; close(F) ;
for i in 1..100 loop
declare
T : Vecteur(1..i*100) ;
begin
generate(T,0,i*50) ;
tri := Tri_select'access ;
mesurer(tri,T,SELECTION) ;
tri := Tri_insertion'access ;
mesurer(tri,T,INSERTION) ;
tri := Tri_bulles'access ;
mesurer(tri,T,BULLES) ;
tri := Tri_fusion'access ;
mesurer(tri,T,FUSION) ;
tri := Tri_rapide'access ;
mesurer(tri,T,RAPIDE) ;
tri := Tri_tas'access ;
mesurer(tri,T,TAS) ;
end ;
put("Tests effectues pour la taille ") ; put(i*100) ; new_line;
end loop ;
end sort ;
Traiter nos résultats
A l'aide du programme précédent, vous devez avoir obtenu six fichiers textes contenant chacun 100 valeurs décimales.
Et j'en fais quoi maintenant ? Je vais pas tout comparer à la main !
Bien sûr que non. Ouvrez donc un tableur (tel Excel ou Calc d'OpenOffice) et copiez-y les résultats obtenus. Sélectionnez les valeurs obtenues puis cliquez sur Insertion>Diagramme afin d'obtenir une représentation graphique des résultats obtenus. Je vous présente ci-dessous les résultats obtenus avec mon vieux PC :
Avant même de comparer les performances de nos algorithmes, on peut remarquer une certaine irrégularité : des pics et des creux apparaissent et semblent (en général) avoir lieu pour tous les algorithmes. Ces pics et ces creux correspondent aux pires et aux meilleurs cas possibles. En effet, si notre programme de génération aléatoire de tableaux vient à créer un tableau quasi-trié, alors le temps mis par certains algorithmes chutera drastiquement. Inversement, certaines configurations peuvent être réellement problématiques à certains algorithmes : prenez un tableau quasi-trié mais dans le mauvais ordre ! Ce genre de tableau est catastrophique pour un algorithme de tri à bulles qui devra effectuer un nombre de passages excessif : il suffit, pour s'en convaincre, de regarder le dernier pic de la courbe jaune ci-dessus (tri à bulles) ; d'ailleurs ce pic est nettement atténué sur la courbe orange (tri par insertion) et quasi inexistant sur la courbe bleu (tri par sélection).
Qui plus est, il apparaît assez nettement que le temps de traitement des algorithmes rapides (tri rapide, tri fusion et tri par tas) est quasiment négligeable par rapport à celui des algorithmes lents (tri par insertion, tri par sélection et tri à bulles), au point que seuls ces derniers apparaissent sur le graphique.
Pour y voir plus clair, je vous propose de traiter nos chiffres avec un peu plus de finesse : nous allons distinguer les algorithmes lents des algorithmes rapides et nous allons lisser nos résultats. Par lisser, j'entends modifier nos résultats pour ne plus être gênés par ces pics et ces creux et voir apparaître une courbe plus agréable représentant la tendance de fond.
Lissage des résultats par moyenne mobile : Pour ceux qui se demanderaient ce qu'est ce lissage par moyenne mobile, voici une explication succincte (ce n'est pas un cours de statistiques non plus). Au lieu de traiter nos 100 nombres, nous allons créer une nouvelle liste de valeurs. La première valeur est obtenue en calculant la moyenne des 20 premiers nombres (du 1er au 20ème), la seconde est obtenu en calculant la moyenne des nombres entre le 2nd et le 21ème, la troisième valeur est obtenue en calculant la moyenne des nombres entre le 3ème et le 22ème ... La nouvelle liste de valeurs est ainsi plus homogène mais aussi plus courte (il manquera 20 valeurs).
Algorithmes lents
Algorithmes rapides
Ainsi retravaillés, nos résultats sont plus lisibles et on voit apparaître qu'en moyenne, l'algorithme le plus efficace est le tri rapide, puis viennent le tri par tas et le tri fusion. Mais même le tri fusion reste, en moyenne, en dessous de 0,025 seconde pour un tableau à 10 000 éléments sur mon vieil ordinateur (son score est sûrement encore meilleur chez vous), ce qui est très très loin des performances des trois autres algorithmes. Pour les trois plus lents, on remarque que le "pire" d'entre eux est, en moyenne, le tri à bulles, puis viennent le tri par insertion et le tri par sélection (avec des écarts de performance toutefois très nets entre eux trois).
Le lissage par moyenne mobile nous permet également de voir se dégager une tendance, une courbe théorique débarrassées des impuretés (pire cas et meilleur cas). Si l'on considère les algorithmes lents, on distingue un début de courbe en U, même si le U semble très écrasé par l'algorithme de tri par sélection. Cela nous fait donc penser à une complexité en où n est le nombre d'éléments du tableau.
Et pourquoi pas en ?
Prenez un tableau à éléments que l'on voudrait trier avec le pire algorithme : le tri à bulles. Dans le pire des cas, le tableau est trié en sens inverse et le plus petit élément est donc situé à la fin. Et comme le tri à bulle ne déplace le plus petit élément que d'un seul cran à chaque passage, il faudra donc effectuer passages pour que ce minimum soit à sa place et le tableau trié. De plus, à chaque itération, l'algorithme doit effectuer comparaison (et au plus échanges). D'où un total de comparaisons. Or, , donc la complexité est "de l'ordre de" . Dans le pire cas, l'algorithme de tri à bulles a une complexité en . Cette famille d'algorithme a donc une complexité quadratique et non exponentielle.
Considérons maintenant nos trois algorithmes rapides, leur temps d'exécution est parfaitement négligeable à côté des trois précédents, leurs courbes croissent peu : certaines semblent presque être des droites. Mais ne vous y trompez pas, leur complexité n'est sûrement pas linéaire, ce serait trop beau. Elle est toutefois linéarithmique c'est-à-dire en . Ces trois algorithmes sont donc asymptotiquement optimaux.
Par exemple, notre algorithme de tri fusion est un tri en place : nous n'avons pas créer de second tableau pour effectuer notre tri afin d'économiser la mémoire, denrée rare si l'on trie de très grands tableaux (plusieurs centaines de millions de cases). Une variante consiste à ne pas l'effectuer en place : on crée alors un second tableau et l'opération de fusion gagne en rapidité. Dans ce cas, l'algorithme de tri fusion acquièrent une complexité comparable à celle du tri fusion en réalisant moins de comparaisons, mais devient gourmande en mémoire.
De la même manière, nous avons évoqué le Combsort qui est une amélioration du tri à bulles et qui permet à notre "pire" algorithme de côtoyer les performances des "meilleurs". Encore un dernier exemple, le "lent" algorithme de tri par insertion atteint une complexité linéaire en sur des tableaux quasi-triés alors que l'algorithme de tri rapide garde sa complexité linéarithmique en .
Comme je vous l'avais dit en introduction, ce chapitre n'est pas fondamental à la compréhension du reste du cours sur le langage Ada. En revanche, il vous aura permis de vous interroger sur l'efficacité des algorithmes que vous rédigez. Programmer, ce n'est pas seulement parvenir à un résultat, c'est aussi faire en sorte que notre programme soit le moins gourmand en mémoire ou en temps processeur. Où en serions-nous dans le traitement du génome humain si nous n'avions utilisé que des algorithmes bourrins ? J'espère également que ce chapitre vous aura fait prendre conscience de l'importance des Mathématiques en Informatique et notamment que l'Algorithmique en constitue une branche à part entière.
Le chapitre que nous allons aborder est très théorique et traite de diverses notions ayant trait à la mémoire de l'ordinateur : comment est-elle gérée ? Comment les informations y sont-elles représentées ? ... Nous allons passer le plus clair du chapitre à ne pas parler de programmation (étrange me direz-vous pour un cours de programmation :D ) mais ce n'est que pour mieux revenir sur les types Integer, Character et Float, sur de nouveaux types (Long_Long_Float, Long_Long_Integer... ) ou sur certaines erreurs vues au fil du cours.
Chaque partie de ce chapitre abordera la manière dont l'ordinateur représente les nombres entiers, décimaux ou les caractères en mémoire. Ce sera l'occasion de parler binaire, hexadécimal, virgule flottante ... avant de soulever certains problèmes liés à ces représentations et d'en déduire quelques bonnes pratiques.
Nous allons essayer au cours des parties suivantes de comprendre comment l'ordinateur s'y prend pour représenter les nombres entiers, les caractères ou les nombres décimaux, car cela a des implications sur la façon de programmer. En effet, depuis le début, nous faisons comme s'il était normal que l'ordinateur sache compter de - 2 147 483 648 à 2 147 483 647, or je vous rappelle qu'un ordinateur n'est jamais qu'un amas de métaux et de silicone. Alors comment peut-il compter ? Et pourquoi ne peut-il pas compter au-delà de 2 147 483 647 ? Que se passe-t-il si l'on va au-delà ? Comment aller au delà ? Reprenons tout à la base.
Tout d'abord, un ordinateur fonctionne à l'électricité (jusque là rien de révolutionnaire) et qu'avec cette électricité nous avons deux états possibles : éteint ou allumé.
Eh ! Tu me prends pour un idiot ou quoi ? :colere2:
Bien sûr que non, mais c'est grâce à ces deux états de l'électricité que les Humains ont pu créer des machines aussi perfectionnées capables d'envoyer des vidéos à l'autre bout du monde. En effet, à chaque état peut-être associé un nombre :
0
1
Lorsque le courant passe, cela équivaut au chiffre 1, lorsqu'il ne passe pas, ce chiffre est 0. De même lorsqu'un accumulateur est chargé, cela signifie qu'un 1 est en mémoire, s'il est déchargé, le chiffre 0 est enregistré en mémoire. Nos ordinateurs ne disposent donc que de deux chiffres 0 et 1. Nous comptons quant à nous avec 10 chiffres (0, 1, 2 ... 8, 9) : on dit que nous comptons en base 10 ou décimale. Les ordinateurs comptent donc en base 2, aussi appelé binaire. Les chiffres 1 et 0 sont appelés bits, pour binary digits c'est à dire chiffre binaire.
Mais, comment faire un 2 ou un 3 ? o_O
Il faut procéder en binaire comme nous le faisons en base 10 : lorsque l'on compte jusqu'à 9 et que l'on a épuisé tous nos chiffres, que fait-on ? On remet le chiffre des unités à 0 et on augmente la dizaine. Eh bien c'est pareil pour le binaire : après 0 et 1, nous aurons donc 10 puis 11. On peut ensuite ajouter une "centaine" et recommencer. Voici une liste des premiers nombres en binaire :
Décimal
Binaire
0
0000
1
0001
2
0010
3
0011
4
0100
5
0101
6
0110
7
0111
8
1000
9
1001
10
1010
Conversions entre décimal et binaire
Vous aurez remarqué les répétitions : pour les bits des "unités" on écrit un 0 puis un 1, puis un 0 ... pour les bits des "dizaines" on écrit deux 0 puis deux 1, puis deux 0 ... pour les bits des "centaines", on écrit quatre 0, puis quatre 1, puis quatre 0 ... et ainsi de suite. Mais il y a une ombre au tableau. Nous n'allons pas faire un tableau allant jusqu'à 2 147 483 647 pour pouvoir le convertir en binaire ! Nous devons trouver un moyen de convertir rapidement un nombre binaire en décimal et inversement.
Conversion binaire => décimal
Imaginons que nous recevions le signal suivant :
Ce message correspond au nombre binaire 10110 qui se décompose en 0 "unités", 1 "dizaine", 1 "centaine", 0 "millier" et 1 "dizaine de millier". Ce qui s'écrirait normalement :
Sauf qu'en binaire, on ne compte pas avec dix chiffres mais avec seulement deux ! Il n'y a pas de "dizaines" ou de "centaines". Donc en binaire notre nombre correspond en fait à :
Ainsi, il suffit donc d'effectuer ce calcul pour trouver la valeur en base 10 de 10110 et de connaître les puissances de deux :
Autre méthode pour effectuer la conversion, il suffit de dresser le tableau ci-dessous. Dans la première ligne, on écrit les puissances de 2 : 1, 2, 4, 8, 16 ... Dans la seconde ligne on écrit les bits :
16
8
4
2
1
1
0
1
1
0
Il y va ainsi une fois 2, plus une fois 4 plus une fois 16 (et 0 fois pour le reste), d'où 22 !
Conversion décimal => binaire
Imaginons, cette fois que nous souhaitions envoyer en message le nombre 13. Pour cela, nous allons dresser le même tableau que précédemment :
8
4
2
1
-
-
-
-
Et posons-nous la question : dans 13 combien de fois 8 ? Une fois bien-sûr ! Et il reste 5. D'où le tableau :
8
4
2
1
1
-
-
-
Maintenant, recommençons ! Dans 5 combien de fois 4 ? Une fois et il reste 1 !
8
4
2
1
1
1
-
-
Dans 1 combien de fois 2. Zéro fois, logique. Et dans 1 combien de fois 1 : 1 fois.
8
4
2
1
1
1
0
1
Donc le nombre 13 s'écrit 1101 en binaire. Le tour est joué.
Retour sur le langage Ada
Représentation des Integer en Ada
Vous avez compris le principe ? Si la réponse est encore non, je vous conseille de vous entraîner à faire diverses conversions avant d'attaquer la suite, car nous n'en sommes qu'au B-A-BA. En effet, les ordinateurs n'enregistre pas les informations bits par bits, mais plutôt par paquets. Ces paquets sont appelés octets, c'est à dire des paquets de 8 bits (même s'il est possible de faire des paquets de 2, 4 ou 9 bits).
Pour enregistrer un Integer, le langage Ada utilise non pas un seul mais quatre octets, c'est à dire bits ! Avec un seul bit, on peut coder deux nombres (0 et 1), avec deux bits on peut coder quatre nombres (0, 1, 2, 3), avec trois bits on peut coder huit nombres ... avec 32 bits, on peut ainsi coder nombres, soit 4 294 967 296 nombres.
Mais la difficulté ne s'arrête pas là. En effet, le plus grand Integer n'est pas 4 294 967 296, mais 2 147 483 647 (c'est à dire presque la moitié). Pourquoi ? Tout simplement parce qu'il faut partager ces 4 294 967 296 nombres en deux : les positifs et les négatifs. Comment les distinguer ?
La réponse est simple : tous les Integer commençant par un 0 seront positifs (exemple : 00101001 10011101 10100011 11111001) ; tous les integer commençant par un 1 seront négatifs (exemple : 10101001 10011101 10100011 11111001). Ce premier bit est appelé bit de poids fort. Facile hein ? Eh bien non ! :colere2: Car il y a encore un problème : on se retrouve avec deux zéros !
C'est dommage et cela complique les opérations d'un point de vue électronique. Du coup, il faut décaler les nombres négatifs d'un cran : le nombre 10000000 00000000 00000000 00000000 correspondra non pas à mais à . Le premier 1 signifie que le nombre est négatif, les 31 zéros, si on les convertit en base 10, devraient donner 0, mais avec ce décalage, on doit ajouter 1, ce qui nous donne - 1 !
Conséquence immédiate : l'Overflow et les types long
OUF ! :waw: C'est un peu compliqué tout ça ... Et ça sert à quoi ?
Patience, je vous entraîne peu à peu dans les méandres de l'informatique afin de mieux revenir sur notre sujet : le langage Ada et la programmation. Cette façon de coder les nombres entiers, qui n'est pas spécifique au seul langage Ada, a deux conséquences. Tout d'abord le plus grand Integer positif est 2 147 483 647 (), quand le plus petit Integer négatif est - 2 147 483 648 () : il y a un décalage de 1 puisque 0 est codé comme un positif et pas comme un négatif par la machine.
Deuxième conséquence, nous n'avons que nombres à notre disposition, dont le plus grand est seulement . C'est très largement suffisant en temps normal, mais pour des calculs plus importants, cela peut s'avérer un peu juste (souvenez-vous seulement des calculs de factorielles). En effet, si vous dépassez ce maximum, que se passera-t-il ? Eh bien plusieurs possibilités. Soient vous y allez façon "déménageur" en rédigeant un code faisant clairement appel à des nombres trop importants :
n : = 2**525 ;
p := Integer'last + 1 ;
Et alors, le compilateur vous arrêtera tout de suite par un doux message : value not in range of type "Standard.Integer". Ou bien vous y allez de façon "masquée" ( :zorro: ), le compilateur ne détectant rien (une boucle itérative ou récursive, un affichage du type Put(Integer'last+1);). Vos nombres devenant trop grands, ils ne peuvent plus être codés sur seulement quatre octets, il y a ce que l'on appelle un dépassement de capacité (aussi appelé overflow [j'adore ce mot :ange: ]). Vous vous exposez alors à deux types d'erreurs : soit votre programme plante en affichant une jolie erreur du type
Soit il ne détecte pas l'erreur (c'est ce qui est arrivé avec notre programme de calcul de factorielles) : le nombre positif devient trop grand, il "déborde" sur le bit de poids fort normalement réservé au signe, ce qui explique que nos factorielles devenaient étrangement négatives.
Comment remédier à ce problème si l'on souhaite par exemple connaître la factorielle de 25 ?
Eh bien le langage Ada a tout prévu. Si les Integer ne suffisent plus, il est possible d'utiliser d'autres types : Long_Integer (avec le package Ada.Long_Integer_Text_IO) et Long_Long_Integer (avec le package Ada.Long_Long_Integer_Text_IO). Les Long_Integer sont codés sur 4 octets soit 32 bits comme les Integer. Pourquoi ? Eh bien cela dépend de vos distributions en fait. Sur certaines plateformes, les Integer ne sont codés que sur 16 bits soit 2 octets d'où la nécessité de faire appel aux Long_Integer. Pour augmenter vos capacités de calcul, utilisez donc plutôt les Long_Long_Integer qui sont codés sur 8 octets soit 64 bits. Ils s'étendent donc de +9 223 372 036 854 775 807 à -9 223 372 036 854 775 808, ce qui nous fait fois plus de nombres que les Long_Integer.
Utiliser les bases
En Ada, il est possible de travailler non plus avec des nombres entiers en base 10 mais avec des nombres binaires ou des nombres en base 3, 5, 8, 16 ...On parlera d'Octal pour la base 8 et d'hexadécimal pour la base 16 (bases très utilisées en Informatique). Par exemple, nous savons que le nombre binaire 101 correspond au nombre 5. Pour cela, nous écrirons :
N : Integer ;
BEGIN
N := 2#101# ;
Put(N) ;
Le premier nombre (2) correspond à la base. Le second (101) correspond au nombre en lui-même exprimé dans la base indiquée : Attention ! En base 2, les chiffres ne doivent pas dépasser 1. Chacun de ces nombres doit être suivi d'un dièse (#). Le souci, c'est que ce programme affichera ceci :
5
Il faudra donc modifier notre code pour spécifier la base voulue : Put(N,Base => 2) ; ou Put(N,5,2) ; (le 5 correspondant au nombre de chiffres que l'on souhaite afficher). Votre programme affichera alors votre nombre en base 2.
Il sera possible d'écrire également :
N := 8#27# --correspond au nombre 7+ 8*2 = 23
N := 16#B# --en hexadécimal, A correspond à 10 et B à 11
Il est même possible d'écrire un exposant à la suite de notre nombre :
N := 2#101#E3 ;
Notre variable N est donc donnée en base 2, elle vaut donc 101 en binaire, soit 5. Mais l'exposant E3 signifie que l'on doit multiplier 5 par . La variable N vaut donc en réalité 40. Ou, autre façon de voir la chose : notre variable N ne vaut pas 101 (en binaire bien sûr) mais 101000 (il faut en réalité ajouter 3 zéros).
Imposer la taille
Imaginez que vous souhaitiez réaliser un programme manipulant des octets. Vous créez un type modulaire T_Octet de la manière suivante :
Type T_Octet is mod 2**8 ;
Vous aurez ainsi des nombres allant de 0000 0000 jusqu'à 1111 1111. Sauf que pour les enregistrer, votre programme va tout de même réquisitionner 4 octets. Du coup, l'octet 0100 1000 sera enregsitré ainsi en mémoire : 00000000 00000000 0000000001001000. Ce qui nous fait une perte de trois octets. Minime me direz-vous. Sauf que si l'on vient à créer des tableaux d'un million de cases de types T_Octets, pour créer un nouveau format de fichier image par exemple, nous perdrons pour rien. Il est donc judicieux d'imposer certaines contraintes en utilisant l'attribut 'Size de la sorte :
Type T_Octet is mod 2**8 ;
For T_Octet'size use 8 ;
Ainsi, nos variables de type T_Octet, ne prendront réellement que 1 octet en mémoire.
Avant de nous attaquer à la représentation des décimaux et donc des Float, qui est particulièrement complexe, voyons rapidement celle du texte. Vous savez qu'un String n'est rien de plus qu'un tableau de characters et qu'un Unbounded_String est en fait une liste de Characters. Mais comment sont représentés ces characters en mémoire ? Eh bien c'est très simple, l'ordinateur n'enregistre pas des lettres mais des nombres.
Hein ? Et comment il retrouve les lettres alors ?
Grâce à une table de conversion. L'exemple le plus connu est ce que l'on appelle la table ASCII (American Standard Code for Information Interchange). Il s'agit d'une table de correspondance entre des characters et le numéro qui leur est attribué. Cette vieille table (elle date de 1961) est certainement la plus connue et la plus utilisée. La voici en détail :
Comme vous pouvez le voir, cette table contient 128 caractères allant de 'A' à 'z' en passant par '7', '#' ou des caractères non imprimables comme la touche de suppression ou le retour à la ligne. Vous pouvez dors et déjà constater que seuls les caractères anglo-saxons sont présents dans cette table (pas de 'ö' ou de 'è') ce qui est contraignant pour nous Français. De plus, cette table ne comporte que 128 caractères, soit , Chaque caractère ne nécessite donc que 7 bits pour être codé en mémoire, même pas un octet ! Heureusement, cette célèbre table s'est bien développée depuis 1961, donnant naissance à de nombreuses autres tables. Le langage Ada n'utilise donc pas la table ASCII classique mais une sorte de table ASCII modifiée et étendue. En utilisant le 8ème bit, cette table permet d'ajouter 128 nouveaux caractères et donc de bénéficier de caractères en tout.
Donc tu nous mens depuis le début ! Il est possible d'utiliser le 'é' ! :colere:
Non, je ne vous ai pas menti et vous ne pouvez pas tout à fait utiliser les caractères accentués comme les autres. Ainsi si vous écrivez ceci :
...
C : Character
BEGIN
C := 'ê' ; Put(C) ;
...
Vous aurez droit à ce genre d'horreur :
Û
Vous devrez donc écrire les lignes ci-dessous si vous souhaitez obtenir un e minuscule avec un accent circonflexe :
...
C : Character
BEGIN
C := Character'val(136) ; Put(C) ;
...
Enfin, dernière remarque, les caractères imprimés dans la console ne correspondent pas toujours à ceux imprimés dans un fichier texte. Ainsi du caractère N°230 : il vaut 'æ' dans un fichier texte mais 'µ' dans la console. Je vous fournis ci-dessous la liste des caractères tels qu'ils apparaissent dans un fichier texte :
Vous remarquerez les ressemblances avec la table ASCII, mais aussi les différences quant aux caractères spéciaux. Le character n°12 correspond au saut de page et le n°9 à la tabulation.
Nous arrivons enfin à la partie la plus complexe. S'il vous paraît encore compliqué de passer du binaire au décimal avec les nombres entiers, je vous conseille de relire la sous-partie concernée avant d'attaquer celle-ci car la représentation des float est un peu tirée par les cheveux. Et vous devrez avoir une notion des puissances de 10 pour comprendre ce qui suit (je ne ferai pas de rappels, il ne s'agit pas d'un cours de Mathématiques).
Représentation des float
Représentation en base 10
Avant toute chose, nous allons voir comment écrire différemment le nombre dans notre base 10. Une convention, appelée écriture scientifique, consiste à n'écrire qu'un seul chiffre, différent de 0, avant la virgule : . Mais pour compenser cette modification, il faut multiplier l résultat obtenu par 1000 pour indiquer qu'en réalité il faut décaler la virgule de trois chiffres vers la droite. Ainsi, s'écrira ou même .
Eh ! o_O Ça me rappelle les écritures bizarres qu'on obtient quand on utilise Put( ) avec des float !
Eh oui, par défaut, c'est ainsi que sont représentés les nombres décimaux par l'ordinateur, le E3 signifiant . Il suffit donc simplement de modifier l'exposant (le 3) pour décaler la virgule vers la gauche ou la droite : on parle ainsi de virgule flottante.
Représentation en binaire
Cette écriture en virgule flottante prend tout son sens en binaire : pour enregistrer le nombre il faudra enregistrer en réalité le nombre . Mais comme le chiffre avant la virgule ne peut pas être égale à 0, ce ne peut être qu'un 1 en binaire ! Autrement dit, il faudra enregistrer trois nombres :
le signe : 1 (le nombre est négatif)
l'exposant : 11 (pour E3, rappelons que 3 s'écrit 11 en binaire)
la mantisse : 0011 (on ne conserve pas le 1 avant la virgule, c'est inutile)
D'où une écriture en mémoire qui ressemblerait à cela :
Signe
Exposant
Mantisse
1
11
0011
Pourquoi ne pas avoir enregistré seulement deux nombres ? La partie entière et la partie décimale ?
En simple précision, les nombres à virgule flottante sont représentés sur 4 octets. Comment se répartissent les différents bits ? C'est simple :
D'abord 1 bit pour le signe,
puis 8 bits pour l'exposant,
enfin le reste (soit 23 bits) pour la mantisse.
Sauf que l'exposant, nous venons de le voir peut être négatif et qu'il ne va pas être simple de gérer des exposants négatifs comme nous le faisions avec les Integer. Pas question d'avoir un bit pour le signe de l'exposant et 7 pour sa valeur absolue ! Le codage est un peu compliqué : on va décaler. L'exposant pourra aller de -127 à +128. Si l'exposant vaut 0000 0000, cela correspondra au plus petit des exposants : . Il y a un décalage de 127 par rapport à l'encodage normal des Integer.
Un exemple
Nous voulons convertir le nombre 6,75 en binaire et en virgule flottante. Tout d'abord, convertissons-le en binaire :
Donc notre nombre s'écrira 110,11. Passons en écriture avec virgule flottante : ou . Rappelons qu'il faut décaler notre exposant de 127 : . Et comme 129 s'écrit 10000001 en binaire, cela nous donnera :
Signe
Exposant
Mantisse
0
1000 0001
1011000 00000000 00000000
Cas particuliers
Ton raisonnement est bien gentil, mais le nombre 0 n'a aucun chiffre différent de 0 avant la virgule !
En effet, ce raisonnement n'est valable que pour des nombres dont l'exposant n'est ni 0000 0000 ni 1111 1111, c'est à dire si les nombres sont normalisés. Dans le cas contraire, on associe des valeurs particulières :
Exposant 0 Mantisse 0 : le résultat est 0.
Exposant 0 : on tombe dans le cas des nombres dénormalisés, c'est à dire dont le chiffre avant la virgule est 0 (nous n'entrerons pas davantage dans le détail pour ce cours)
Exposant 1111 1111 Mantisse 0 : le résultat est l'infini.
Exposant 1111 1111 : le résultat n'est pas un nombre (Not A Number : NaN).
Remarquez que du coup, pour les flottants, il est possible d'avoir et ! Bien. Vous connaissez maintenant les bases du codage des nombres flottants (pour plus de précisions, voir le tutoriel de Mewtow), il est grand temps de voir les implications que cela peut avoir en Ada.
Implications sur le langage Ada
De nouveaux types pour gagner en précision
Bien entendu, vous devez vous en doutez, il existe un type Short_Float (mais pas short_short_float), et il est possible de travailler avec des nombres à virgule flottante de plus grande précision à l'aide des types Long_Float (codé sur 8 octets au lieu de 4, c'est le format double précision) et Long_Long_Float (codé sur 16 octets). Vous serez alors amenés à utiliser les packages Ada.Short_Float_IO, Ada.Long_Float_IO et Ada.Long_Long_Float_IO (mais ai-je encore besoin de le spécifier ?).
Problèmes liés aux arrondis
Les nombres flottants posent toutefois quelques soucis techniques. En effet, prenons un nombre de type float. Il dispose de 23 bits pour coder sa mantisse, plus un "bit fantôme" puisque le chiffre avant la virgule n'a pas besoin d'être codé. Donc il est possible de coder un nombre de 24 chiffres, mais pas de 25 chiffres. Par exemple , en binaire, correspond à un nombre de 26 chiffres : le premier et le dernier vaudront 1, les autres 0. Essayons le code suivant :
...
x : Float ;
Begin
x := 2.0**25 ;
put(integer(x), base => 2) ; new_line ; --on affiche son écriture en binaire (c'est un entier)
put(x, exp => 0) ; new_line ; --et on affiche le nombre flottant
x := x + 1.0 ; --on incrémente
put(integer(x), base => 2) ; new_line ; --et rebelote pour l'affichage
put(x, exp => 0) ;
...
Que nous renvoie le programme ? Deux fois le même résultat ! o_O Etrange. Pourtant nous avons bien incrémenté notre variable x ! Je vous ai déjà donné la réponse dans le précédent paragraphe : le nombre de bits nécessaire pour enregistrer les chiffres (on parle de chiffres significatifs) est limité à 23 (24 en comptant le bit avant la virgule). Si nous dépassons ces capacités, il ne se produit pas de plantage comme avec les Integer, mais le processeur renvoie un résultat arrondi d'où une perte de précision.
De même, si vous testez le code ci-dessous, vous devriez avoir une drôle de surprise. Petite explication sur ce code : on effectue une boucle avec deux compteurs. L'un est un flottant que l'on augmente de 0.1 à chaque itération, l'autre est un integer que l'on incrémente. Nous devrions donc avoir 1001 itérations et à la fin, n vaudra 1001 et x vaudra 101.0. Logique non ? ;) Eh bien testez donc ce code.
...
x := 0.0 ;
n := 0 ;
while x < 100.0 loop
x := x + 0.1 ;
n := n + 1 ;
end loop ;
Put("x vaut ") ; put(x,exp=>0) ; new_line ;
Put_line("n vaut" & Integer'image(n)) ;
Alors, que vaut n ? 1001, tout va bien. Mais que vaut x ? 100.09904 !!! o_O Qu'a-t-il bien pu se passer encore ? Pour comprendre, il faut savoir que le nombre décimal 0.1 s'écrit approximativement 0.000 1100 1100 1100 1100 1100 en binaire ... Cette écriture est infinie, donc l'ordinateur doit effectuer un arrondi. Si la conversion d'un nombre entier en binaire tombe toujours juste, la conversion d'un nombre décimal quant à elle peut poser problème car l'écriture peut être potentiellement infinie. Et même chose lorsque l'on transforme le nombre binaire en nombre décimal, on ne retrouve pas 0.1 mais une valeur très proche ! Cela ne pose pas de véritable souci lorsque l'on se contente d'effectuer une addition. Mais lorsque l'on effectue de nombreuses additions, ce problème d'arrondi commence à se voir. La puissance des ordinateurs et la taille du type float (4 octets) est largement suffisante pour pallier dans la plupart des cas à ce problème d'arrondi en fournissant une précision bien supérieure à nos besoins, mais cela peut toutefois être problématique dans des cas où la précision est de mise.
Car si cette perte de précision peut paraître minime, elle peut parfois avoir de lourdes conséquences : imaginez que votre programme calcule la vitesse qu'une fusée doive adopter pour se poser sans encombre sur Mars en effectuant pour cela des milliers de boucles ou qu'il serve à la comptabilité d'une grande banque américaine gérant des millions d'opérations à la seconde. Une légère erreur d'arrondie qui viendrait à se répéter des milliers ou des millions de fois pourrait à terme engendrer la destruction de votre fusée ou une crise financière mondiale (comment ça ? Vous trouvez que j'exagère ? :D ).
Plus simplement, ces problèmes d'arrondis doivent vous amener à une conclusion : les types flottants ne doivent pas être utilisés à la légère ! Partout où les types entiers sont utilisables, préférez-les aux flottants (vous comprenez maintenant pourquoi depuis le début, je rechigne à utiliser le type Float). N'utilisez pas de flottant comme compteur dans une boucle car les problèmes d'arrondis pourraient bien vous jouer des tours. ^^
Delta et Digits
Toujours pour découvrir les limites du type float, testez le code ci-dessous :
...
x : float ;
begin
x:=12.3456789;
put(x,exp=>0) ;
...
Votre programme devrait afficher la valeur de x, or il n'affiche que :
12.34568
Eh oui, votre type float ne prend pas tous les chiffres ! Il peut manipuler de très grands ou de très petits nombres, mais ceux-ci ne doivent pas, en base 10, excéder 7 chiffres significatifs, sinon ... il arrondit ! Ce n'est pas très grave, mais cela constitue encore une fois une perte de précision. Alors certes vous pourriez utiliser le type Long_Float qui gère 16 chiffres significatifs, ou long_long_Float qui en gère 20 ! Mais il vous est également possible en Ada de définir votre propre type flottant ainsi que sa précision. Exemple :
type MyFloat is digits 9 ;
x : MyFloat :=12.3456789 ;
Le mot digits indiquera que ce type MyFloat gèrera au moins 9 chiffres significatifs ! Pourquoi "au moins" ? Eh bien parce qu'en créant ainsi un type Myfloat, nous créons un type de nombre flottant particulier utilisant un nombre d'octet particulier. Ici, notre type Myfloat sera codé dans votre ordinateur de sorte que sa mantisse utilise 53 bits. Ce type Myfloat pourra en fait gérer des nombres ayant jusqu'à 15 chiffres significatifs, mais pas au-delà.
Enfin, nous avons beaucoup parlé des nombres en virgule flottante, car c'est le format le plus utilisé pour représenter les nombres décimaux. Mais comme évoqué plus haut, il existe également des nombres en virgule fixe. L'idée est simple : le nombre de chiffres après la virgule est fixé dès le départ et ne bouge plus. Inconvénient : si vous avez fixé à 2 chiffres après la virgule, vous pourrez oubliez les calculs avec 0.00003 ! Mais ces nombres ont l'avantage de permettre des calculs plus rapides pour l'ordinateur. Vous en avez déjà rencontré : les types Duration ou Time sont des types à virgule fixe (et non flottante). Pour créer un type de nombre en virgule fixe vous procèderez ainsi :
type T_Prix is delta 0.01 ;
Prix_CD : T_Prix := 15.99 ;
Le mot clé delta indique l'écart minimal pouvant séparer deux nombres en virgule fixe (ici, notre prix de 15€99, s'il devait augmenter, passerait à €) et donc le nombre de chiffres après la virgule (2 pas plus).
Une précision toutefois : il est nécessaire de combiner delta avec digits ou range ! Exemple :
type T_Livret_A is delta 0.01 digits 6 ;
Toute variable de type T_Livret_A aura deux chiffres après la virgule et 6 chiffres en tout. Sa valeur maximale sera donc 9999.99. Une autre rédaction serait :
type T_Livret_A is delta 0.01 range 0.0 .. 9999.99 ;
Toutefois, gardez à l'esprit que malgré leurs limites (arrondis, overflow ...) les nombres en virgule flottante demeurent bien plus souples que les nombres en virgule fixe. Ces derniers ne seront utilisés que dans des cas précis (temps, argent ...) où le nombre de chiffres après la virgule est connu à l'avance.
Bien, c'est enfin la fin de ce chapitre si théorique. J'espère qu'il vous aura appris beaucoup sur le fonctionnement de l'ordinateur à défaut d'avoir beaucoup apporté de notions de programmation. J'y ferai plusieurs fois référence à l'occasion des prochains chapitres, donc ne négligez pas son importance et, au besoin, n'hésitez pas à effectuer plusieurs conversions binaire-décimal pour mieux maîtriser les notions abordées, notamment les risques d'erreurs liés aux différents types.
Avec ce chapitre nous allons entrer de plein pied dans la programmation orientée objet (souvent appelée par son doux acronyme de POO). L'objectif de ce chapitre est double :
expliquer ce que sont les notions de POO, de classes ...
fournir une première application de ce concept de POO en abordant l'encapsulation.
Cette notion de programmation orientée objet est une notion compliquée et nous allons prendre le temps d'aborder au travers de ce chapitre et des quatre suivants. Alors, prenez un grand bol d'air car avec la POO nous allons faire une longue plongée dans une nouvelle façon de programmer de d'utiliser nos packages, en commençant par l'encapsulation.
Au cours de la partie III, nous avons manipulé des types plus complexes : tableaux, pointeurs, types structurés ... nous nous sommes ainsi approché de cette notion d'objet en manipulant des types qui n'étaient déjà plus des variables. Mais il ne s'agissait pas encore de véritables objets.
Mais alors c'est quoi un objet ? Si c'est encore plus compliqué que les pointeurs et les types structurés j'abandonne ! :(
Vous vous souvenez de l'époque où nous avions réalisé notre TP sur le craps ? A la suite de cela, je vous avais dit qu'il aurait été plus judicieux que nos nombreuses variables soient toutes rassemblées en un seul et même contenant :
Avec nos connaissances actuelles, nous savons que ces différentes variables pourraient être rassemblées en un seul type structuré de la manière suivante :
type T_MainJoueur is record
de1, de2 : natural range 1..6 ;
hasard : generator ;
somme : natural range 2..12 ;
end record ;
Voire mieux encore, nous pourrions tout rassembler (le type T_MainJoueur, les variables, les fonctions et les procédures associées) dans un seul package appelé P_MainJoueur ! A la manière suivante :
Ainsi, nous aurions au sein d'un même paquetage à la fois les variables, les types et les programmes nécessaires à son utilisation (génération des dés, lecture de leur somme ...). Bref, aujourd'hui, vous ne procèderiez plus comme à l'époque où tout était en vrac dans le programme principal.
En effet, :D j'admets avoir fait d'énormes progrès en très peu de temps, en primaire déjà mes instits ... Eh ! Mais tu dérives là ! :colere: Tu ne réponds pas à ma question : C'EST QUOI UN OBJET ?!?
Un objet ? C'est justement cela : un type de donnée muni d'une structure comprenant l'ensemble des outils nécessaires à la représentation d'un objet réel ou d'une notion. Vous ne devez plus voir vos packages simplement comme une bibliothèque permettant de stocker "tout-et-n'importe-quoi-du-moment-que-ça-ne-me-gène-plus-dans-mon-programme-principal" mais plutôt comme une entité à part entière, porteuse d'un sens et d'une logique propre. Ainsi, notre package P_MainJoueur pour qu'il puisse être considéré comme un type d'objet devrait contenir tout ce qui concerne la main du joueur, ses dés, et les outils pour lire ou modifier cette main ... mais rien qui ne concerne son score !
Ainsi, concevoir un objet c'est non seulement concevoir un type particulier mais également tous les outils nécessaires à sa manipulation par un tiers utilisateur et une structure pour englober tout cela.
J'insiste sur le mot "nécessaire" ! Prenez par exemple un programmeur qui a conçu un type T_Fenetre avec tout plein de procédures et de fonctions pour faire une jolie fenêtre sous Windows, Linux ou Mac. Il souhaite faire partager son travail au plus grand nombre : il crée donc un package P_Fenetre qu'il va diffuser. Ce package P_Fenetre n'a pas besoin de contenir des types T_Image_3D, ce serait hors sujet. Mais l'utilisateur a-t-il besoin d'accéder aux procédures Creer_Barre_De_Titre, Creer_Bouton_Fermer, Creer_Bouton_Agrandir ... ? Non, il n'a besoin que d'une procedure Creer_Fenetre ! La plupart des petits programmes créés par le programmeur n'intéresseront pas l'utilisateur final : il faudra donc permettre l'accès pour l'utilisateur à certaines fonctionnalités, mais pas à toutes !
Posons le vocabulaire
Pour faire de la programmation orientée objet, il faut que nous établissions un vocabulaire précis. Le premier point à éclaircir est la différence entre les termes "classe" et "objet". La classe correspond à notre type (nous nuancerons cette assertion plus tard) : elle doit toutefois être munie d'un package dans lequel sont décrits le type et les fonctions et procédures pour le manipuler. A partir de ce "schéma", il est possible de créer plusieurs objets : on dit alors que l'on instancie des objets à partir d'une classe (de la même manière que l'on déclare des variables d'un certain type).
Autre point de vocabulaire, les procédures et fonctions issues d'une classe et s'appliquant à notre objet sont appelées méthodes. Pour mettre les choses au clair, reprenons l'exemple de notre jeu de craps en image :
Enfin, certaines catégories de méthodes portent un nom selon le rôle qu'elles jouent : constructeur pour initialiser les objets, destructeur pour les détruire proprement (en libérant la mémoire dynamique par exemple, nous reverrons cela dans le chapitre sur la finalisation), accesseur, modifieur pour lire ou modifier un attribut, itérateur pour appliquer une modification à une pile par exemple ...
De nouvelles contraintes
On attache à la Programmation Orientée Objet, non seulement la notion de classe englobant à la fois le type et les programmes associés, mais également divers principes comme :
L'encapsulation : c'est l'une des propriétés fondamentales de la POO. Les informations contenues dans l'objet ne doivent pas être "bidouillables" par l'utilisateur. Elles doivent être protégées et manipulées uniquement à l'aide des méthodes fournies par le package. Si l'on prend l'exemple d'une voiture : le constructeur de la voiture fait en sorte que le conducteur n'ait pas besoin d'être mécanicien pour l'utiliser. Il crée un volant, des sièges et des pédales pour éviter que le conducteur ne vienne mettre son nez dans le moteur (ce qui serait un risque). Nous avons commencé à voir cette notion avec la séparation des spécifications et du corps des packages et nous allons y ajouter la touche finale au cours de ce chapitre avec la privatisation.
La généricité : nous l'avons régulièrement évoquée au cours de ce tutoriel. Elle consiste à réaliser des packages applicables à divers types de données. Il en était ainsi pour les Doubly_Linked_Lists ou les Vectors qui pouvaient contenir des float, des integer ou des types personnalisés. Nous verrons cette notion plus en profondeur lors du prochain chapitre sur la programmation modulaire.
L'héritage : deuxième notion fondamentale de la conception orientée objet. Plus complexe, elle sera traitée après la généricité.
" :soleil: Ici c'est un club privé, on n'entre pas ! :soleil: "
Vous avez peut-être déjà entendu cette tirade ? Eh bien nous allons pouvoir nous venger aujourd'hui en faisant la même chose avec nos packages. :pirate: Bon certes, personne ne comptait vraiment venir danser avec nous devant le tuto ... Disons qu'il s'agit de rendre une partie de notre code "inaccessible". Petite explication : lorsque nous avons rédigé nos packages P_Pile et P_File, je vous avais bien précisé que nous voulions proposer à l'utilisateur ou au programmeur final toute une gamme d'outils qui lui permettraient de ne pas avoir à se soucier de la structure des types T_File et T_Pile. Ainsi, pour accéder au deuxième élément d'une pile, il lui suffit d'écrire :
...
n : integer ;
P : T_Pile
BEGIN
...
--création de la pile
pop(P,n) ;
put(first(P)) ;
La logique est simple : il dépile le premier élément puis affiche le premier élément de la sous-pile restante. Simple et efficace ! C'est d'ailleurs pour cela que nous avions créé toutes ces primitives. Mais en réalité, rien n'empêche notre programmeur d'écrire :
...
P : T_Pile
BEGIN
...
--création de la pile
put(P.suivant.valeur) ;
Et là c'est plutôt embêtant non ? Car nous avons rédigé des procédures et des fonctions justement dans le but qu'il ne puisse pas utiliser l'écriture avec pointeurs. Cette écriture présente des risques, nous le savons et avons pu le constater en testant nos packages P_Pile et P_File ! Alors il est hors de question que nous ayons fait tous ces efforts pour fournir un code sûr et qu'un olibrius s'amuse finalement à "détourner" notre travail. Si cela n'a pas de grande incidence à notre échelle, cela peut poser des problèmes de stabilité et de sécurité du code dans de plus grands projets nécessitant la coopération de nombreuses personnes.
Bah oui mais on ne peut pas empêcher les gens de faire n'importe quoi ? :-°
Eh bien si, justement ! La solution consiste à rendre la structure de nos types T_Pile, T_File et T_Cellule illisible en dehors de leurs propres packages. Actuellement, n'importe qui peut la manipuler à sa guise simplement en faisant appel au bon package. On dit que nos types sont publics. Par défaut, tout type, variable, sous-programme ... déclaré dans un package est public.
Pour restreindre l'accès à un type, une variable ... il faut donc le déclarer comme privé (private en Ada). Pour réaliser cela, vous allez devoir changer votre façon de voir vos packages ou tout du moins les spécifications. Vous lez voyiez jusqu'alors comme une sorte de grande boîte où l'on stockait tout et n'importe quoi, n'importe comment. Vous allez devoir apprendre que cette grande boîte est en fait compartimentée :
AVANT
MAINTENANT
Package P_Pile is
Vos fonctions, procédures, types, variables ...
end P_Pile ;
Package P_Pile is
Vos fonctions, procédures, types, variables ... publics
private
Vos fonctions, procédures, types, variables ... privés
end P_Pile ;
Comme l'indique le schéma ci-dessus, le premier compartiment, celui que vous utilisiez, correspond à la partie publique du package. Il est introduit par le mot is. Le second compartiment correspond à la partie privée et est introduit par le mot private, mais comme cette partie était jusqu'alors vide, nous n'avions pas à la renseigner. Reprenons le code du fichier P_Pile.ads pour lui ajouter une partie privée :
PACKAGE P_Pile IS
-- PARTIE PUBLIQUE : NOS PRIMITIVES
PROCEDURE Push (P : IN OUT T_Pile; N : IN Integer) ;
PROCEDURE Pop (P : IN OUT T_Pile ; N : OUT Integer) ;
FUNCTION Empty (P : IN T_Pile) RETURN Boolean ;
FUNCTION Length(P : T_Pile) RETURN Integer ;
FUNCTION First(P : T_Pile) RETURN Integer ;
PRIVATE
-- PARTE PRIVÉE : NOS TYPES
TYPE T_Cellule;
TYPE T_Pile IS ACCESS ALL T_Cellule;
TYPE T_Cellule IS
RECORD
Valeur : Integer;
Index : Integer;
Suivant : T_Pile;
END RECORD;
END P_Pile;
Les utilisateurs doivent garder l'accès aux primitives, elles ont été faites pour eux tout de même. En revanche, ils n'ont pas à avoir accès à la structure de nos types, donc nous les rendons privés. Et voilà ! Le tour est joué ! Pas besoin de modifier le corps de notre package, tout se fait dans les spécifications.
Visibilité
Mais ça marche pas tes affaires ! o_O A la compilation, GNAT m'indique "T_Pile" is undefined (more references follow)
Ah oui ... c'est embêtant. :( Cela m'amène à vous parler de la visibilité du code. Lorsque vous créez un programme faisant appel à P_Pile (avec l'instruction WITH P_Pile ;), ce programme n'a pas accès à l'intégralité du package ! Il aura simplement accès aux spécifications et, plus précisément encore, aux spécifications publiques ! Toute la partie privée et le corps du package demeurent invisibles, comme l'indique le schéma ci-dessous :
Une flèche indique qu'une partie "a accès à" ce qui est écrit dans une autre
On voit ainsi que seul le corps du package sait comment est constituée la partie privée puisqu'il a pleine visibilité sur l'ensemble du fichier ads. Donc seul le body peut manipuler librement ce qui est dans la partie private.
Comment peut-on alors créer un type T_Pile si ce type est invisible ?
L'utilisateur doit pouvoir voir ce type sans pour autant pouvoir le lire. "Voir notre type" signifie que l'utilisateur peut déclarer des objets de type T_Pile et utiliser des programmes utilisant eux-même ce type. En revanche, il ne doit pas en connaître la structure, il ne doit donc pas pouvoir "lire notre type". Comment faire cela ? Eh bien, nous devons indiquer dans la partie publique que nous disposons de types privés. Voici donc le code du package P_Pile tel qu'il doit être écrit (concentrez-vous sur la ligne 5) :
PACKAGE P_Pile IS
-- PARTIE PUBLIQUE
TYPE T_Pile IS PRIVATE ; --On indique qu'il y a un type T_Pile mais que celui-ci est privé
PROCEDURE Push (P : IN OUT T_Pile; N : IN Integer) ;
PROCEDURE Pop (P : IN OUT T_Pile ; N : OUT Integer) ;
FUNCTION Empty (P : IN T_Pile) RETURN Boolean ;
FUNCTION Length(P : T_Pile) RETURN Integer ;
FUNCTION First(P : T_Pile) RETURN Integer ;
PRIVATE
-- PARTE PRIVÉE
TYPE T_Cellule;
TYPE T_Pile IS ACCESS ALL T_Cellule; --on décrit ce qu'est le type T_Pile
TYPE T_Cellule IS
RECORD
Valeur : Integer;
Index : Integer;
Suivant : T_Pile;
END RECORD;
END P_Pile;
Et cette fois, c'est fini : votre type T_Pile est visible mais plus lisible, vous avez créé un véritable type privé et par la même occasion, votre première classe et vos premiers vrais objets !
Nous avons dit que le type T_Pile était privé et donc qu'il était visible mais non lisible. Par conséquent, il est impossible de connaître la structure d'une pile P et donc d'écrire :
En revanche, il est possible de déclarer des variables de type T_Pile, d'affecter une pile à une autre ou encore de tester l'égalité ou l'inégalité de deux piles :
-- TOUTES LES OPÉRATIONS CI-DESSOUS SONT THÉORIQUEMENT POSSIBLES
P1, P2, P3 : T_Pile --déclaration
BEGIN
...
P2 := P1 ; --affectation
if P2 = P1 and P3/=P1 --comparaison (égalité et inégalité seulement)
then ...
Mais à moins que vous ne les surchargiez, les opérateurs +, *, / ou - ne sont pas définis pour nos types T_Pile et ne sont donc pas utilisables, de même pour les test d'infériorité (< et <=) ou de supériorité (> et >=).
Restreindre encore notre type
Type limité et privé
Eh ! Mais si P1, P2 et P3 sont des piles, ce sont donc des pointeurs ! C'est pas un peu dangereux d'écrire P2 := P1 dans ce cas ?
Si, en effet. Vous avez bien retenu la leçon sur les pointeurs. :lol: Il est effectivement risqué de laisser à l'utilisateur la possibilité d'effectuer des comparaisons et surtout des affectations. Heureusement, le langage Ada a tout prévu ! Pour restreindre encore les possibilités, il est possible de créer un type non plus private, mais limited private (privé et limité) ! Et c'est extrêmement facile à réaliser puisqu'il suffit juste de modifier la ligne n°5 du fichier ads :
PACKAGE P_Pile IS
-- PARTIE PUBLIQUE
TYPE T_Pile IS LIMITED PRIVATE ; --Le type T_Pile est désormais privé ET limité ! ! !
PROCEDURE Push (P : IN OUT T_Pile; N : IN Integer) ;
PROCEDURE Pop (P : IN OUT T_Pile ; N : OUT Integer) ;
FUNCTION Empty (P : IN T_Pile) RETURN Boolean ;
FUNCTION Length(P : T_Pile) RETURN Integer ;
FUNCTION First(P : T_Pile) RETURN Integer ;
PRIVATE
-- PARTE PRIVÉE
TYPE T_Cellule;
TYPE T_Pile IS ACCESS ALL T_Cellule; --on décrit ce qu'est le type T_Pile
TYPE T_Cellule IS
RECORD
Valeur : Integer;
Index : Integer;
Suivant : T_Pile;
END RECORD;
END P_Pile;
Désormais, l'utilisateur ne pourra QUE déclarer ses piles ! Plus d'affectation ni de comparaison !
Mais ?!? o_O A quoi ça sert d'avoir un objet si on ne peut pas lui affecter de valeur ?
Pensez aux fichiers et au type File_Type. Aviez-vous besoin d'effectuer des affectations ou des comparaisons ? Non bien sûr. Cela n'aurait eu aucun sens ! Mais cela ne vous a pas empêché d'employer des objets de type File_Type et de leur appliquer diverses méthodes comme Put(), Get(), End_Of_Page() et tant d'autres. Le principe est exactement le même dans le cas présent : est-ce cohérent d'affecter UNE valeur à une pile ? Je ne crois pas. D'ailleurs, nous avons la primitive Push() pour ajouter une valeur à celles déjà existantes. En revanche, il pourrait être utile d'ajouter quelques méthodes à notre package P_Pile pour copier une pile dans une autre ou pour tester si les piles contiennent un ou des éléments identiques. Le but étant d'avoir un contrôle total sur les affectations et les tests : avec un type LIMITED PRIVATE, rien à part la déclaration ne peut se faire sans les outils du package associé.
Type seulement limité
Pour information, il est possible de déclarer un type qui soit seulement limited. Par exemple :
TYPE T_Vainqueur IS LIMITED RECORD
Nom : String(1..3) ;
Score : Natural := 0 ;
END RECORD ;
Ainsi, il sera impossible d'effectuer une affectation directe ou un test d'égalité (ou inégalité) :
En revanche, puisque le type T_Vainqueur n'est pas privé, sa structure est accessible et il demeure possible d'effectuer des tests ou des affectations sur ses attributs. Le code ci-dessous est donc correct :
Toi.nom := "JIM" ;
If Moi.score > Toi.score
then put("Je t'ai mis la misere ! ! ! " ;
end if ;
L'intérêt d'un type uniquement LIMITED est plus discutable et vous ne le verrez que très rarement. En revanche, les types LIMITED PRIVATE vont devenir de plus en plus courants, croyez-moi.
Sur le même principe, modifier votre package P_File afin que votre type T_File soit privé et limité.
Solution
PACKAGE P_Pile IS
TYPE T_Pile IS LIMITED PRIVATE ;
PROCEDURE Push (P : IN OUT T_Pile; N : IN Integer) ;
PROCEDURE Pop (P : IN OUT T_Pile ; N : OUT Integer) ;
FUNCTION Empty (P : IN T_Pile) RETURN Boolean ;
FUNCTION Length(P : T_Pile) RETURN Integer ;
FUNCTION First(P : T_Pile) RETURN Integer ;
PRIVATE
TYPE T_Cellule;
TYPE T_Pile IS ACCESS ALL T_Cellule;
TYPE T_Cellule IS
RECORD
Valeur : Integer;
Index : Integer;
Suivant : T_Pile;
END RECORD;
END P_Pile;
Exercice 2
Énoncé
Créer une classe T_Perso contenant le nom d'un personnage de RPG, ses points de vie et sa force. La classe sera accompagnée d'une méthode pour saisir un objet de type T_Perso et d'une seconde pour afficher ses caractéristiques.
Solution
package P_Perso is
type T_Perso is private ; --éventuellement limited private
procedure get(P : out T_Perso) ;
procedure put(P : in T_Perso) ;
private
type T_Perso is record
Nom : string(1..20) ;
PV : Natural := 0 ;
Force : Natural := 0 ;
end record ;
end P_Perso ;
with ada.text_io ; use ada.text_io ;
with ada.integer_text_io ; use ada.integer_text_io ;
package body P_Perso is
procedure get(P : out T_Perso) is
begin
put("Entrez un nom (moins de 20 lettres) : ") ; get(P.Nom) ; skip_line ;
put("Entrez ses points de vie : ") ; get(P.PV) ; skip_line ;
put("Entrez sa force : ") ; get(P.Force) ; skip_line ;
end get ;
procedure put(P : in T_Perso) is
begin
put_line(P.nom) ;
put_line(" VIE : " & integer'image(P.PV)) ;
put_line(" FORCE : " & integer'image(P.Force)) ;
end put ;
end P_Perso ;
Voilà qui est fait pour notre entrée en matière avec la POO. Rassurez-vous, ce chapitre n'était qu'une entrée en matière. Si l'intérêt de la POO vous semble encore obscur ou que certains points mériteraient des éclaircissement, je vous conseille de continuer la lecture des prochains chapitres durant lesquels nous allons préciser la notion d'objet et de classe. La prochaine étape est la généricité, notion déjà présente en Ada83 et dont je vous ai déjà vaguement parlé au cours des précédents chapitres.
Cela fait déjà plusieurs chapitres que ce terme revient : générique. Les packages Ada.Containers.Doubly_Linked_Lists ou Ada.Containers.Vectors étaient génériques. Mais bien avant cela, le package Ada.Numerics.Discrete_Random qui nous permettait de générer des nombres aléatoirement était générique ! Nous côtoyons cette notion depuis la partie II déjà sans avoir pris beaucoup de temps pour l'expliquer : c'est que cette notion est très présente en Ada. Et pour cause, la norme Ada83 permettait déjà la généricité. Il est donc temps de lever le voile avant de revenir à la programmation orientée objet et à l'héritage.
Avant de parler de packages génériques, il serait bon d'évoquer le problème qui a mené à cette notion de généricité. Vous avez du remarquer au cours de ce tutoriel que vous étiez souvent amenés à réécrire les mêmes bouts de code, les mêmes petites fonctions ou procédures qui servent sans arrêt. Par exemple, des procédures pour échanger les valeurs de deux variables, pour afficher le contenu d'un tableau, en extraire le plus petit élément ou encore en effectuer la somme ... bref, ce genre de sous-programme revient régulièrement et les packages ne suffisent pas à résoudre ce problème : notre bon vieux package P_Integer_Array ne résolvait certains de ces soucis que pour des tableaux contenant des Integer, mais pas pour des tableaux de float, de character, de types personnalisés ... De même, nous avons créé des packages P_Pile et P_File uniquement pour des Integer, et pour disposer d'une pile de Float, il faudrait jouer du copier-coller : c'est idiot !
D'où la nécessité de créer des programmes génériques, c'est à dire pouvant traiter "toute sorte" de types de données. A-t-on vraiment besoin de connaître le type de deux variables pour les intervertir ? Non bien sûr, tant qu'elles ont le même type ! L'idée est donc venue de proposer aux programmeurs la possibilité de ne rédiger un code qu'une seule fois pour ensuite le réemployer rapidement selon les types de données rencontrées.
Le langage Ada utilise le terme (suffisamment explicite je pense) de generic pour indiquer au compilateur quels sont les types ou variables génériques utilisés par les sous-programmes. D'autres langages parlent en revanche de modèle et utilisent le terme de template : on indique au compilateur que le sous-programme est un "cas-général", un "moule", une sorte de plan de montage pour sous-programme en kit ^^ . Même difficulté, même approche mais des termes radicalement différents.
Plan de bataille
Il est possible de créer des fonctions génériques, des procédures génériques ou encore des packages génériques : nous parlerons d'unités de programmes génériques. Ces unités de programmes ne seront génériques que parce qu'elles accepteront des paramètres eux-mêmes génériques. Ces paramètres sont en général des types, mais il est également possible d'avoir comme paramètre générique une variable ou une autre unité de programme! Ce dernier cas (plus complexe) sera vu à la fin de ce chapitre. Pour l'instant, nous allons retenir que pour réaliser une unité de programme générique il faut avant-tout déclarer le (ou les) type(s) générique(s) qui sera (seront) utilisé(s) par la suite. D'où un premier schéma de déclaration :
DÉCLARATION DU (OU DES) TYPE(S) GÉNÉRIQUE(S)
SPÉCIFICATION DE L’UNITÉ DE PROGRAMME GÉNÉRIQUE
CORPS DE L’UNITÉ DE PROGRAMME GÉNÉRIQUE
Ensuite, une unité de programme générique, seule, ne sert à rien. Il n'est pas possible de l'utiliser directement avec un type concret comme Integer ou Float. Vous devrez préalablement recréer une nouvelle unité de programme spécifique au type désiré. Rassurez-vous, cette étape se fera très rapidement : c'est ce que l'on appelle l'instanciation. D'où un plan de bataille modifié :
DÉCLARATION DU (OU DES) TYPE(S) GÉNÉRIQUE(S)
SPÉCIFICATION DE L’UNITÉ DE PROGRAMME GÉNÉRIQUE
CORPS DE L’UNITÉ DE PROGRAMME GÉNÉRIQUE
INSTANCIATION D'UNE UNITÉ DE PROGRAMME SPÉCIFIQUE
Un dernier point de vocabulaire
Bon ça y est, on commence ? :)
Pas encore, nous avons un petit point de théorie à éclaircir. Vous l'aurez compris, nous allons pouvoir définir des types génériques, seulement les types peuvent être classés en plusieurs catégories qu'il n'est pas toujours évident de distinguer : on dit qu'il existe plusieurs classes de types (tiens, encore ce mot "classe" ;) ).
Nous avons ainsi les types tableaux, les types flottants, les types entiers, les types pointeurs ... mais aussi les types discrets. De quoi s'agit-il ? Ce ne sont pas des types qui ne font pas de bruit ! :p Non, le terme discret est un terme mathématique signifiant que chaque élément (sauf cas extrêmes) a un prédécesseur et un successeur. Le type Natural par exemple est un type discret : si vous prenez un élément N au hasard parmi le type Natural (175 par exemple), vous pouvez lui trouver un successeur avec l'instruction Natural'succ(N) (=176) et un prédécesseur avec l'instruction Natural'pred(N) (=174). Et cela marchera pour tous les Natural hormis 0 qui n'a pas de prédécesseur et Natural'last qui n'a pas de successeur. Il en va de même pour les tous les types entiers comme Positive ou Integer, pour les types Character, Boolean ou même les types énumérés.
En revanche, le type Float n'est pas un type discret. Prenez un flottant X au hasard (175.0 par exemple). Quel est son successeur ? 176.0 ou 175.1 ? Et pourquoi pas 175.0002 ou 175.0000001 ? De même, les tableaux ou les pointeurs ne sont évidemment pas des types discrets.
Pourquoi vous parlez de cela ? Eh bien parce qu'avant de déclarer des types génériques, il est important de savoir à quelle classe de type il appartiendra : intervertir deux variables ne pose pas de soucis, mais effectuer une addition par 1 ne peut se faire qu'avec un type entier et pas flottant, connaître le successeur d'une variable ne peut se faire qu'avec des types discrets, connaître le nème élément ne peut se faire qu'avec un type tableau ... Bref, faire de la généricité, ce n'est pas faire n'importe quoi : il est important d'indiquer au compilateur quels types seront acceptables pour nos unités de programmes génériques.
Bon ! Il est temps désormais de voir un cas concret ! Nous allons créer une procédure qui échange deux éléments (nous l'appellerons Swap, c'est le terme Anglais pour Echanger). Voilà à quoi elle ressemblerait :
procedure swap(a,b : in out Positive) is
c : Positive ;
begin
c:=a ;
a:=b ;
b:=c ;
end swap ;
Mais elle est conçue pour échanger des Positive : pas des Natural ou des Integer, non ! Seulement des Positive ! Peut-être pourrions-nous élargir son champ d'action à tous les types entiers, au moins ?
Créer un type générique
Nous allons donc créer un type générique appelé T_Entier. Attention, ce type n'existera pas réellement, il ne servira qu'à la réalisation d'une procédure générique (et une seule). Pour cela nous allons devoir ouvrir un bloc generic dans la partie réservée aux déclarations :
generic
type T_Entier is range <> ;
Notez bien le range <> ! Le diamant (<>) est le symbole indiquant que les informations nécessaires ne seront transmises que plus tard. La combinaison de range et du diamant indique plus précisément que le type attendu est un type entier (Integer, Natural, Positive, Long_Long_integer ...) et pas flottant ou discret ou que-sais-je encore !
Notez également qu'il n'y a pas d'instruction endgeneric ! Pourquoi ? Tout simplement parce que ce type générique ne va servir qu'une seule fois et ce sera pour l'unité de programme que l'on va déclarer ensuite. Ainsi, c'est le terme function, procedure ou package qui jouera le rôle du endgeneric et mettra un terme aux déclarations génériques. Le type T_Entier doit donc être vue comme un paramètre de l'unité de programme générique.
Créer une procédure générique
Comme nous l'avions dit précédemment, la déclaration du type T_Entier doit être immédiatement suivie de la spécification de la procédure générique, ce qui nous donnera le code suivant :
generic
type T_Entier is range <> ;
procedure Generic_Swap(a,b : in out T_Entier) ;
Comme vous le constater, notre procédure utilise désormais le type T_Entier déclaré précédemment (d'où son nouveau nom Generic_Swap). Cette procédure prend en paramètres deux variables a et b indiquées entre parenthèses mais aussi un type T_Entier indiqué dans sa partie generic.
Ne reste plus désormais qu'à rédiger le corps de notre procédure un peu plus loin dans notre programme :
procedure Generic_Swap(a,b : in out T_Entier) is
c : T_Entier ;
begin
c:=a ;
a:=b ;
b:=c ;
end swap ;
Utiliser une méthode générique
Instanciation
Mais, j'essaye depuis tout à l'heure ce code, et il ne marche pas :
...
n : Integer := 3 ;
m : Integer := 4 ;
BEGIN
Generic_Swap(n,m) ;
...
C'est normal, votre procédure Generic_Swap() est faite pour un type générique seulement. Pas pour les Integer spécifiquement. Le travail que nous avons fait consistait simplement à rédiger une sorte de "plan de montage", mais nous n'avons pas encore réellement "monté notre meuble". En programmation, cette étape s'appelle l'instanciation : nous allons devoir créer une instance de Generic_Swap, c'est-à-dire une nouvelle procédure appelée Swap_Integer. Et cela se fait grâce à l'instruction new :
procedure swap_integer is new Generic_Swap(Integer) ;
Le schéma d'instanciation est relativement simple et sera systématiquement le-même pour toutes les unités de programmes :
procedure
Nom_Unite_Specifique
is new
Nom_Unite_Generique
(Types spécifiques)
function
package
Surcharge
Ainsi, le compilateur se chargera de générer lui-même le code de notre procédure swap_integer, vous laissant d'avantage de temps pour vous concentrer sur votre programme. Et puis, si vous aviez besoin de disposer de procédures swap_long_long_integer ou swap_positive_integer, il vous suffirait simplement d'écrire :
procedure swap_integer is new Generic_Swap(Integer) ;
procedure swap_long_long_integer is new Generic_Swap(long_long_integer) ;
procedure swap_positive is new Generic_Swap(Positive) ;
Hop ! Trois procédures générées en seulement trois lignes ! Pas mal non ? Et nous pourrions faire encore mieux, en générant trois instances de Generic_Swap portant toutes trois le même nom : swap ! Ainsi, en surchargeant la procédure, nous économisons de nombreux caractères à taper ainsi que la nécessité de systématiquement réfléchir aux types employés :
procedure swap is new Generic_Swap(Integer) ;
procedure swap is new Generic_Swap(long_long_integer) ;
procedure swap is new Generic_Swap(Positive) ;
Et désormais, nous pourrons effectuer des inversions à notre guise :
...
generic
type T_Entier is range <> ;
procedure Generic_Swap(a,b : in out T_Entier) ;
procedure Generic_Swap(a,b : in out T_Entier) is
c : T_Entier ;
begin
c:=a ;
a:=b ;
b:=c ;
end swap ;
procedure swap is new Generic_Swap(Integer) ;
n : integer := 3 ;
m : integer := 4 ;
BEGIN
swap(n,m) ;
...
Bien, vous connaissez désormais les rudiments de la généricité en Ada. Toutefois, notre déclaration du type T_Entier implique que vous ne pourrez pas utiliser cette procédure pour des character !
Et si je veux qu'elle fonctionne pour les character aussi, comment je fais ?
Eh bien il va falloir modifier notre classe de type générique :
Pour couvrir tous les types discrets (entiers mais aussi character, boolean ou énumérés), on utilisera le diamant seul :
type T_Discret is (<>) ;
Pour couvrir les types réels à virgule flottante (comme Float, Long_Float, Long_Long_Float ou des types flottants personnalisés), on utilisera la combinaison de digits et du diamant :
type T_Flottant is digits <> ;
Pour couvrir les types réels à virgule fixe (comme Duration, Time ou les types réels à virgule fixe personnalisés), on utilisera la combinaison de delta et du diamant, voire de delta, digits et du diamant (revoir le chapitre Variables III : Gestion des données si besoin) :
type T_Fixe is delta <> ; type T_Fixe is delta <> digits <> ;
Enfin, pour couvrir les types modulaires (revoir le chapitre Créer vos propres objets si besoin), on utilisera la combinaison de mod et du diamant :
type T_Modulaire is mod <> ;
Types génériques privés
Mais, on ne peut pas faire de procédure encore plus générique ? Comme une procédure qui manipulerait des types discrets mais aussi flottants ?
Si, c'est possible. Pour que votre type générique soit "le plus générique possible", il vous reste deux possibilités :
Si vous souhaitez que votre type bénéficie au moins de l'affectation et de la comparaison, il suffira de le déclarer ainsi :
type T_Generique is private ;
Et si vous souhaitez un type le plus générique possible, écrivez :
Pour déclarer un type tableau, nous avons toujours besoin de spécifier les indices : le tableau est-il indexé de 0 à 10, de 3 à 456, de 'a' à 'z', de JANVIER à FEVRIER ... ? Par conséquent, pour déclarer un tableau générique, il faut au minimum deux types génériques : le type (nécessairement discret) des indices et le type du tableau. Exemple :
generic
type T_Indice is (<>) ;
type T_Tableau is array(T_Indice) of Float ;
procedure Generic_Swap(T : in out T_Tableau ; i,j : T_Indice) ;
procedure Generic_Swap(T : in out T_Tableau ; i,j : T_Indice) is
tmp : Float ;
begin
tmp := T(i) ;
T(i) := T(j) ;
T(j) := tmp ;
end Generic_Swap ;
Notre procédure Generic_Swap dispose alors de deux paramètres formels (T_Indice et T_Tableau) qu'il faudra spécifier à l'instanciation dans l'ordre de leur déclaration :
...
subtype MesIndices is integer range 1..10 ;
type MesTableaux is array(MesIndices) of Float ;
procedure swap is new Generic_Swap(MesIndices,MesTableaux) ;
T : MesTableaux := (9.0, 8.1, 7.2, 6.3, 5.4, 4.5, 3.6, 2.7, 1.8, 0.9) ;
begin
swap(T,3,5) ;
...
Avec un tableau non contraint
Une première amélioration peut être apportée à ce code. Déclaré ainsi, notre type de tableaux est nécessairement contraint : tous les tableaux de type MesTableaux sont obligatoirement indexés de 1 à 10. Pour lever cette restriction, il faut tout d'abord modifier notre type formel :
generic
type T_Indice is (<>) ;
type T_Tableau is array(T_Indice range <>) of Float ;
--l'ajout de "range <>" nous laisse la liberté de contraindre nos tableaux plus tard
procedure Generic_Swap(T : in out T_Tableau ; i,j : T_Indice) ;
Puis nous pourrons modifier les types effectifs :
...
type MesTableaux is array(Integer range <>) of Float ;
--on réécrit "range <>" pour bénéficier d'un type non contraint !
procedure swap is new Generic_Swap(Integer,MesTableaux) ;
T : MesTableaux(1..6) := (7.2, 6.3, 5.4, 4.5, 3.6, 2.7) ;
--Cette fois, on contraint notre tableau en l'indexant de 1 à 6 ! Étape obligatoire !
begin
swap(T,3,5) ;
...
Un tableau entièrement générique
Seconde amélioration : au lieu de disposer d'un type T_Tableau contenant des Float, nous pourrions créer un type contenant toute sorte d'élément. Cela impliquera d'avoir un troisième paramètre formel : un type T_Element :
generic
type T_Indice is (<>) ;
type T_Element is private ;
--Nous aurons besoin de l'affectation pour la procédure Generic_Swap donc T_Element ne peut être limited
type T_Tableau is array(T_Indice range <>) of T_Element;
procedure Generic_Swap(T : in out T_Tableau ; i,j : T_Indice) ;
Je ne vous propose pas le code du corps de Generic_Swap, j'espère que vous serez capable de le modifier par vous-même (ce n'est pas bien compliqué). En revanche, l'instanciation devra à son tour être modifiée :
type MesTableaux is array(Integer range <>) of Float ;
--Jusque là pas de grosse différence
procedure swap is new Generic_Swap(Integer,Float,MesTableaux) ;
--Il faut indiquer le type des indices + le type des éléments + le type du tableau
L'inconvénient de cette écriture c'est qu'elle n'est pas claire : le type T_Tableau doit-il être écrit en premier, en deuxième ou en troisième ? Les éléments du tableau sont des Integer ou des Float ? Bref, on s'emmêle les pinceaux et il faut régulièrement regarder les spécifications de notre procédure générique pour s'y retrouver. On préfèrera donc l'écriture :
procedure swap is new Generic_Swap(T_Indice => Integer,
T_Element => Float,
T_Tableau => MesTableaux) ;
--RAPPEL : L'ordre n'a alors plus d'importance ! ! !
--CONSEIL : Indentez correctement votre code pour plus de lisibilité
Pointeurs génériques
De la même manière, il est possible de créer des types pointeurs génériques. Et comme pour déclarer un type pointeur, il faut absolument connaître le type pointé, cela impliquera d'avoir deux paramètres formels. Exemple :
generic
type T_Element is private ;
type T_Pointeur is access T_Element ;
procedure Access_Swap(P,Q : in out T_Pointeur) ;
D'où l'instanciation suivante :
type MesPointeursPersos is access character ;
procedure swap is new Access_Swap(character,MesPointeursPersos) ;
-- OU MIEUX :
procedure swap is new Access_Swap(T_Pointeur => MesPointeursPersos,
T_Element => Character) ;
Paramètre de type programme : le cas d'un paramètre limited private
Bon, j'ai compris pour les différents types tableaux, pointeurs etc ... Mais quel intérêt de créer un type limited private ET generic ? On ne pourra rien faire ! Ça ne sert à rien pour notre procédure d'échange ! o_O
En effet, nous sommes face à un problème : les types limited private ne nous autorisent pas les affectations or nous aurions bien besoin d'un sous-programme pour effectuer cette affectation. Prenons un exemple : nous allons réaliser un package appelé P_Point qui saisit, lit, affiche ... des points et leurs coordonnées. Voici quelle pourrait être sa spécification :
package P_Point is
type T_Point is limited private ;
procedure set_x(P : out T_Point ; x : in float) ;
procedure set_y(P : out T_Point ; y : in float) ;
function get_x(P : in T_Point) return float ;
function get_y(P : in T_Point) return float ;
procedure put(P : in T_Point) ;
procedure copy(From : in T_Point ; To : out T_Point) ;
private
type T_Point is record
x,y : Float ;
end record ;
end P_Point ;
Ce type T_Point est bien limited private mais son package nous fournit une procédure pour réaliser une copie d'un point dans un autre. Reprenons désormais notre procédure générique :
generic
type T_Element is limited private ;
with procedure copier_A_vers_B(a : in T_Element ; b : out T_Element) ;
procedure Generic_Swap(a,b : in out T_Element) ;
Nous ajoutons un nouveau paramètre formel : une procédure appelée copier_A_vers_B et qu'il faudra préciser à l'instanciation. Mais revenons avant cela au code source de la procédure Generic_Swap. Si elle ne peut pas utiliser le symbole d'affectation :=, elle pourra toutefois utiliser cette nouvelle procédure générique copier_A_vers_B :
procedure Generic_Swap(a,b : in out T_Element) is
c : T_Element ;
begin
copier_A_vers_B(b,c) ;
copier_A_vers_B(a,b) ;
copier_A_vers_B(c,a) ;
end generic_swap ;
A l'instanciation, vous devrez donc préciser le nom de la procédure qui effectuera cette copie de A vers B :
procedure swap is new generic_swap(T_Point,copy) ;
-- OU BIEN
procedure swap is new generic_swap(T_Element => T_Point,
Copier_A_vers_B => copy) ;
Une dernière remarque : si vous ne souhaitez pas être obligé de spécifier le nom de la procédure de copie à l'instanciation, il suffit de modifier la ligne :
with procedure copier_A_vers_B(a : in T_Element ; b : out T_Element) ;
en y ajoutant un diamant (mais n'oubliez pas de modifier le code source de Generic_Swap en conséquence) :
with procedure copy(a : in T_Element ; b : out T_Element) is <> ;
Vous avez dors et déjà appris l'essentiel de ce qu'il y a à savoir sur la généricité en Ada. Mais pour plus de clarté, nous n'avons utilisé qu'une procédure générique. Or, la plupart du temps, vous ne créerez pas un seul programme générique, mais bien plusieurs, de manière à offrir toute une palette d'outil allant de paire avec l'objet générique que vous proposerez. Prenez l'exemple de nos packages P_Pile et P_File (encore et toujours eux) : quel intérêt y a-t-il à ne proposer qu'une seule procédure générique alors que vous disposez de plusieurs primitives ? Dans 95% des cas, vous devrez donc créer un package générique.
Pour illustrer cette dernière (et courte) partie, et en guise d'exercice final, vous allez donc modifier le package P_Pile pour qu'il soit non seulement limité privé, mais également générique ! Ce n'est pas bien compliqué : retenez le schéma que je vous avais donné en début de chapitre :
DÉCLARATION DU (OU DES) TYPE(S) GÉNÉRIQUE(S)
SPÉCIFICATION DE L’UNITÉ DE PROGRAMME GÉNÉRIQUE
CORPS DE L’UNITÉ DE PROGRAMME GÉNÉRIQUE
INSTANCIATION D'UNE UNITÉ DE PROGRAMME SPÉCIFIQUE
La différence, c'est que le tout se fait dans des fichiers séparés :
DÉCLARATION DU (OU DES) TYPE(S) GÉNÉRIQUE(S)
SPÉCIFICATION DU PACKAGE GÉNÉRIQUE
CORPS DU PACKAGE GÉNÉRIQUE
INSTANCIATION D'UN PACKAGE SPÉCIFIQUE
La structure de votre fichier ads va donc devoir encore évoluer :
SCHÉMA INITIAL
SCHÉMA ACTUEL
NOUVEAU SCHEMA
Package P_Pile is
Vos fonctions, procédures, types, variables ...
end P_Pile ;
Package P_Pile is
Vos fonctions, procédures, types, variables ... publics
private
Vos fonctions, procédures, types, variables ... privés
end P_Pile ;
Generic
Vos paramètres formels : variables, types, programmes ...
Package P_Pile is
Vos fonctions, procédures, types, variables ... publics
private
Vos fonctions, procédures, types, variables ... privés
end P_Pile ;
Vous êtes prêts pour le grand plongeon ? Alors allez-y ! ^^
Solution
GENERIC
TYPE T_Element IS PRIVATE ;
PACKAGE P_Pile IS
TYPE T_Pile IS LIMITED PRIVATE ;
PROCEDURE Push (P : IN OUT T_Pile; N : IN T_Element ) ;
PROCEDURE Pop (P : IN OUT T_Pile ; N : OUT T_Element ) ;
FUNCTION Empty (P : IN T_Pile) RETURN Boolean ;
FUNCTION Length(P : T_Pile) RETURN Integer ;
FUNCTION First(P : T_Pile) RETURN T_Element ;
PRIVATE
TYPE T_Cellule;
TYPE T_Pile IS ACCESS ALL T_Cellule;
TYPE T_Cellule IS
RECORD
Valeur : T_Element ; --On crée une pile générique
Index : Integer;
Suivant : T_Pile;
END RECORD;
END P_Pile;
PACKAGE BODY P_Pile IS
PROCEDURE Push (
P : IN OUT T_Pile;
N : IN T_Element ) IS
Cell : T_Cellule;
BEGIN
Cell.Valeur := N ;
IF P /= NULL
THEN
Cell.Index := P.All.Index + 1 ;
Cell.Suivant := P.All'ACCESS ;
ELSE
Cell.Index := 1 ;
END IF ;
P := NEW T_Cellule'(Cell) ;
END Push ;
PROCEDURE Pop (
P : IN OUT T_Pile;
N : OUT T_Element ) IS
BEGIN
N := P.All.Valeur ; --ou P.valeur
--P.all est censé exister, ce sera au programmeur final de le vérifier
IF P.All.Suivant /= NULL
THEN
P := P.Suivant ;
ELSE
P := NULL ;
END IF ;
END Pop ;
FUNCTION Empty (
P : IN T_Pile)
RETURN Boolean IS
BEGIN
IF P=NULL
THEN
RETURN True ;
ELSE
RETURN False ;
END IF ;
END Empty ;
FUNCTION Length(P : T_Pile) RETURN Integer IS
BEGIN
IF P = NULL
THEN RETURN 0 ;
ELSE RETURN P.Index ;
END IF ;
END Length ;
FUNCTION First(P : T_Pile) RETURN T_Element IS
BEGIN
RETURN P.Valeur ;
END First ;
END P_Pile;
Application
Vous pouvez désormais créer des piles de Float, de tableaux, de boolean ... il vous suffira juste d'instancier votre package :
With P_Pile ; --Pas de clause Use, cela n'aurait aucun sens car P_Pile est générique
procedure MonProgramme is
package P_Pile_Character is new P_Pile(Character) ;
use P_Pile_Character ;
P : T_Pile ;
begin
push(P,'Z') ;
push(P,'#') ;
...
end MonProgramme ;
With P_Pile ;
procedure MonProgramme is
package P_Pile_Character is new P_Pile(Character) ;
use P_Pile_Character ;
package P_Pile_Float is new P_Pile(Float) ;
use P_Pile_Float ;
P : T_Pile ; --Est-ce une pile de Float ou une pile de Character ?
begin
...
end MonProgramme ;
Privilégiez alors l'écriture pointée afin de préciser l'origine de vos objets et méthodes :
P : P_Pile_Float.T_Pile ; --Plus de confusion possible
Comme vous avez pu le constater, la généricité est une notion compliquée mais puissante. Elle vous permettra d'élaborer des outils complexes (comme les piles ou les files) disponibles pour toute une panoplie de type. Elle nécessite en revanche que vous réfléchissiez aux classes de types qui pourraient être employées. Ne vous avais-je pas dit que le langage Ada avait un fort typage ?
Après un chapitre sur la généricité plutôt (voire carrément) théorique, nous enchaînons avec un second tout aussi compliqué, mais ô combien important. Je dirais même que c'est le chapitre phare de cette partie IV : l'héritage. Et pour cause, l'héritage est, avec l'encapsulation, la propriété fondamentale de la programmation orientée objet.
Nous allons, tout au long de ce chapitre, prendre un exemple pour illustrer ce concept compliqué : imaginez que nous souhaitions créer un jeu de stratégie médiéval. Votre mission (si vous l'acceptez :soleil: ) : créer des objets pour modéliser les différentes unités du jeu : chevalier, archer, arbalétrier, catapulte, voleur, écuyer ... ainsi que leurs méthodes associées : attaque frontale, défense, tir, bombardement, attaque de flanc ...
Eh bien c'est quand papy décède et que les enfants et petits-enfants se partagent le pactole ! :p
Mouais, :( j'espérais un peu plus de sérieux. Mais vous n'êtes pas si loin de la définition d'héritage en programmation. Non, nos programmes ne vont pas décéder mais ils vont transmettre leurs biens. En effet, dire qu'un objet B hérite d'un objet A, cela revient à dire que B bénéficiera de tous les attributs de A : types, fonctions, procédures, variables ... et ce, sans avoir besoin de tout redéfinir.
On dit alors que A est l'objet père et B l'objet fils. On parle alors d'héritage Père-Fils (ou mère-fille, c'est selon les accords). De même, si un objet C hérite de B, alors il bénéficiera des attributs de B, mais aussi de A par héritage. On dira que C est le fils de B et le petit-fils de A.
Un dernier exemple : si un deuxième objet D hérite de A, on dira que D et B sont deux objets frères. Ils bénéficient chacun des attributs du père A, mais B ne peut pas bénéficier des attributs de son frère D et réciproquement : il n'y a pas d'héritage entre frères en programmation. Comment cela vous êtes perdus ? :p Allez, pour ceux qui ont toujours été nuls en généalogie, voici un petit schéma :
Chaque flèche signifie "hérite de".
Héritage : une approche par l'exemple
Pour mieux comprendre l'utilité de l'héritage (et avant de découvrir son fonctionnement en Ada), revenons à l'exemple donné en introduction. Nous souhaiterions créer un type d'objet pour représenter des unités militaires pour un jeu de stratégie. Quelles sont les attributs et fonctionnalités de base d'une unité militaire ? Elle doit disposer d'un potentiel d'attaque, de défense et de mouvement. Elle doit également pouvoir attaquer, se défendre et se déplacer.
Toutefois, certaines unités ont des "pouvoirs spéciaux" afin de rendre le jeu plus attrayant : certaines sont montées à cheval pour prendre l'ennemi de vitesse et l'attaquer par le côté ; d'autres ont la capacité d'attaquer à distance à l'aide d'arcs, d'arbalètes ou d'engin de siège ; et dans le cas des engins de siège, les unités qui en sont dotées ont alors en plus la possibilité de bombarder l'ennemi pour l'affaiblir avant l'assaut. Résumons par un petit schéma :
Les unités d'artillerie bénéficient des capacités des unités archères, qui elles-mêmes disposent des capacités des Unités classiques(mais l'inverse n'est pas vrai). De même, les unités montéesdisposent des capacités des unités classiquesmais pas de celles des unités archères. On dit alors que tous ces types d'unités font partie de la classe de typesUnité. Les types Archer et Artillerie font partie de la sous-classe fille Archers, mais pas de la sous-classe sœur Unités montées.
Mais plutôt que ce lourd tableau, nous modéliserons cette situation à l'aide d'un diagramme de classe UML comme nous l'avons fait précédemment avec nos objets A, B, C et D :
Bien ! Maintenant que les idées sont fixées, voyons comment réaliser ce fameux héritage en Ada.
Supposons que nous disposions d'un package P_Unit contenant le type T_Unit et ses méthodes :
package P_Unit is
type T_Unit is record
Att, Def, Mov, Vie : Integer := 0 ;
end record ;
procedure Attaque(Attaquant, Defenseur : in out T_Unit) ;
procedure Defense(Defenseur : in out T_Unit) ;
procedure Deplacer(Unite : in out T_Unit) ;
function Est_Mort(Unite : in T_Unit) return Boolean ;
end P_Unit ;
Le corps des méthodes sera minimal, pour les besoins du cours :
With ada.text_IO ; Use Ada.Text_IO ;
package body P_Unit is
procedure Attaque(Attaquant, Defenseur : in out T_Unit) is
begin
Put_line(" >> Attaque frontale !") ;
Defenseur.vie := integer'max(0,Defenseur.vie - Attaquant.att) ;
end Attaque ;
procedure Defense(Defenseur : in out T_Unit) is
begin
put_line(" >> Votre unite se defend.") ;
Defenseur.def := integer(float(Defenseur.def) * 1.25) ;
end Defense ;
procedure Deplacer(Unite : in out T_Unit) is
begin
Put_line(" >> Votre unite se deplace") ;
end Deplacer ;
function Est_Mort(Unite : in T_Unit) return Bo

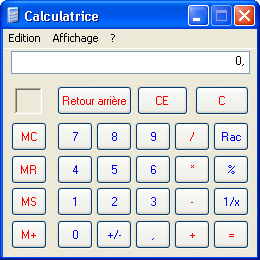
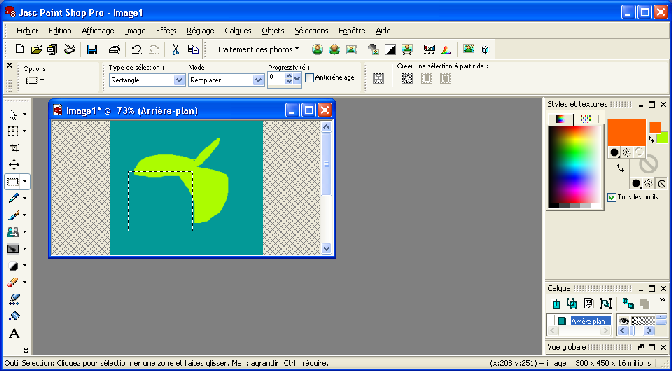
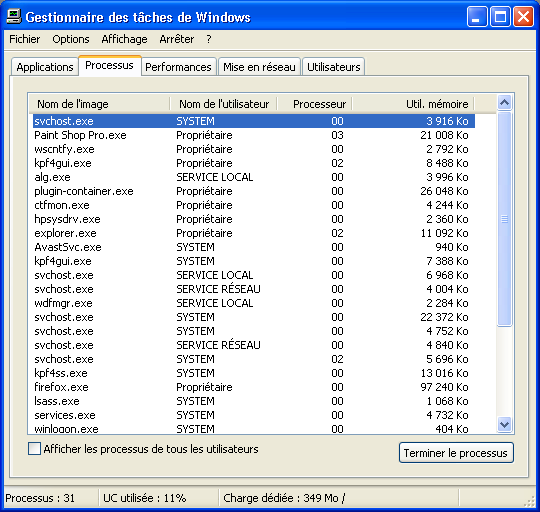
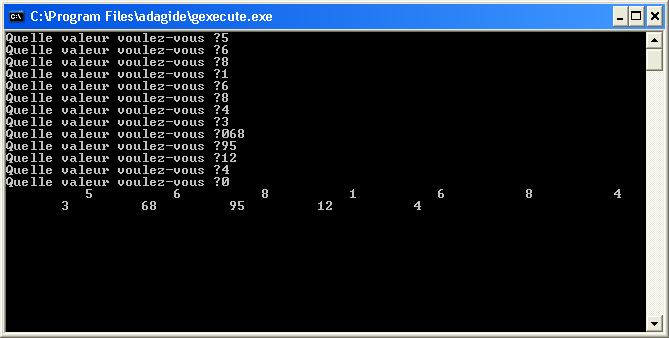
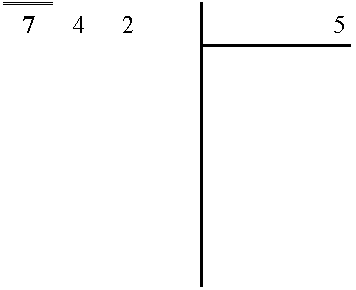
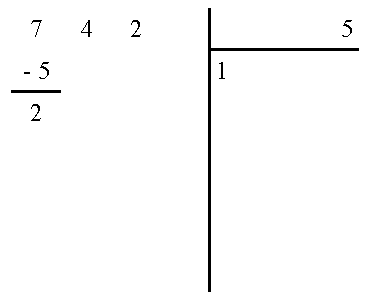

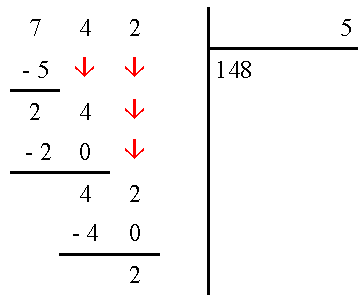
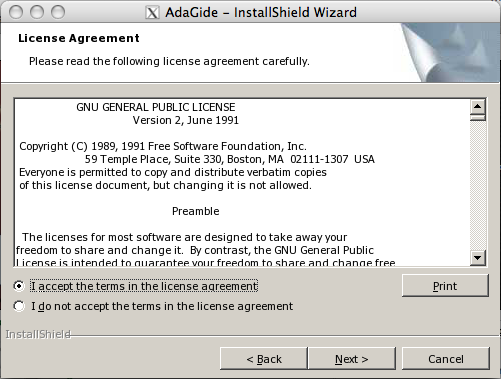
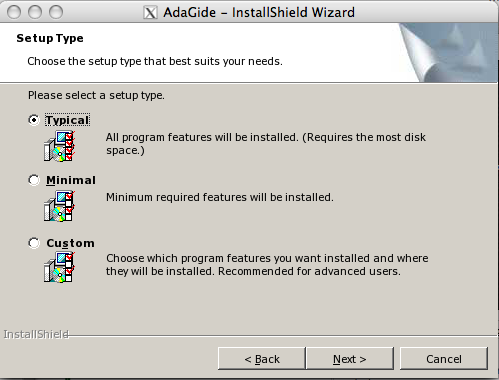
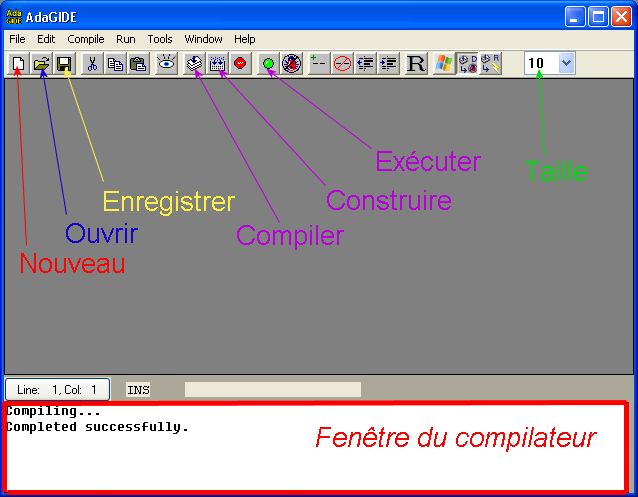
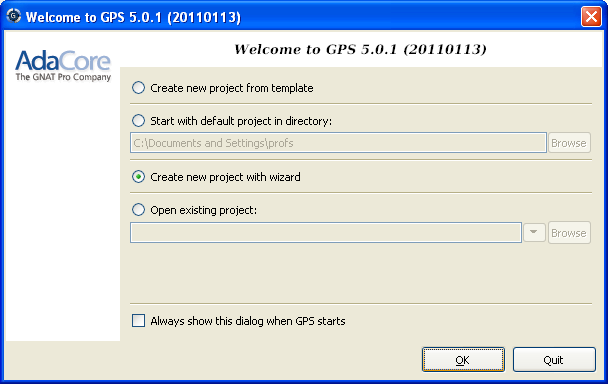
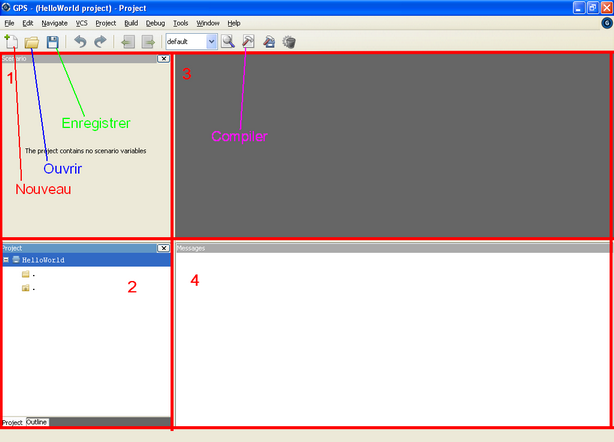
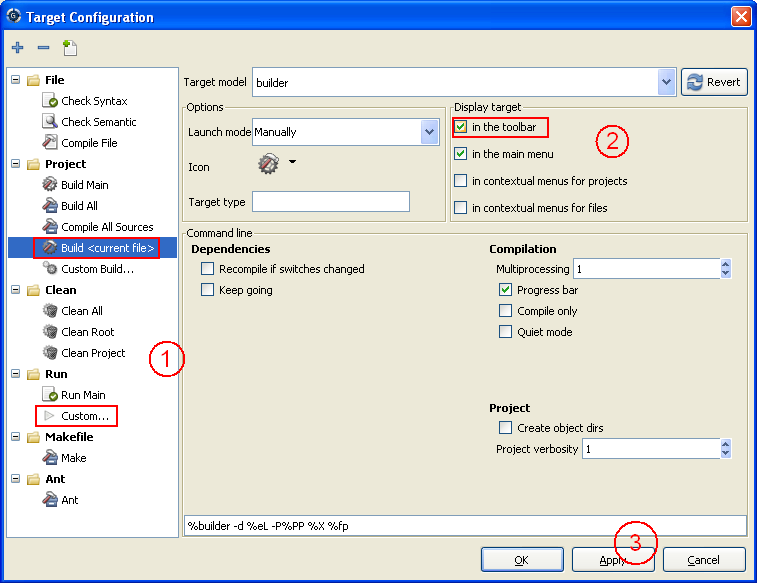


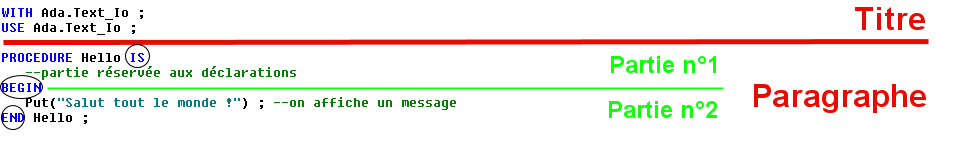
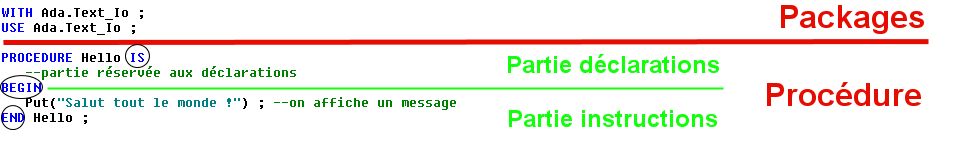
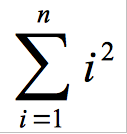
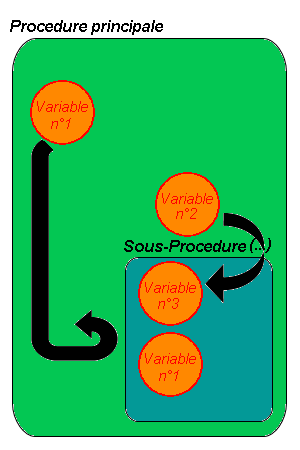
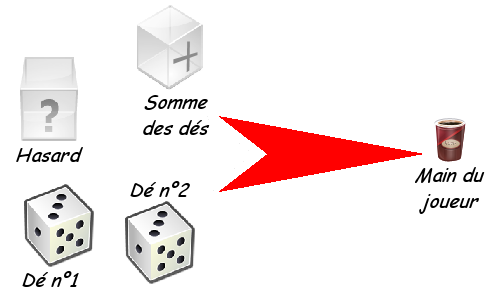
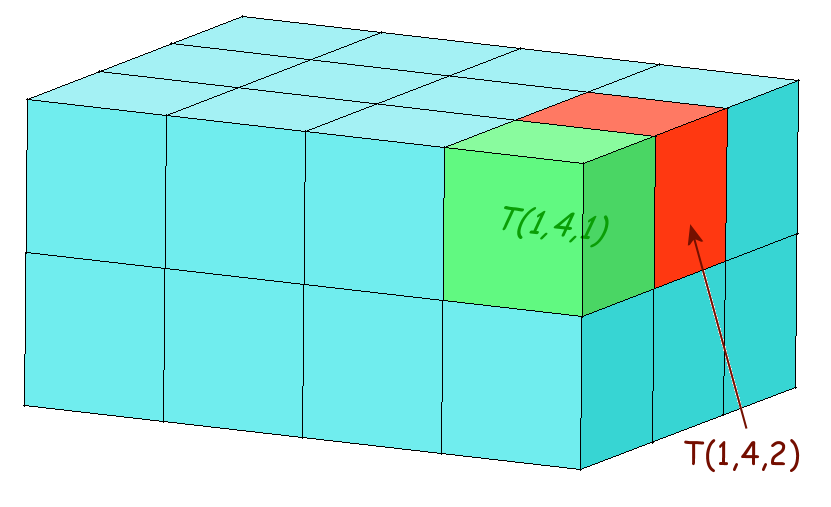
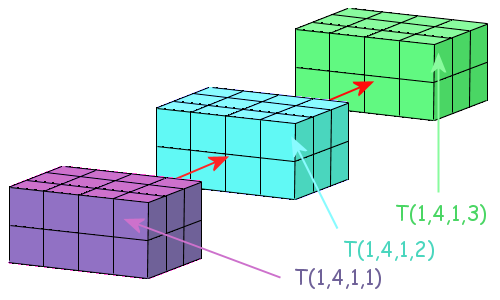
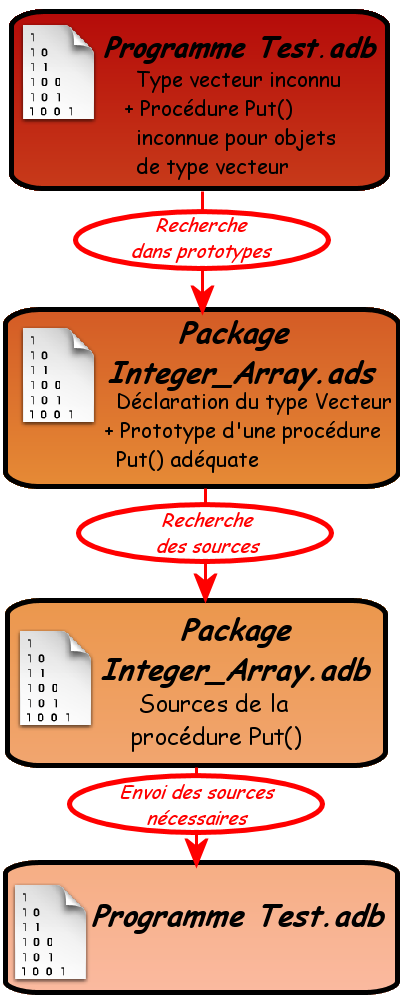

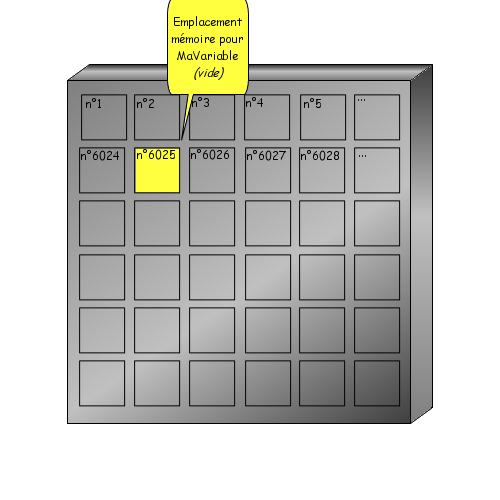
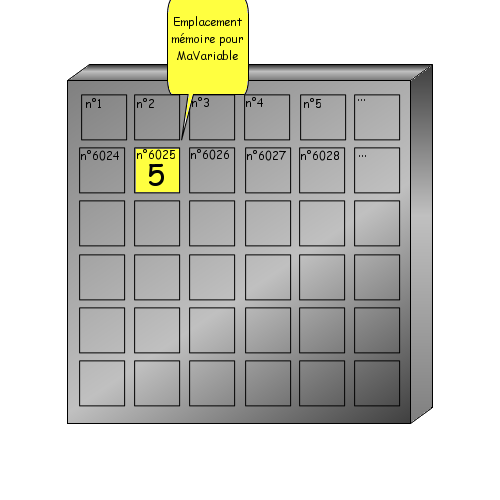
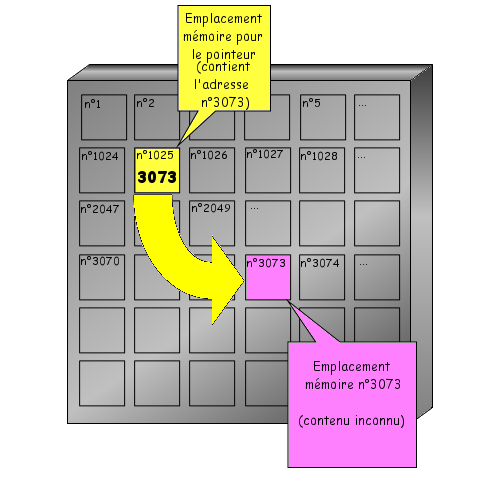
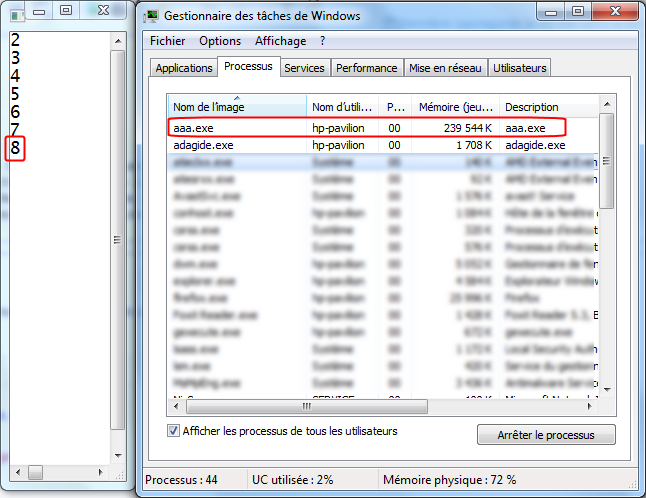




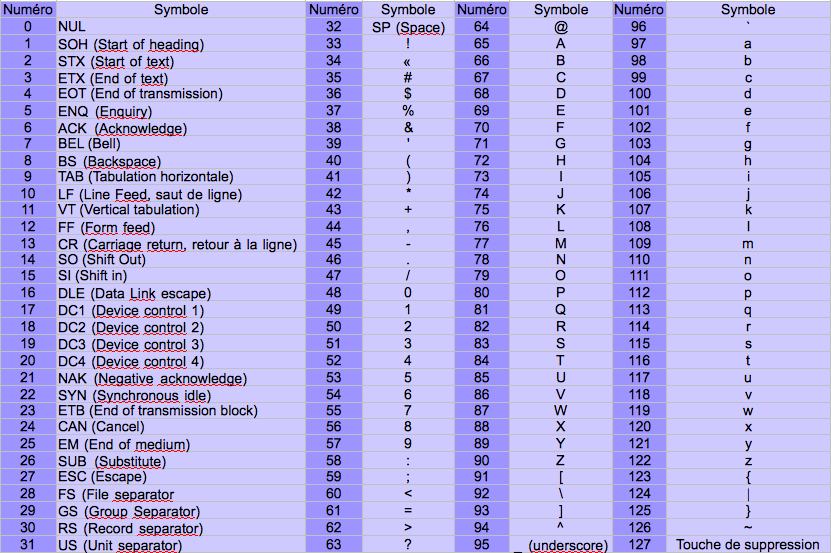
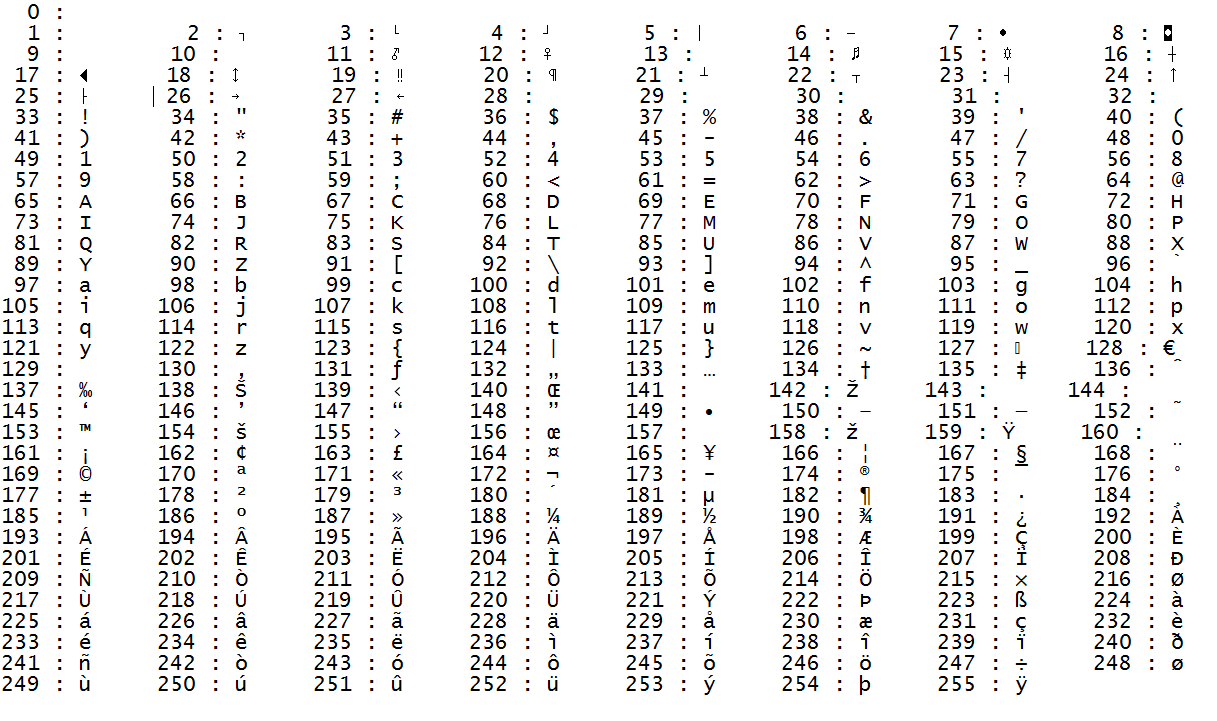 Caractères en Ada